


除了Python,其他语言能开发人工智能吗?对比Python的不可替代性
深入分析C++、Rust、Java、Julia及JavaScript在人工智能开发中的定位与实际应用,对比Python在算法生态中的核心优势与不可替代性,帮助开发者看清AI工程的技术分工与选型路径。
除了Python,C++、Rust、Java、Julia、C#以及JavaScript完全可以开发人工智能,并且在生产工程、硬件加速和边缘部署等关键链条中扮演着不可替代的角色。但“能开发”并不等于“能颠覆Python的统治地位”。在实际的AI研发分工中,Python主导了最前端的算法探索、模型架构搭建与学术成果转化,而底层执行效率与生产吞吐则主要由C++、CUDA和Rust承担。理解这种分工差异,是看清AI工程全貌与理性选择技术栈的关键前提。
一、AI技术栈分工:Python是胶水,底层是系统语言
很多初学者容易误以为“现代AI系统是用纯Python写出来的”。事实上,Python本身的解释执行性能和全局解释器锁(GIL)决定了它无法胜任密集的张量数学运算与GPU并行指令分发。主流框架(例如PyTorch、TensorFlow)的核心执行引擎90%以上是由C++和CUDA编写的,Python在其中本质上是一层设计精巧的“胶水控制台”。
工程师用Python调用 torch.matmul() 时,底层真正被唤醒的是高度优化的C++底层算子(如cuBLAS、cuDNN或OneAPI核心库)。Python通过轻量级的语言绑定接口(如pybind11、CFFI),既保留了高级动态语言极简的编写体验,又规避了自身的运行时性能短板。
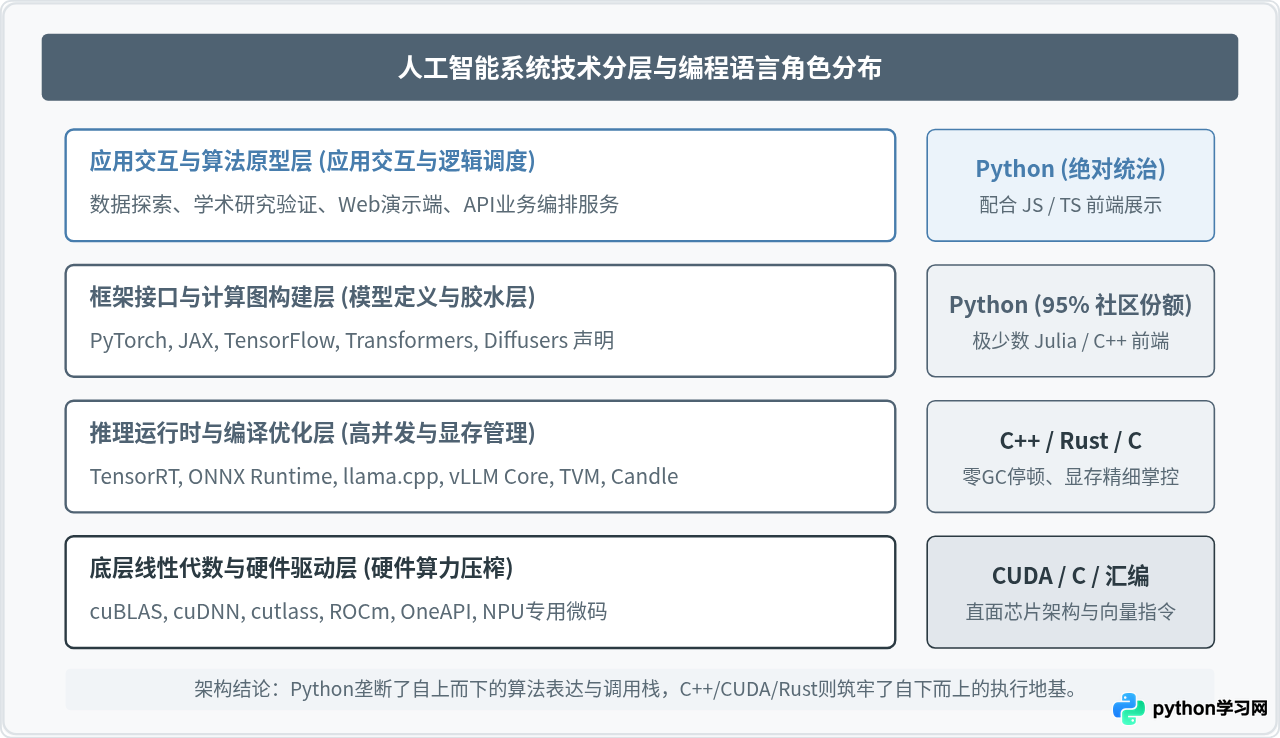
二、除了Python,其他语言都在做什么?
脱离具体工程场景谈语言好坏往往失去实际意义。不同编程语言在AI生命周期中各自占据了明确的地盘:
1. C与C++:高吞吐推理与端侧计算的基石
在工程生产环境,推理延迟和并发吞吐直接决定服务器成本。当模型在实验室用Python训练完毕后,工程团队通常将其导出为标准中间格式(如ONNX),并交由C++推理引擎运行。
- llama.cpp:纯C/C++实现的大语言模型推理框架,无需任何Python依赖,能在普通个人电脑、树莓派乃至苹果M系列芯片上实现极致的高速纯CPU/GPU推理。
- TensorRT与OpenVINO:英伟达与英特尔官方的硬件加速SDK均以C++作为原生接口,通过算子融合、半精度(FP16/INT8)量化将模型吞吐压榨至极限。
2. Rust:内存安全与高性能并发的新一代力量
Rust具备与C++相当的原生运行速度,同时依靠所有权系统在编译期杜绝了空指针与数据竞争。Hugging Face推出的现代机器学习运行时 Candle 即完全采用Rust开发。在需要高可靠、高并发、长时间无缝运行的AI微服务网关中,Rust正在迅速取代部分传统的C++与Go编写的服务组件。
3. Java与C#:企业级微服务与大数据系统的黏合剂
银行、电信等传统大型企业拥有成熟的JVM或.NET业务后台,不可能为了引入AI模块把整个系统重构为Python。微软提供了深度整合的 ML.NET 和 ONNX Runtime C# API;而在大数据生态中,Apache Spark MLlib正是基于Java/Scala运行,用于在数千台集群节点上执行分布式特征工程与算法预测。
4. Julia:直击“双语言困境”的现代科学计算语言
Julia专为数值分析与科学计算而生。其核心亮点是“像Python一样好写,同时像C语言一样快”,解决了先用Python写原型再用C++重写核心代码的“双语言难题”。框架如 Flux.jl 表现出色,但由于周边工程工具链的社区沉淀远落后于Python,目前主要活跃于学术前沿、气候仿真与运筹优化领域。
5. JavaScript / TypeScript:终端与轻量交互的先锋
随着WebGPU标准的推行,直接在用户浏览器本地运行AI模型已成为现实。Transformers.js 和 TensorFlow.js 允许在无服务器算力介入的情况下,在客户端完成文本情感分类、端侧目标检测及轻量语音转写,完全免除了后端GPU的高昂成本与隐私泄露隐患。
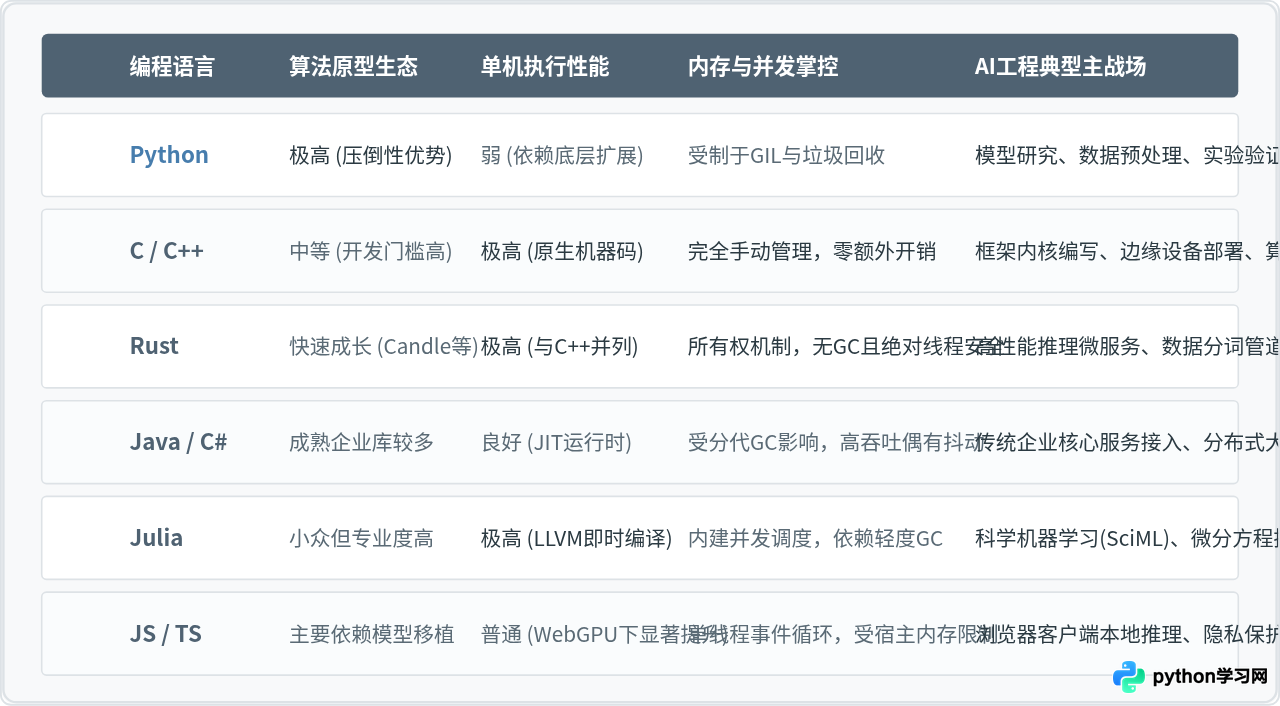
三、为什么Python在算法研究层具备不可替代性?
虽然其他语言能在生产环境大放异彩,但在算法研发、学术探索以及模型预训练阶段,Python的统治地位在可预见的未来依然稳如磐石。这种不可替代性并非源于编程语言语法本身有多精妙,而是由以下四种强大的现实因素共同构筑的:
1. 沉淀深厚的科学计算与矩阵生态
Python在AI领域的爆发并非偶然,而是长达二十余年科学计算积淀的顺水推舟。在深度学习诞生之前,以 NumPy、SciPy、Pandas 为核心的数值计算标准已经成为全球科研界的通用语言。现今所有深度学习框架的张量(Tensor)接口,几乎都在语法习惯上高度拟合了 NumPy 的多维切片与广播机制。换用其他语言意味着科研人员需要重新学习一套非标准的操作范式,迁移成本极高。
2. 顶尖开源社区与论文复现的“重力效应”
在人工智能领域,学术成果转化为代码的速度决定了技术迭代的上限。当前全球顶会(如CVPR、NeurIPS、ICLR)上的新算法和最新开源模型(如Meta Llama系列、Mistral、Stable Diffusion),其官方开源代码与论文复现库99%以上基于PyTorch与Python发布。在Hugging Face模型社区中,所有主流权重转换、Tokenizer调用和示例脚本均以Python为第一公民。一旦脱离Python,开发者将无法在第一时间调用这些前沿成果,直接在技术竞争中掉队。
3. 极低的心智负担与直观的原型验证
算法工程师的核心任务是数学推导、损失函数调整、模型拓扑构建与超参数探索,而不是排查内存泄漏、处理悬垂指针或编写繁冗的模板元编程。Python简洁的动态语法允许研究者用十几行代码完整定义一个神经网络层,在Jupyter Notebook中边写、边算、边看绘图结果。这种即时反馈的交互式编程体验,是编译型语言难以匹敌的。
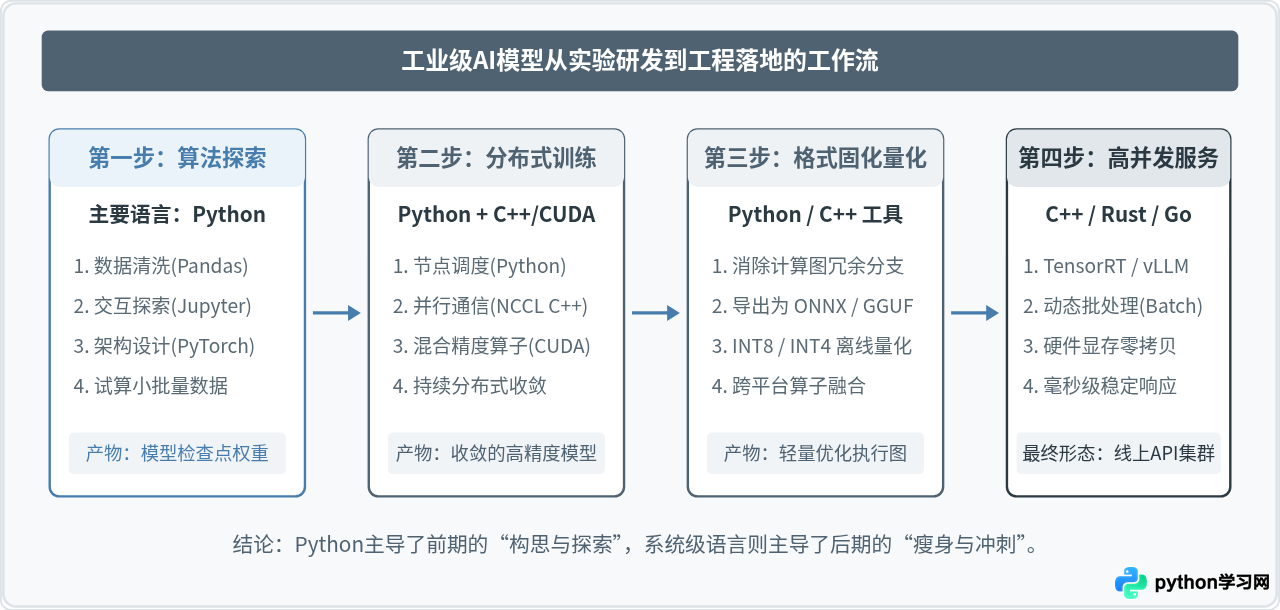
四、从算法到上线:完整的跨语言协作全流程
了解语言之间的协作关系,可以清晰地参考一个典型企业级AI产品的研发流转过程:
五、开发者如何根据场景做出技术选型?
面对多元的技术栈,开发者不应陷入“非此即彼”的语言之争,而应根据自己的具体工程目标做出合理选择:
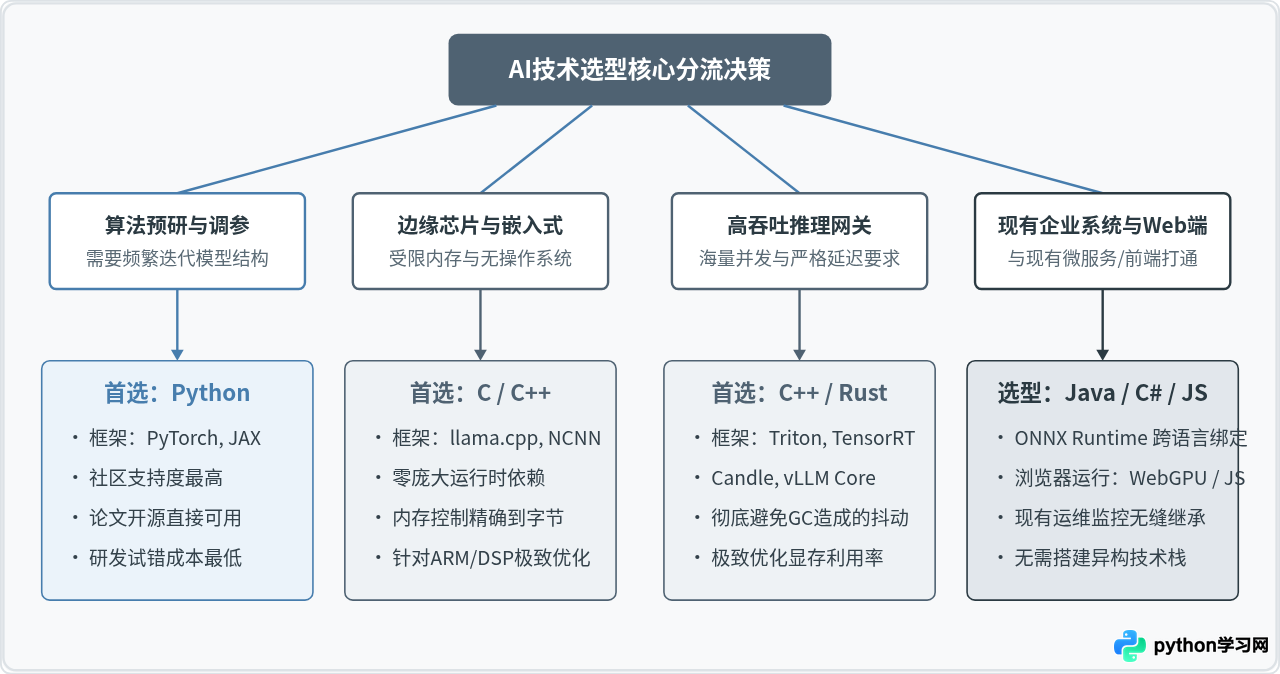
六、实践中的两点重要澄清
澄清以下两个常见认知误区,能帮助技术团队少走弯路:
- 误区一:“学AI只要精通Python就足够了”
如果目标只是算法调参或写Demo脚本,Python确实足够;但若想成为具备全面落地能力的AI系统工程师,必须深入理解C/C++的内存模型、编译优化以及CUDA编程,否则当遇到模型显存爆满、吞吐瓶颈或需手写定制算子时将难以推进。 - 误区二:“Python运行速度慢,因此不适合做大规模工业AI”
这种观点混淆了“控制层”与“计算层”。在典型的大规模深度学习训练和推理中,99%以上的计算耗时都在GPU核心算子中流转,Python本身的指令调度开销占比往往不足1%。只要调度流水线设计合理,Python不会成为计算性能的瓶颈。
七、总结
回答标题的核心问题:其他语言不仅能开发人工智能,而且构成了AI基础设施的承重墙。
然而,Python的不可替代性体现在其无可比拟的学术生态集中度、科学计算API标准以及高效率的原型验证能力。现代人工智能工业界早已不是某种单一语言的独奏,而是以“Python定模型、C++/CUDA算张量、Rust/C++做服务、Java/JS做连接”的立体协作体系。认清这套分工逻辑,根据自身所处的业务环节选择最匹配的工具,才是AI开发中最务实的策略。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















