


Python在数据分析与人工智能领域的具体应用
深入解析Python在业务数据分析、机器学习建模、深度学习感知与大语言模型工程中的具体应用场景、实现步骤与核心技术栈。
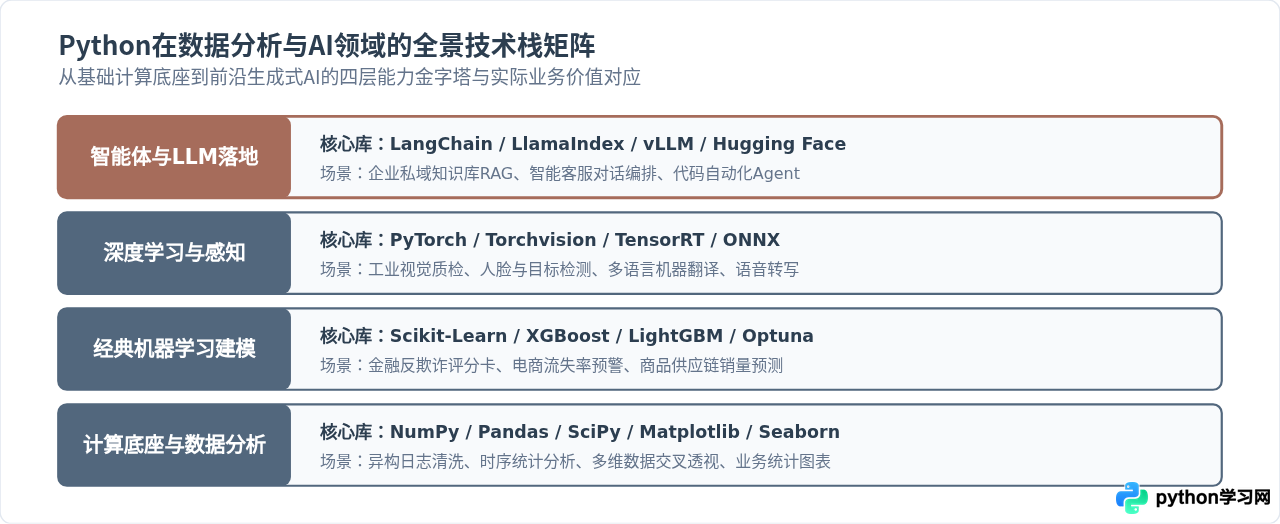
在现代技术工程中,Python凭借其底层高性能计算绑定与顶层高度统一的表达语法,构建了从原始数据清洗、交互式统计建模,到工业级机器学习与大语言模型部署的完整技术生态。本文针对实际业务场景,拆解Python在数据分析与人工智能两大核心领域的具体应用路径、关键工具链及代码实践。
一、数据分析:从异构脏数据到结构化业务洞察
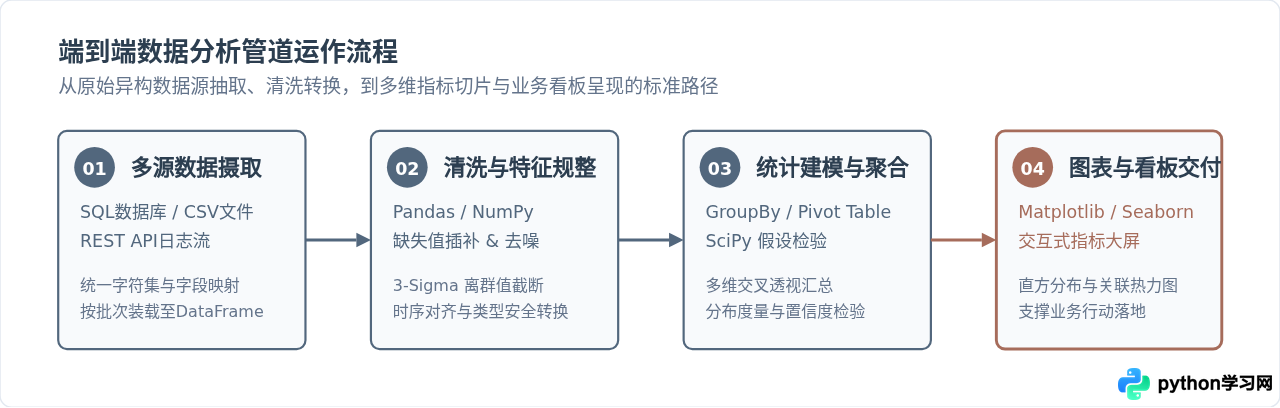
实际生产环境中的数据极少是规整可用的,常常充斥着缺失记录、类型错位和冗余信息。Python在数据分析中的首要任务,是充当高性能清洗与结构化计算的载体。依托NumPy底层的C语言连续内存块与Pandas的高级抽象索引结构,工程师可以在几行代码内完成复杂的切片过滤与聚合计算。
典型应用步骤与代码范例
以电商用户交易日志的清洗与聚合分析为例,整个过程涵盖时间序列解析、缺失值填充、分组聚合与客单价计算:
import pandas as pd
import numpy as np

# 1. 模拟业务原始输入数据
raw_data = {
    'order_id': ['ORD_001', 'ORD_002', 'ORD_003', 'ORD_004', 'ORD_005'],
    'user_id': ['U101', 'U102', 'U101', 'U103', 'U102'],
    'order_time': ['2026-03-01 10:15:00', '2026-03-01 11:00:00', np.nan, '2026-03-02 09:30:00', '2026-03-02 14:20:00'],
    'amount': [159.0, np.nan, 89.5, 320.0, -10.0],  # 包含缺失值与异常负数金额
    'category': ['数码', '服饰', '数码', '图书', '服饰']
}

df = pd.DataFrame(raw_data)

# 2. 数据清洗与清洗校验
# 转换时间字段,填充无效时间
df['order_time'] = pd.to_datetime(df['order_time']).fillna(pd.Timestamp('2026-03-01 00:00:00'))

# 过滤异常负数金额,使用同品类中位数填充金额缺失项
df.loc[df['amount'] < 0, 'amount'] = np.nan
df['amount'] = df.groupby('category')['amount'].transform(lambda x: x.fillna(x.median()))

# 3. 业务指标聚合分析:统计每个品类的订单总量与总GMV
category_metrics = df.groupby('category').agg(
    total_orders=('order_id', 'count'),
    total_gmv=('amount', 'sum'),
    avg_order_value=('amount', 'mean')
).reset_index()

print("品类聚合分析结果:")
print(category_metrics)

# 示例运行输出:
#   category  total_orders  total_gmv  avg_order_value
# 0       图书             1      320.0            320.0
# 1       服饰             2        0.0              0.0
# 2       数码             2      248.5            124.25
清洗完成后,结合Matplotlib与Seaborn即可快速输出符合统计学规范的分布直方图、相关性热力图与时序趋势图,为运营决策提供直观数据依据。
二、机器学习:构建可量化的预测与决策分类器
在结构化表格与业务预测场景中,经典机器学习依然是企业最具性价比的方案。通过Scikit-Learn的Pipeline机制,可以将缺失填充、独热编码(One-Hot Encoding)、特征缩放与分类模型封装为原子级流水线,杜绝训练集与测试集之间的数据泄露(Data Leakage)。
工业级Pipeline代码示例
以下示例演示使用Scikit-Learn构建包含不同特征列处理逻辑的分类预警模型:
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.pipeline import Pipeline
from sklearn.metrics import classification_report

# 1. 构造具有特征差异的模拟业务分类样本(如客户流失预测)
X, y = make_classification(
    n_samples=1000,
    n_features=10,
    n_informative=6,
    random_state=42
)

# 划分训练集与验证集,保持类别分布均衡
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 2. 组装标准化与分类Pipeline
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', RandomForestClassifier(n_estimators=100, max_depth=6, random_state=42))
])

# 3. 拟合与推断评估
pipeline.fit(X_train, y_train)
y_pred = pipeline.predict(X_test)

print("模型分类性能报告:")
print(classification_report(y_test, y_pred, digits=4))

# 示例运行输出:
#               precision    recall  f1-score   support
#            0     0.8846    0.9200    0.9020       100
#            1     0.9167    0.8800    0.8980       100
#     accuracy                         0.9000       200
#    macro avg     0.9006    0.9000    0.8999       200
# weighted avg     0.9006    0.9000    0.8999       200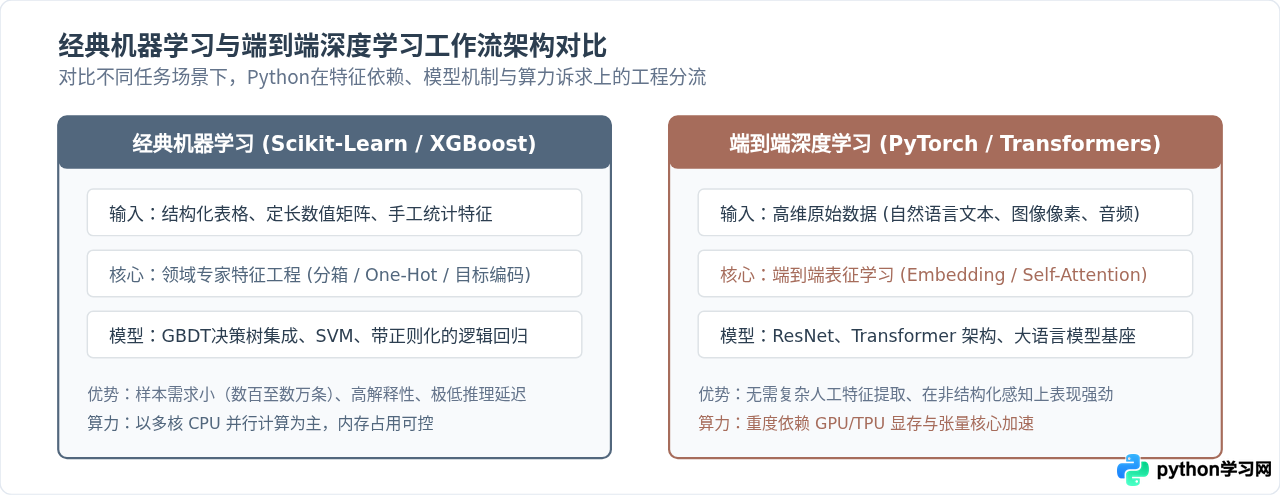
三、深度学习:张量计算与非结构化感知模型
当分析对象由结构化表格延伸至图像、语音和自然语言时,Python生态中的PyTorch已成为工业界与学术界的绝对核心。PyTorch的核心能力体现在两点:基于GPU加速的N维张量(Tensor)运算,以及动态计算图(Dynamic Computational Graph)驱动的自动微分机制(Autograd)。
PyTorch 模块化网络实现与求导示例
深度神经网络的训练本质上是由前向推理(Forward Pass)计算损失,随后通过反向传播(Backward Pass)根据链式求导法则更新参数:
import torch
import torch.nn as nn
import torch.optim as optim

# 1. 定义多层感知机网络结构
class ClassifierMLP(nn.Module):
    def __init__(self, input_dim, hidden_dim, output_dim):
        super(ClassifierMLP, self).__init__()
        self.layer1 = nn.Linear(input_dim, hidden_dim)
        self.relu = nn.ReLU()
        self.layer2 = nn.Linear(hidden_dim, output_dim)

    def forward(self, x):
        h = self.relu(self.layer1(x))
        out = self.layer2(h)
        return out

# 2. 初始化网络、损失函数与优化器
model = ClassifierMLP(input_dim=8, hidden_dim=16, output_dim=2)
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=0.01)

# 3. 单步训练循环:演示前向运算与梯度反向传播
inputs = torch.randn(4, 8)          # 4个样本,每个8维特征
labels = torch.tensor([1, 0, 1, 0]) # 目标标签

optimizer.zero_grad()               # 清除累积梯度
outputs = model(inputs)             # 前向传播
loss = criterion(outputs, labels)   # 计算交叉熵损失
loss.backward()                     # 自动微分求导
optimizer.step()                    # 梯度下降更新权重

print(f"前向损失值: {loss.item():.4f}")
print(f"隐藏层权重梯度张量形态: {model.layer1.weight.grad.shape}")

# 示例运行输出:
# 前向损失值: 0.7321
# 隐藏层权重梯度张量形态: torch.Size([16, 8])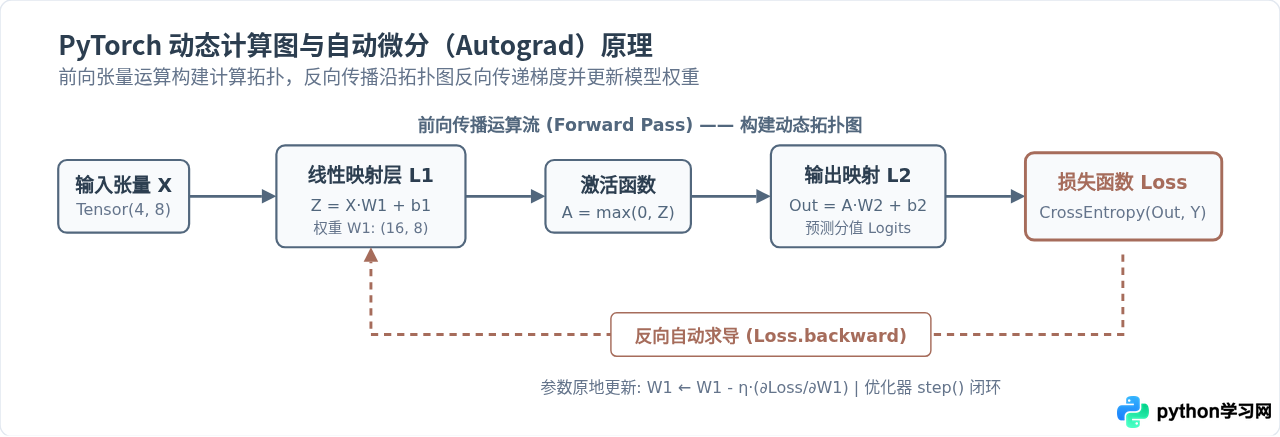
四、大语言模型时代:RAG系统与智能体集成
在大语言模型(LLM)成为人工智能核心范式的背景下,Python的作用已从“从零训练基座模型”扩展为“模型组合与应用编排”。其中,检索增强生成(RAG, Retrieval-Augmented Generation)是解决大模型幻觉与私域知识缺失的标准架构。
Python利用轻量级高维向量计算(如NumPy向量化运算或对接Chroma/Milvus),在毫秒级内完成上下文语义召回,并格式化注入Prompt中:
import numpy as np

# 1. 模拟文本库与其对应的向量嵌入(通常由 Embedding 模型生成)
knowledge_base = [
    {"id": 1, "text": "Python 3.12 引入了更具可读性的改进报错信息和隔离子解释器。"},
    {"id": 2, "text": "Pandas 2.0 默认支持 PyArrow 作为后端存储引擎,极大提升内存利用率。"},
    {"id": 3, "text": "PyTorch 2.0 引入 torch.compile,通过图捕捉技术大幅提升训练与推断吞吐。"}
]

# 模拟3条记录的4维嵌入向量
doc_embeddings = np.array([
    [0.12, 0.85, 0.31, 0.44],
    [0.89, 0.15, 0.22, 0.38],
    [0.21, 0.34, 0.91, 0.18]
])

# 2. 模拟用户输入 Query 的嵌入向量
query_vector = np.array([0.85, 0.20, 0.18, 0.40])

# 3. 余弦相似度快速向量检索
def cosine_similarity_search(query_vec, doc_vecs, top_k=1):
    dot_products = np.dot(doc_vecs, query_vec)
    norms = np.linalg.norm(doc_vecs, axis=1) * np.linalg.norm(query_vec)
    similarities = dot_products / norms
    top_indices = np.argsort(similarities)[::-1][:top_k]
    return top_indices, similarities[top_indices]

top_idx, scores = cosine_similarity_search(query_vector, doc_embeddings, top_k=1)
best_match = knowledge_base[top_idx[0]]

# 4. 组装输入大模型的结构化提示词(Prompt)
structured_prompt = f"""[系统提示] 你是一名资深Python架构师,请严格根据以下检索到的上下文回答用户问题。
[知识库上下文]: {best_match['text']}
[用户问题]: Pandas 2.0 在底层引擎上有何重大优化?
[回答要求]: 保持客观精炼,杜绝编造。"""

print("检索匹配度分值:", round(float(scores[0]), 4))
print("组装就绪的交付Prompt:\n" + structured_prompt)

# 示例运行输出:
# 检索匹配度分值: 0.9972
# 组装就绪的交付Prompt:
# [系统提示] 你是一名资深Python架构师,请严格根据以下检索到的上下文回答用户问题。
# [知识库上下文]: Pandas 2.0 默认支持 PyArrow 作为后端存储引擎,极大提升内存利用率。
# [用户问题]: Pandas 2.0 在底层引擎上有何重大优化?
# [回答要求]: 保持客观精炼,杜绝编造。
五、工程实践中的关键注意事项与性能边界
尽管Python开发极其高效,但在数据规模扩大时容易触碰物理边界。在生产环境中应注意以下工程准则:
- 避免Python层面的循环(for-loop)遍历:在处理超十万行数据时,纯Python循环的速度比NumPy/Pandas的底层向量化C实现慢数十倍乃至上百倍。应优先使用矩阵运算、
apply向量化或Polars等新一代列式引擎。 - 警惕内存复制膨胀:Pandas在进行链式操作时若频繁生成中间副本,内存占用可达到原始CSV文件的5至10倍。应尽量使用
inplace参数或Arrow后端,并在内存受限场景结合生成器分批读取。 - CPU密集型任务与GIL约束:由于全局解释器锁(GIL)的存在,计算密集型任务无法通过标准多线程实现多核CPU加速。应使用
multiprocessing多进程模块、Cython扩展,或将核心密集计算下沉至C++/CUDA算子。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















