Python代码覆盖率统计工具coverage.py用法详解
本文详细介绍Python代码覆盖率统计工具coverage.py的安装配置、命令行操作及API调用方法。涵盖coverage run执行脚本、coverage report查看结果、coverage html生成报告等核心命令,并解析Stmts、Miss、Branch等关键指标含义,帮助开发者有效评估测试覆盖情况。



本文详细介绍Python代码覆盖率统计工具coverage.py的安装配置、命令行操作及API调用方法。涵盖coverage run执行脚本、coverage report查看结果、coverage html生成报告等核心命令,并解析Stmts、Miss、Branch等关键指标含义,帮助开发者有效评估测试覆盖情况。
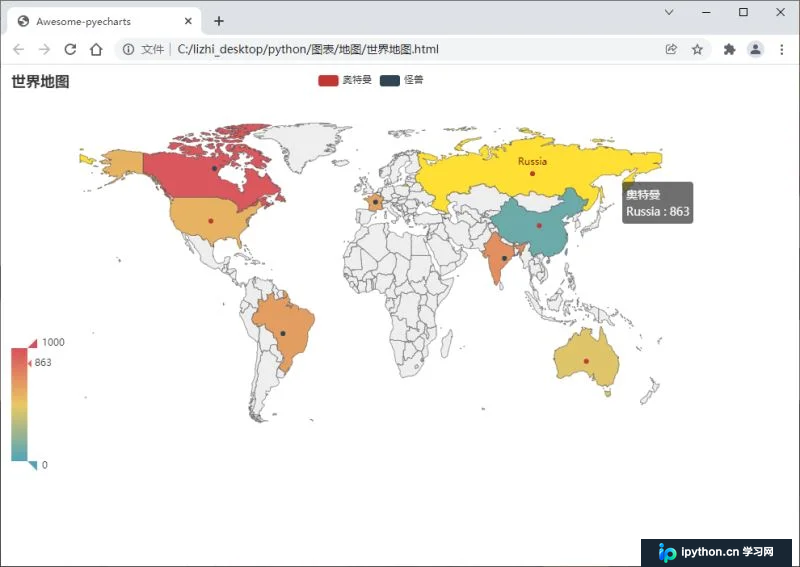
本文详细讲解如何使用Python库pyecharts绘制世界地图、省级地图及城市地图。通过准备数据并调用Map类,分别以河北和承德为例演示代码实现。运行脚本生成HTML文件即可在浏览器中查看交互式地图效果,包含数据填充与可视化配置的全过程。
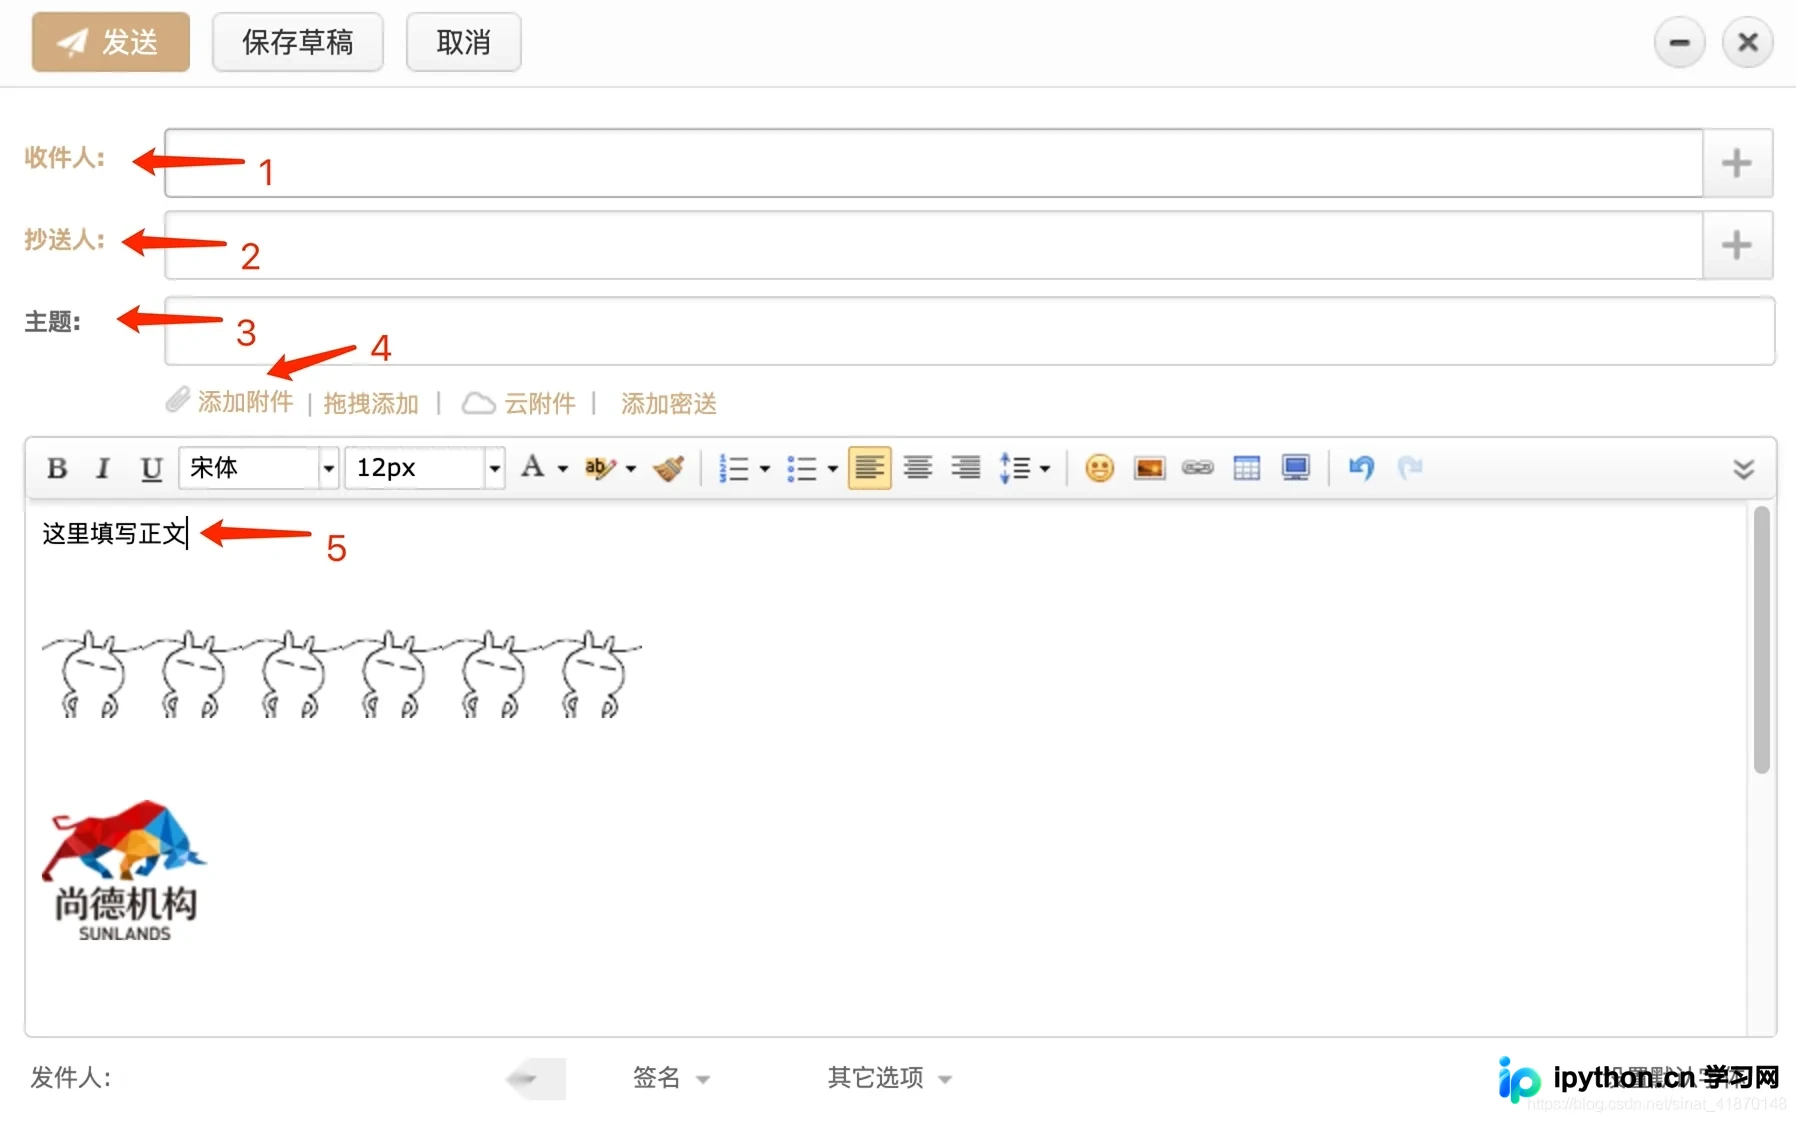
本文介绍如何利用Python的zmail库实现自动化邮件发送。内容涵盖基础单发、多收件人、抄送、附件处理及HTML格式化正文。通过具体代码示例,展示如何配置SMTP服务器、处理授权码以及调用外部API生成动态内容,帮助开发者快速构建邮件通知系统。
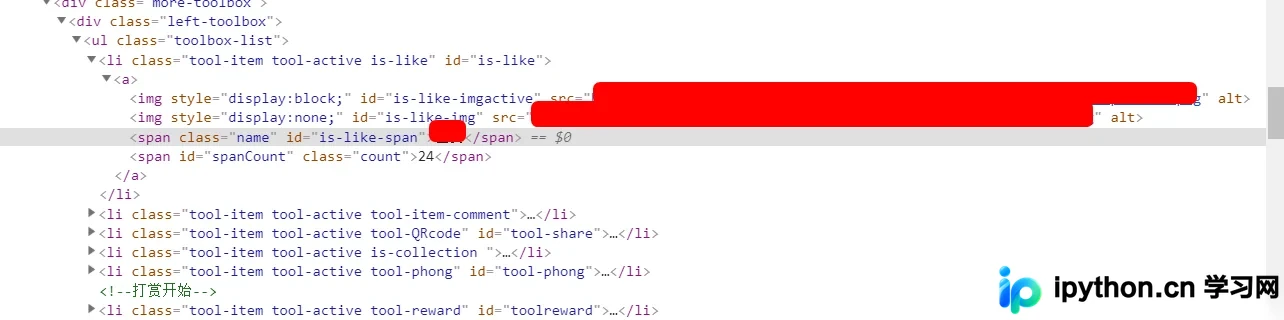
本文介绍如何在Python中使用BeautifulSoup库,通过指定标签名和ID属性来精准定位HTML页面中的特定元素。以span标签下id为is-like-span为例,展示find方法的用法,并说明如何调用get_text()提取其中的字符串内容,帮助开发者快速掌握DOM元素获取技巧。
本文介绍两种在Python中快速建立Web或RPC服务的方法。首先演示使用SimpleXMLRPCServer实现简单的远程过程调用,通过注册函数提供文件读取服务。其次展示基于Socket模块的手动实现HTTP服务器,解析请求并返回HTML内容。适用于需要轻量级服务或理解底层网络通信原理的场景。
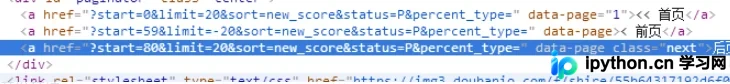
本文详细介绍使用Python抓取豆瓣影评数据的两种方法。首先通过PC端网页分析URL参数,利用Requests和BeautifulSoup解析HTML并递归获取评论;随后介绍更高效的移动端模拟策略,通过修改User-Agent直接调用豆瓣移动端API接口获取JSON数据,简化解析流程并提高抓取效率。
本文介绍如何使用Python脚本解决B站收藏夹视频顺序混乱问题。通过调用B站API获取视频ID,利用正则表达式解析网页HTML获取发布时间,并将时间与视频ID绑定后按时间排序。脚本包含防封禁机制和断点续传功能,帮助用户将收藏夹按视频发布先后顺序重新整理。
本文介绍如何利用Python Flask框架实现网页中按钮点击后跳转至自定义页面的功能。通过配置Flask路由、编写HTML模板及处理GET/POST请求,演示了从首页链接到表单页的完整流程。代码示例展示了@app.route装饰器的使用及render_template函数的调用,适用于希望掌握Flask基础页面交互的开发者参考。