


Python 3数据分析入门:环境搭建与Pandas基础教程
系统讲解 Python 3 数据分析基础环境搭建与 Pandas 核心操作。涵盖 Python 虚拟环境配置、Series 与 DataFrame 结构剖析、数据读入初探、缺失值清洗、条件切片及 GroupBy 分组聚合实战与避坑指南。
完成 Python 3 数据分析任务的核心路径非常明确:首先建立与系统环境完全隔离的虚拟运行环境,保障依赖解析可控;随后掌握 Pandas 两个核心数据载体(Series 与 DataFrame)的内存形态与双轴概念,进而熟练执行数据读取、质量清洗、条件切片与分组聚合。本文将按照实际开发流程逐项展开完整实操与关键细节。
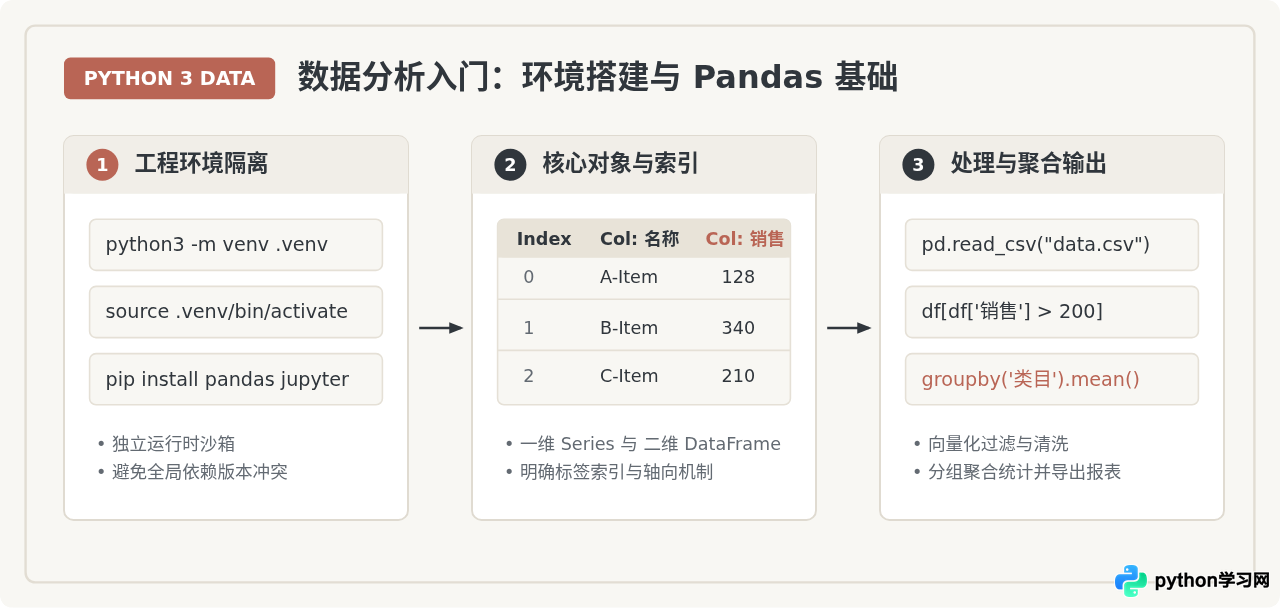
一、构建独立可靠的数据分析运行环境
在开始编写任何数据清洗代码前,必须优先确立一个完全隔离的 Python 3 运行时。很多初学者习惯直接在系统全局 Python 中执行 pip install pandas,这极易引发系统内置工具依赖断裂、权限报错或不同项目间的底层 C 扩展版本冲突。
Python 3 原生内置了 venv 模块,无需额外安装重量级管理工具即可轻松构建沙箱环境。进入终端,按以下规范步骤依序执行:
1. 验证基础解释器并初始化工作目录
建议使用 Python 3.9 及以上版本。在终端中检查版本并创建项目专有工作空间:
# 1. 验证系统 Python 3 版本
python3 --version

# 2. 创建并进入数据分析专有工作目录
mkdir pydata_lab
cd pydata_lab

# 3. 创建名为 .venv 的虚拟环境目录
python3 -m venv .venv2. 激活虚拟环境并安装核心分析依赖
创建完成后,激活该环境以确保当前会话的 python 与 pip 路径指向专有沙箱内部,接着升级包管理工具并安装 Pandas 与 Excel 解析引擎:
# macOS / Linux 激活方式:
source .venv/bin/activate

# Windows PowerShell 激活方式为:
# .venv\Scripts\Activate.ps1

# 升级 pip 并安装数据分析核心包
pip install --upgrade pip
pip install pandas openpyxl jupyterlab3. 执行就绪状态验证
依赖安装完成后,直接在命令行中调用单行测试,确认 Pandas 模块能否正常导入并输出版本号:
python -c "import pandas as pd; print('Pandas Ready. Version:', pd.__version__)"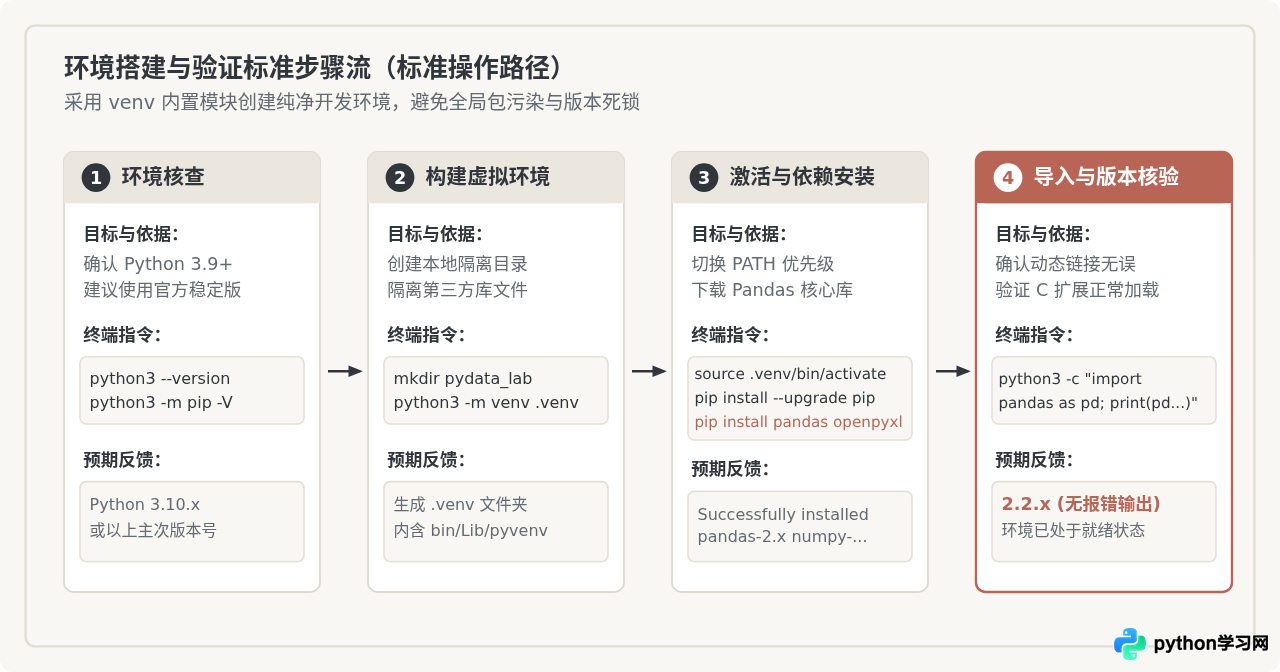
jupyter lab,它会自动绑定当前沙箱中的内核。切勿在全局环境下启动 Jupyter 去尝试读取未注册的虚拟环境内核。
二、深入剖析 Pandas 核心数据结构与双轴模型
理解 Pandas 的第一步是放弃将它仅仅看作“Python 版 Excel”的表象认知,而是要在内存模型上明确两个核心载体:Series 与 DataFrame。
1. Series:一维带标签同构数组
Series 是带显式索引的一维数组,其底层建立在连续内存块(NumPy ndarray)之上。与 Python 原生列表最大的不同在于,Series 具备命名的 index,可以通过标签实现高速对齐与检索:
import pandas as pd

# 创建带自定义字符串索引的 Series
scores = pd.Series([92.5, 88.0, 76.5, 95.0], index=['A', 'B', 'C', 'D'], name='得分')
print(scores)
print("索引元数据:", scores.index)
print("数据类型:", scores.dtype)2. DataFrame:二维异构表格与轴向(axis)法则
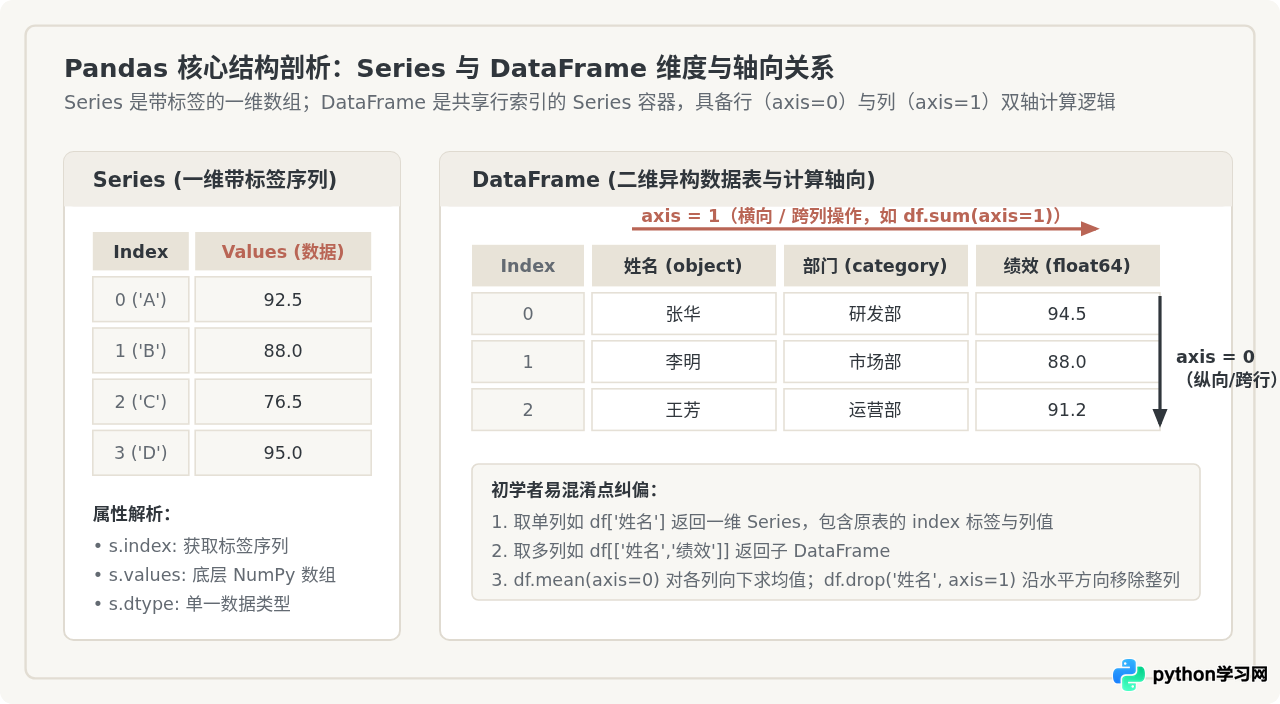
DataFrame 是二维表格型数据结构,可以看作是由多个共享同一个行索引(Index)且长度相同的 Series 组成的有序字典。表内的不同列允许具备不同的数据类型(如字符、浮点、整数或布尔值)。
在调用统计方法或删除行列时,初学者极易混淆 axis=0 与 axis=1。牢记其本质:
- axis=0(行方向 / Index 轴):沿着纵向跨行扫描。例如
df.mean(axis=0)会压缩所有行,输出每一列的平均值;默认大多数聚合操作均以此为默认值。 - axis=1(列方向 / Columns 轴):沿着横向跨列扫描。例如
df.sum(axis=1)会计算每一行中各数值列之和;df.drop('某列', axis=1)则代表横向剔除整列。
# 构造基础业务示例 DataFrame
data = {
    '员工编号': ['E101', 'E102', 'E103', 'E104'],
    '姓名': ['张华', '李明', '王芳', '赵强'],
    '部门': ['研发部', '市场部', '研发部', '运营部'],
    '绩效分': [94.5, 88.0, 91.2, 79.5],
    '考勤天数': [22, 21, 22, 20]
}
df = pd.DataFrame(data)
print(df)三、数据读取、结构初探与质量清洗
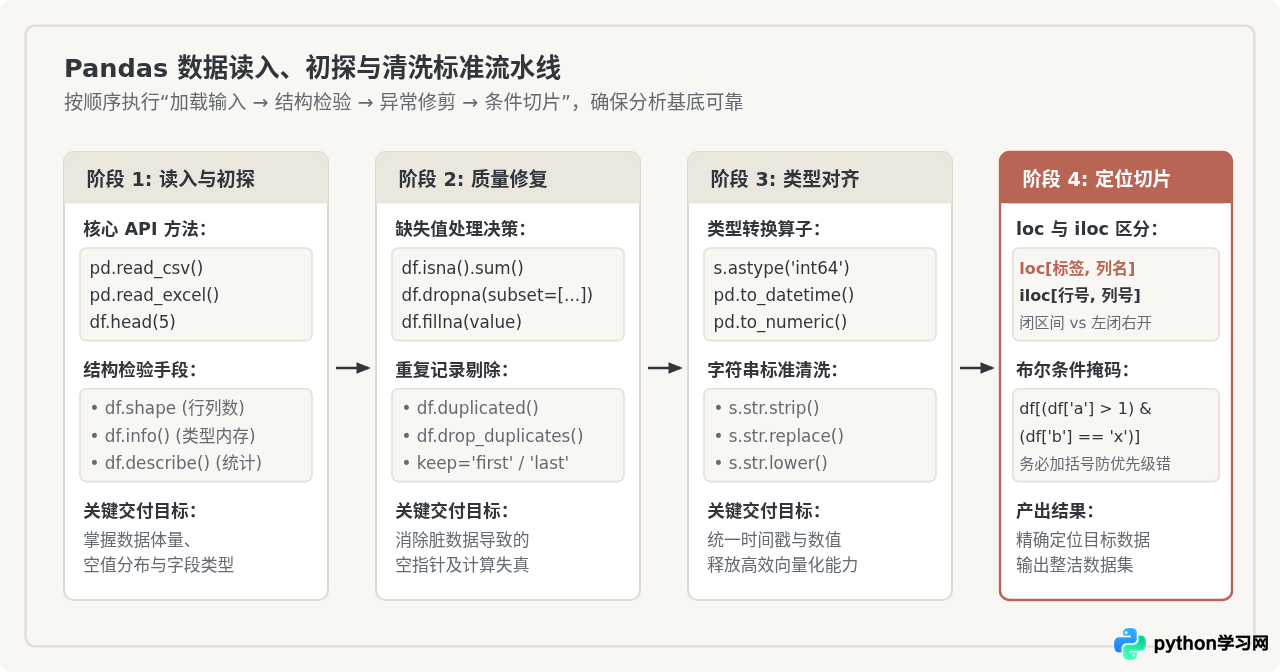
真实业务场景中的数据往往存在编码不一致、字段缺失或包含多余脏数据的情况。进入具体计算前,必须建立标准的预处理流水线。
1. 文件读取与结构初探
Pandas 提供了高度优化的 read_csv() 与 read_excel() 接口。读入后应第一时间调用探查方法掌握数据概貌:
# 读取 CSV 文件(指定 UTF-8 编码避免乱码)
# df = pd.read_csv('orders.csv', encoding='utf-8')

# 快速查看基本形貌与前几行
print("数据集维度 (行, 列):", df.shape)
print("前两行预览:
", df.head(2))

# 全面检查各列非空计数与数据类型
df.info()

# 输出数值列的基础统计指标(均值、标准差、分位数等)
print(df.describe())
2. 缺失值与重复值排查与处理
若数据存在 NaN(Not a Number),直接参与某些运算可能导致计算失真。处理时切勿盲目直接删除,需依据字段重要性区分对待:
# 检查各列的缺失值总量
print(df.isna().sum())

# 策略 A:关键主键列存在缺失时,整行剔除
df_clean = df.dropna(subset=['员工编号', '姓名'])

# 策略 B:对数值列缺失值填充均值或中位数
df['绩效分'] = df['绩效分'].fillna(df['绩效分'].median())

# 策略 C:剔除完全重复的数据行
df_unique = df.drop_duplicates(subset=['员工编号'], keep='first')
3. 严格区分定位器:loc 与 iloc
在进行行与列的切片检索时,不要使用容易引起歧义的链式方括号语法,应严格使用以下两个访问器:
| 访问器 | 依据原理 | 语法范式 | 切片区间规则 |
|---|---|---|---|
loc |
基于行索引标签与列名 | df.loc[row_label, col_name] |
闭区间(包含两端端点) |
iloc |
基于物理整数位置(从 0 开始) | df.iloc[row_idx, col_idx] |
左闭右开区间 [start, end) |
# 示例 1: 使用 loc 提取第 0 行到第 2 行的 '姓名' 与 '绩效分'(包含第 2 行)
sub_loc = df.loc[0:2, ['姓名', '绩效分']]

# 示例 2: 使用 iloc 提取前 2 行与前 3 列(不包含第 2 行和第 3 列)
sub_iloc = df.iloc[0:2, 0:3]
四、常用数据处理与分组聚合(GroupBy)实战
数据清洗完成后即可进入分析提炼阶段。核心操作包括逻辑筛选、新增计算列以及工业界最常用的 Split-Apply-Combine(拆分-应用-合并) 聚合范式。
1. 多条件向量化布尔筛选
在进行数据筛选时,必须使用位运算符 &(与)和 |(或),不能直接使用 Python 的 and / or 关键字。同时,由于位运算符优先级高于比较运算符,每个条件判断表达式两端必须显式加小括号:
# 筛选研发部且绩效分大于等于 90 的员工
condition = (df['部门'] == '研发部') & (df['绩效分'] >= 90.0)
target_employees = df[condition]
print(target_employees)2. 列的向量化运算与新增列
尽量避免使用 for 循环逐行遍历计算,Pandas 提供了底层基于 C 语言加速的向量化广播机制:
# 向量化衍生新列:计算加权综合考评指标
df['综合加权分'] = (df['绩效分'] * 0.7) + (df['考勤天数'] * 1.5)
3. 分组聚合(GroupBy)机制深度拆解
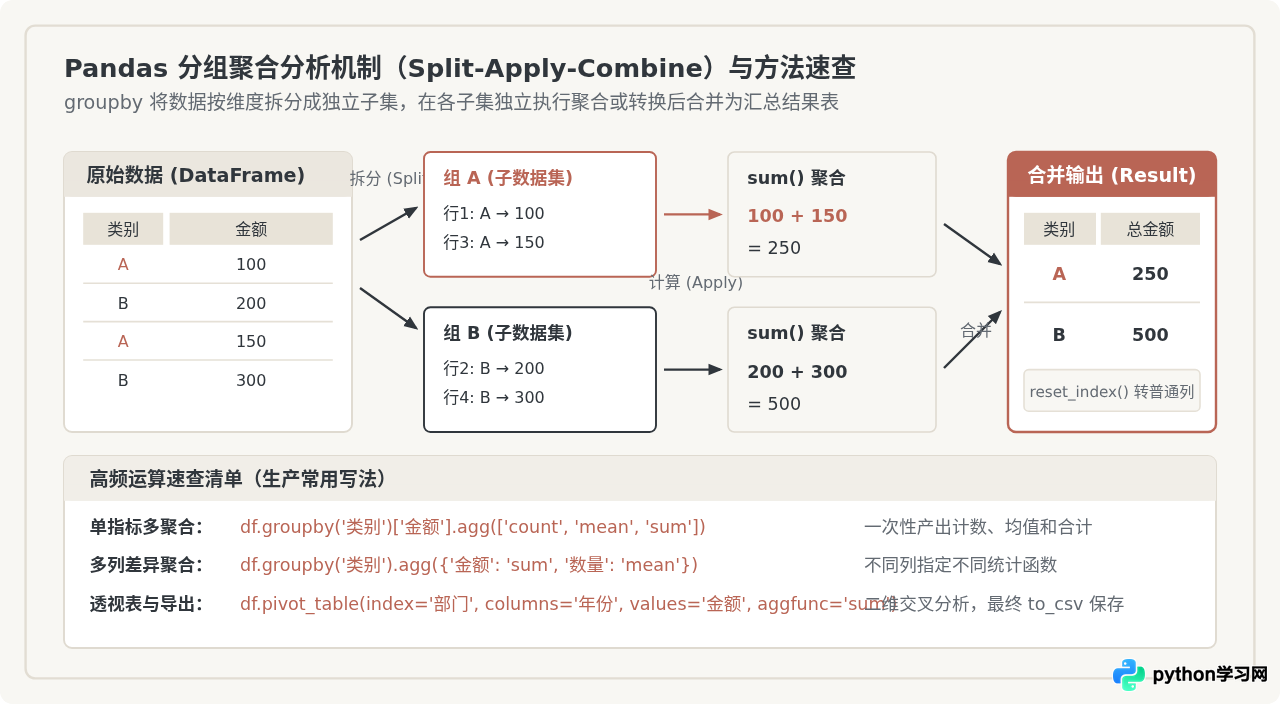
df.groupby() 并不立即执行计算,而是生成一个 DataFrameGroupBy 延迟计算对象。整个机制由三步构成:
- Split(拆分):依据给定的分类键(如“部门”),将原数据集划分为若干个互不交叉的子表。
- Apply(应用):在各个子表内部独立应用聚合统计函数(如
mean()、sum()、count())。 - Combine(合并):将计算出的标量统计值重组成一个新的汇总 DataFrame。
# 针对各部门执行多样化聚合统计
dept_summary = df.groupby('部门').agg(
    员工人数=('员工编号', 'count'),
    平均绩效=('绩效分', 'mean'),
    最高绩效=('绩效分', 'max'),
    总出勤天数=('考勤天数', 'sum')
).reset_index()

print(dept_summary)

# 分析结果导出为规范 CSV 报表(避免保存无意义的默认数字行号)
dept_summary.to_csv('dept_report.csv', index=False, encoding='utf-8-sig')五、初学者高频陷阱与规避策略
1. 警惕 SettingWithCopyWarning 警告
当对一个筛选后的切片直接赋值时,Pandas 往往会抛出此警告。原因在于该切片可能是原数据的一个“视图(View)”,也可能是独立内存“副本(Copy)”,导致赋值可能未能真正修改原对象:
# 错误示范:链式赋值触发警告
# sub_df = df[df['绩效分'] > 90]
# sub_df['等级'] = '优秀'  # 警告!

# 正确做法:显式调用 .copy() 建立独立副本
sub_df = df[df['绩效分'] > 90].copy()
sub_df['等级'] = '优秀'
2. 显式进行数据类型转换
外部导入的日期、金额往往默认为 object(即 Python 字符串类型)。在参与数学排序或时间差计算前,务必显式解析转换:
# 日期字符串转为标准 DatetimeIndex
df['入职日期'] = pd.to_datetime(df['入职日期'], format='%Y-%m-%d', errors='coerce')

# 字符串形式的金额清理特殊符号后转为浮点型
df['薪资'] = df['薪资'].str.replace('¥', '').str.replace(',', '').astype('float64')
核心学习路径小结
掌握 Python 3 数据分析的核心在于建立“工程隔离 → 结构理解 → 向量化操作”的清晰思路:
- 始终以
python3 -m venv建立独立环境,隔离依赖冲突。 - 牢记 Series 与 DataFrame 的维度对应关系,以
axis=0(跨行纵向)与axis=1(跨列横向)指导矩阵变换。 - 数据清洗遵循“探查 → 剔除/填充 → 格式化”流水线,切片时优先选用
loc/iloc。 - 利用
groupby().agg()与向量化列操作替代耗时的显式循环,高效产出业务分析洞察。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















