


Python程序设计主要应用领域:从Web开发到人工智能
深入解析Python程序设计的四大核心应用领域:Web后端与API开发、数据清洗与科学计算、人工智能与机器学习落地以及自动化脚本运维。全面剖析技术栈选型、核心机制、实战代码与工程协同架构。
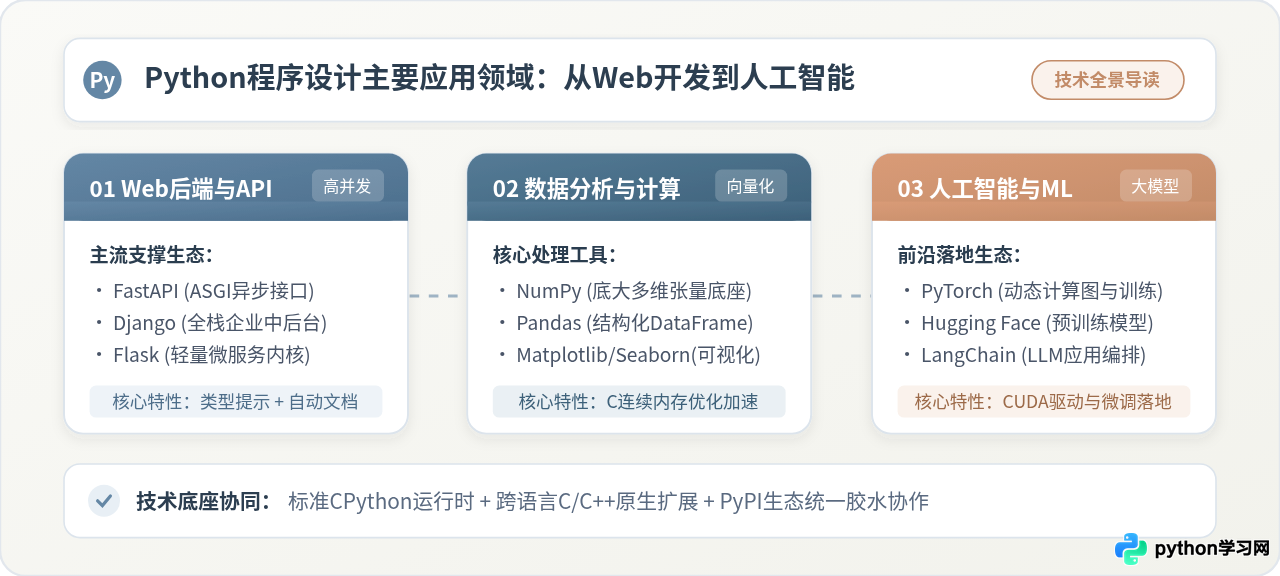
一、Python应用领域全景与技术分层架构
理解Python在各个工业领域的通用性,首先要厘清其在计算机体系中所处的真实定位。很多人误以为Python运行速度慢导致其无法胜任大型生产系统,这一判断混淆了控制流(Control Plane)与数据计算流(Compute Plane)的区别。
在工程架构中,Python往往扮演着系统胶水(Glue Language)的高阶编排角色:开发者使用表达能力极强的高级语法定义业务逻辑、组织处理管线或搭建网络接口;而底层涉及大规模内存操作、线性代数矩阵运算或高并发I/O复用的部分,则全部由预先编译的C、C++、Fortran或Rust原生动态链接库完成。
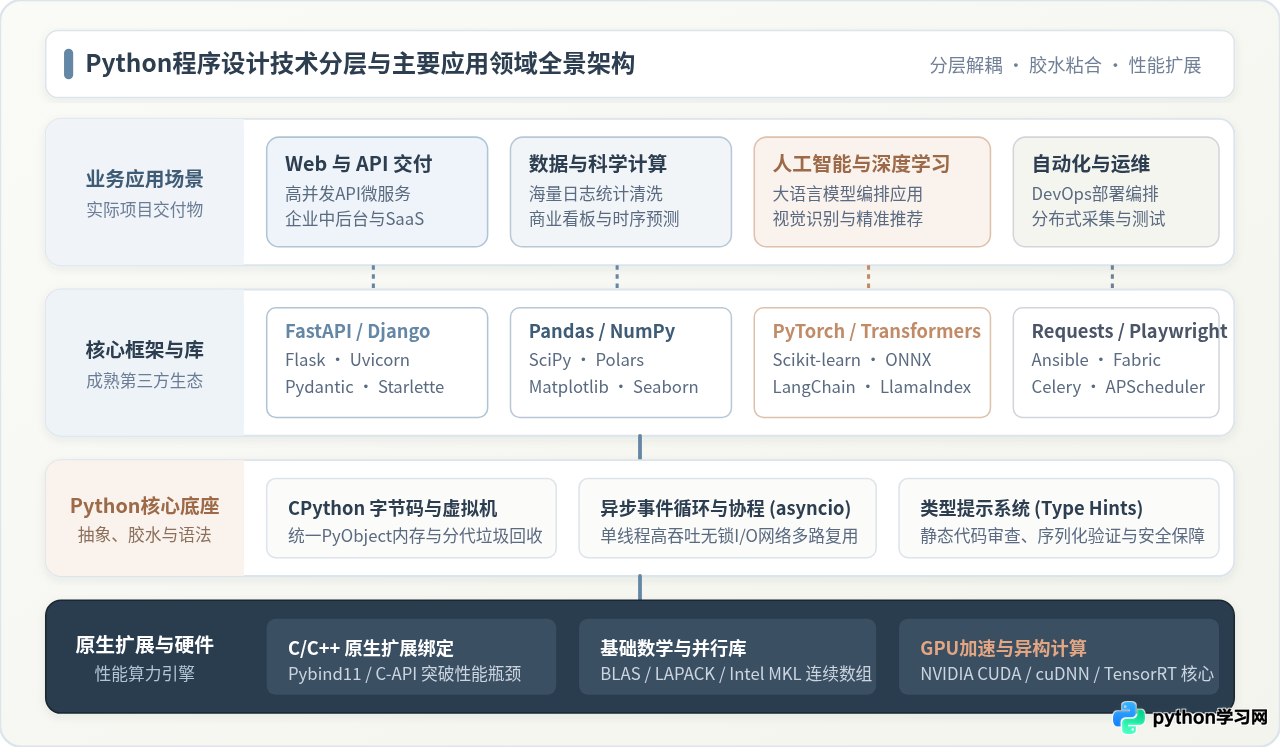
如上图所示,Python的工业级体系自顶向下清晰地划分为四个层次:
- 业务应用场景层:包括面向最终用户的Web服务、企业数据分析报表、智能推荐与大语言模型应用,以及基础设施DevOps流水线。
- 核心框架与工具库层:各垂直领域成熟的开源库,例如处理网络接口的FastAPI/Django、处理数据结构的NumPy/Pandas,以及主导AI深度学习训练的PyTorch与Transformers。
- Python核心语言与运行时层:CPython官方解释器、统一的内存对象模型(
PyObject)、自动化垃圾回收机制(引用计数加分代回收标记),以及基于事件循环的异步I/O(asyncio)和静态类型提示系统(Type Hints)。 - 原生底层与硬件加速层:通过CPython C-API或Pybind11直接绑定的BLAS/LAPACK多核数学库,以及NVIDIA CUDA驱动生态,提供真正的底层峰值性能。
二、Web后端与现代化API微服务开发
Web开发是Python最早确立工业地位的主力阵地之一。从早期单体式网站演进到现代微服务架构,Python凭借高效的迭代效率和丰富的数据接口生态,在企业中后台系统、内容管理平台以及AI模型对外的推理网关中被广泛应用。
1. 主流Web框架选型决策
选择Python Web框架时,需要基于团队规模、业务生命周期与性能诉求进行权衡:
- Django(全栈重型航母):遵循“开箱即用(Batteries-Included)”理念,内置完备的ORM、用户认证授权模块、安全防御机制与即开即用的Admin管理后台。适合业务实体复杂、权限层级严格的企业业务系统、SaaS中后台与资讯门户。
- Flask(极简微框架):核心仅保留路由分发与请求上下文,其他功能(如数据库交互、身份验证)全部通过插件自由组合,适合初学者学习HTTP底层机制,或用于快速验证原型的轻量系统。
- FastAPI(现代化异步高性能网关):当前构建高吞吐API与微服务的首选。基于Starlette异步事件驱动引擎与Pydantic数据校验,全面拥抱Python 3.8+的类型注解(Type Hints),能够自动生成可交互的OpenAPI(Swagger)文档,并发I/O性能媲美Go与Node.js。
2. 实战示例:使用FastAPI构建异步数据接口
以下示例展示如何使用FastAPI实现一个具备自动参数校验、结构化数据响应和异步非阻塞特性的分析计算接口:
import asyncio
from typing import List, Optional
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field

app = FastAPI(
    title="数据计算与业务分析接口服务",
    description="提供异步非阻塞的统计指标计算服务",
    version="1.0.0"
)

# 1. 定义强类型请求输入规范
class AnalysisRequest(BaseModel):
    batch_id: str = Field(..., description="批次唯一标识符", min_length=4)
    values: List[float] = Field(..., description="待计算的数据浮点数组")
    multiplier: Optional[float] = Field(1.0, description="放大权重因子", ge=0.0)

# 2. 定义规范化输出结果模型
class AnalysisResponse(BaseModel):
    batch_id: str
    total_count: int
    mean_value: float
    max_value: float
    scaled_sum: float

# 3. 异步路由处理函数
@app.post("/api/v1/analyze", response_model=AnalysisResponse, status_code=status.HTTP_200_OK)
async def process_analysis(request: AnalysisRequest):
    if not request.values:
        raise HTTPException(
            status_code=status.HTTP_400_BAD_REQUEST,
            detail="输入数值数组不能为空"
        )

    # 模拟非阻塞I/O操作(例如异步查询数据库或等待上游分布式缓存)
    await asyncio.sleep(0.05)

    total = sum(request.values)
    count = len(request.values)
    mean = total / count
    max_val = max(request.values)
    scaled_total = total * request.multiplier

    return AnalysisResponse(
        batch_id=request.batch_id,
        total_count=count,
        mean_value=round(mean, 4),
        max_value=round(max_val, 4),
        scaled_sum=round(scaled_total, 4)
    )

# 启动命令(示例终端指令,非直接执行):
# uvicorn web_service:app --host 0.0.0.0 --port 8000 --workers 4三、数据清洗、分析与科学计算基石
如果说Web开发展现了Python的工程敏捷性,那么数据科学则是Python稳居编程语言榜首的根本动力。无论是金融量化分析、互联网用户行为洞察,还是高校科研实验,Python都已成为事实上的通用数据分析平台。
1. 科学计算“铁三角”分工
Python数据处理的高效性建立在三款核心库的分工协作之上:
- NumPy(多维张量底座):提供基于连续内存存储的
ndarray多维数组。其数学函数使用C/Fortran底层实现,在矩阵点积、切片索引和广播机制(Broadcasting)上绕过了Python解释器的开销。 - Pandas(结构化表格数据处理):构建在NumPy之上,提供带行列标签的二维数据结构
DataFrame。具备强大的数据清洗、缺失值填充、时间序列重采样、透视表生成以及类似SQL的merge与groupby能力。 - Matplotlib & Seaborn(数据可视化呈现):从底层的折线图、直方图到高级统计热力图,为探索性数据分析(EDA)提供直观的图表渲染输出。
2. 实战示例:Pandas多维销售日志聚合与异常过滤
以下代码演示从结构化数据中识别异常值、按业务维度分组统计并计算增长率的完整处理步骤:
import pandas as pd
import numpy as np

# 1. 模拟电商销售明细样本数据
raw_data = {
    "order_id": ["ORD-101", "ORD-102", "ORD-103", "ORD-104", "ORD-105", "ORD-106", "ORD-107"],
    "region": ["华东", "华北", "华东", "华南", "华北", "华东", "华南"],
    "category": ["电子", "家居", "电子", "服装", "电子", "服装", "家居"],
    "sales_amount": [1280.0, 320.0, np.nan, 450.0, 2100.0, -50.0, 680.0],  # 包含缺失值与异常负值
    "quantity": [2, 1, 3, 2, 4, 1, 2]
}

df = pd.DataFrame(raw_data)

# 2. 数据清洗:滤除金额缺失与非法负数
clean_df = df.dropna(subset=["sales_amount"]).copy()
clean_df = clean_df[clean_df["sales_amount"] > 0]

# 3. 衍生计算:计算单件平均客单价
clean_df["unit_price"] = clean_df["sales_amount"] / clean_df["quantity"]

# 4. 多维分组聚合统计
summary = clean_df.groupby(["region", "category"]).agg(
    total_revenue=("sales_amount", "sum"),
    avg_price=("unit_price", "mean"),
    order_count=("order_id", "count")
).reset_index()

# 5. 排序与输出结果
summary = summary.sort_values(by="total_revenue", ascending=False)
print("=== 区域与品类销售聚合汇总表 ===")
print(summary.to_string(index=False))=== 区域与品类销售聚合汇总表 ===
region category total_revenue avg_price order_count
华北 电子 2100.0 525.00 1
华东 电子 1280.0 640.00 1
华南 家居 680.0 340.00 1
华南 服装 450.0 225.00 1
华北 家居 320.0 320.00 1四、人工智能与机器学习工程化落地
人工智能(AI)是当前Python生态最为耀眼的领域。从传统基于统计学习的评分预测,到以卷积神经网络(CNN)为代表的图像识别,再到以Transformer架构为核心的大语言模型(LLM)与AI Agent应用,Python构筑了全球AI研发的统一基础设施。
1. AI研发全链路工程交付步骤
AI项目绝非仅仅是调用模型生成一句话,而是一套涵盖数据、训练、图优化与线上部署的严谨流水线。下图展示了从原始数据清洗到模型对外提供高并发API的端到端工程步骤:
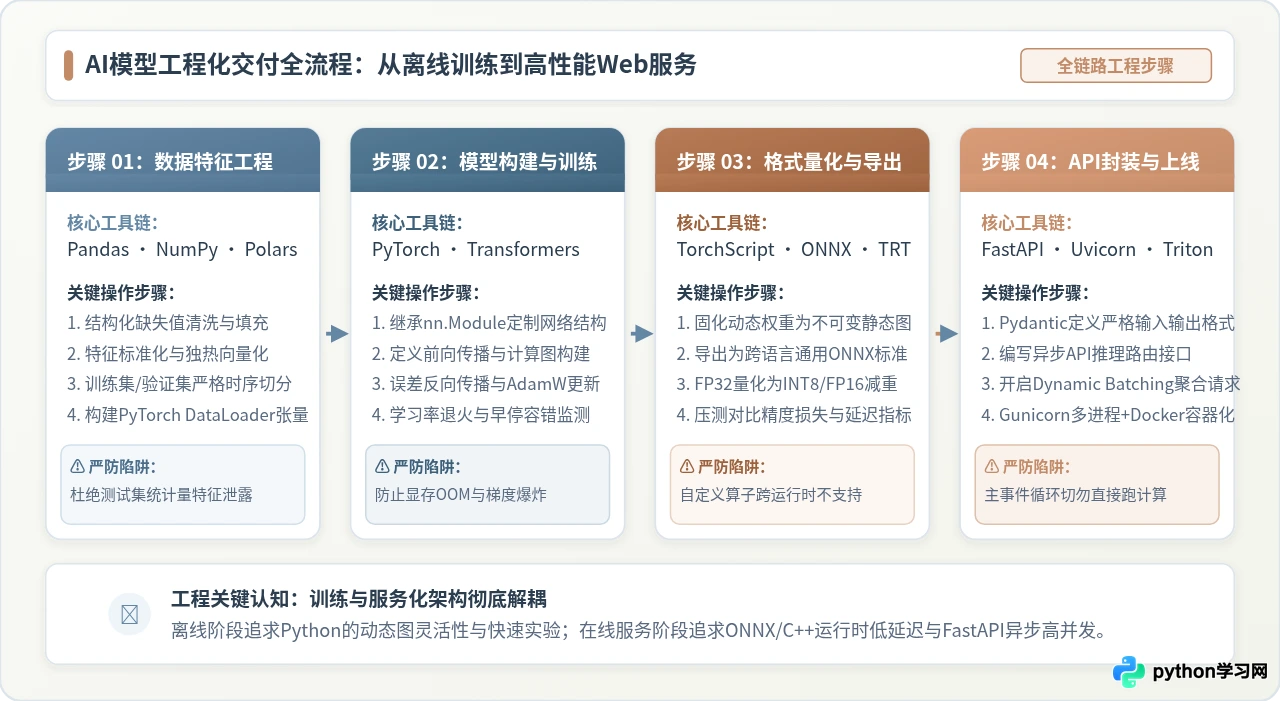
如图2所示,将一个算法从实验推向生产必须经过四个标准阶段:
- 步骤 01:数据特征工程(Pandas/NumPy):将现实业务数据转化为可被数学计算理解的稠密张量。必须严格隔离训练集与测试集的统计量计算,严防特征泄露(Data Leakage)。
- 步骤 02:模型构建与离线训练(PyTorch):继承
nn.Module定义前向计算图。利用GPU显卡执行批处理矩阵相乘,通过自动微分系统(Autograd)反向更新权重。同时监控训练损失曲线,避免显存溢出(OOM)。 - 步骤 03:格式量化与优化导出(ONNX / TorchScript):解除对Python动态解释器的依赖,将模型计算图固化为静态结构,通过INT8或FP16精度量化减少显存占用并提升运算吞吐。
- 步骤 04:API服务化部署(FastAPI / Triton):将量化后的模型接入ASGI异步接口,配合请求动态微批次(Dynamic Batching),为外部前端或微服务提供低延迟预测响应。
2. 实战示例:使用PyTorch构建轻量分类网络
以下代码展示如何使用PyTorch编写一个符合生产规范的多层感知机(MLP)分类器,并完成前向张量推理与模型权重导出:
import torch
import torch.nn as nn
import torch.nn.functional as F

# 1. 继承 nn.Module 构建前向分类网络
class RiskClassifier(nn.Module):
    def __init__(self, input_dim: int, hidden_dim: int, num_classes: int):
        super(RiskClassifier, self).__init__()
        # 全连接特征提取层与归一化
        self.fc1 = nn.Linear(input_dim, hidden_dim)
        self.layer_norm = nn.LayerNorm(hidden_dim)
        self.fc2 = nn.Linear(hidden_dim, 32)
        self.out_proj = nn.Linear(32, num_classes)
        self.dropout = nn.Dropout(p=0.2)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # 输入张量维度: [batch_size, input_dim]
        x = self.fc1(x)
        x = self.layer_norm(x)
        x = F.relu(x)
        x = self.dropout(x)

        x = F.relu(self.fc2(x))
        logits = self.out_proj(x)
        return logits

# 2. 模拟生产推理输入验证
input_features = 16
batch_samples = 4
model = RiskClassifier(input_dim=input_features, hidden_dim=64, num_classes=2)
model.eval()  # 切换为评估推理模式(关闭Dropout随机性)

# 模拟输入张量(4个待检测风控样本)
dummy_input = torch.randn(batch_samples, input_features, dtype=torch.float32)

with torch.no_grad():
    logits = model(dummy_input)
    probabilities = F.softmax(logits, dim=1)
    predictions = torch.argmax(probabilities, dim=1)

print("=== PyTorch 模型前向推理输出 ===")
print(f"预测类别结果: {predictions.tolist()}")
print(f"类别概率分布:\n{probabilities.numpy()}")

# 3. 固化保存模型权重(供服务化部署加载)
torch.save(model.state_dict(), "risk_model_weights.pth")
print("\n[成功] 模型权重已固化保存至 risk_model_weights.pth")async def路由中调用模型,会导致当前进程的异步事件循环被完全卡死。正确做法是使用asyncio.to_thread()将推理分派到专用工作线程,或者独立部署基于C++内核的Triton Inference Server。
五、自动化脚本与系统运维集成
除了Web开发与人工智能这两大宏大主题,Python还在日常工程运作中承担着不可或缺的“自动化工兵”角色。任何涉及多系统数据流转、文件批处理、基础设施巡检与网络测试的任务,都能使用Python在数十行代码内快速搞定。
1. 自动化工程核心工具图谱
- 系统操作与批处理:标准库自带的
os、sys、shutil和subprocess,能够精确调用Shell命令并重定向输出流,实现日志按日切割、目录同步与磁盘告警。 - 网络采集与API连通性:
Requests提供符合人类直觉的HTTP客户端;现代端到端自动化工具Playwright则通过无头浏览器(Headless Chrome)模拟用户交互,用于页面自动化回归测试与动态页面抓取。 - 自动化运维与配置管理:开源配置编排系统Ansible底层完全由Python编写,用户通过编写声明式YAML剧本,由Python在远程数十台服务器上并发执行配置变更。
2. 实战示例:带指数退避重试的API健康巡检脚本
以下示例展示一个企业级自动化健康巡检脚本,具备超时限制、异常捕获与重试机制:
import time
import requests
from typing import Dict, Any

TARGET_URL = "https://api.example.com/healthz"
MAX_RETRIES = 3
TIMEOUT_SECONDS = 3.0

def probe_service_status(url: str, max_retries: int, timeout: float) -> Dict[str, Any]:
    # 带有退避重试机制的服务健康度探测函数
    backoff_delay = 1.0

    for attempt in range(1, max_retries + 1):
        try:
            start_time = time.perf_counter()
            response = requests.get(url, timeout=timeout)
            latency_ms = (time.perf_counter() - start_time) * 1000.0

            if response.status_code == 200:
                return {
                    "status": "HEALTHY",
                    "code": response.status_code,
                    "latency_ms": round(latency_ms, 2),
                    "attempt": attempt
                }
            else:
                print(f"[警告] 第 {attempt} 次探测返回非200状态码: {response.status_code}")
        except (requests.ConnectionError, requests.Timeout) as err:
            print(f"[错误] 第 {attempt} 次探测失败: {type(err).__name__}")

        # 指数退避休眠后重试
        if attempt < max_retries:
            time.sleep(backoff_delay)
            backoff_delay *= 2.0

    return {
        "status": "UNHEALTHY",
        "code": None,
        "latency_ms": None,
        "attempt": max_retries
    }

# 执行并打印模拟输出
result = probe_service_status("https://httpbin.org/status/200", MAX_RETRIES, TIMEOUT_SECONDS)
print(f"探测最终结果: {result}")
六、企业级多领域协同架构实践
在真实的商业系统落地中,Web后端、数据分析、人工智能与自动化运维绝非割裂存在,而是互相衔接的有机整体。一个典型的高并发AI应用,前端由FastAPI作为高性能网关接收流量,后台由Pandas清洗数据并提供给PyTorch执行实时推理,同时通过Python自动化巡检脚本保障高可用。
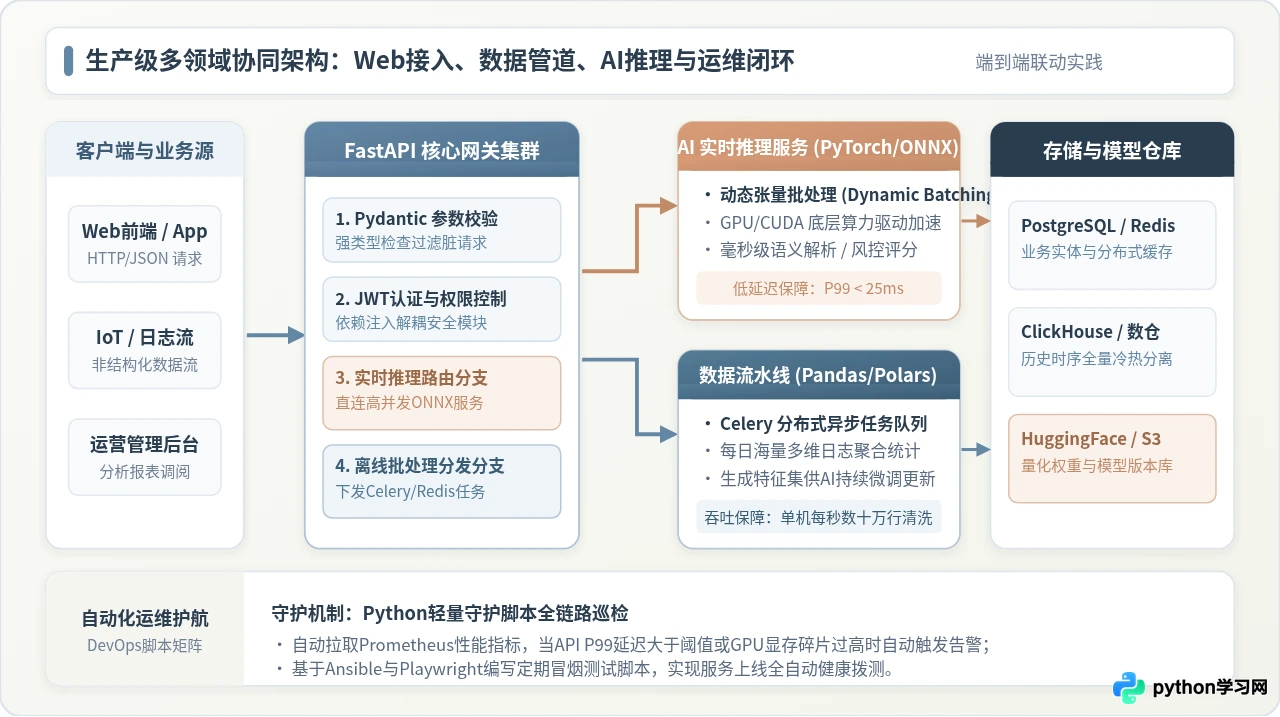
如上图所示,各领域在生产系统中形成了高效闭环:
- 在线链路(Online Path):客户端请求涌入FastAPI核心网关集群,经过Pydantic参数校验与身份鉴权后,高优先级的实时推理请求被直接分发至基于PyTorch/ONNX优化的AI推理微服务,在25毫秒内完成评分或预测并返回给用户。
- 离线与分析链路(Offline Path):对于耗时较长的数据清洗、汇总统计与模型重新微调任务,网关将其推入Celery/Redis分布式异步任务队列。Pandas与Polars在后台工作节点上并发运行,完成海量数据聚合后落库至PostgreSQL与ClickHouse分析数仓。
- 运维护航链路(Ops Guard Path):常驻后台的Python轻量守护脚本定时采集Prometheus暴露的API延迟指标、GPU显存碎片率与队列堆积深度,一旦出现异常立即通过Webhook触发自动告警与弹性扩容。
七、主要领域对比与选型决策指南
面对纷繁复杂的应用场景,工程师或技术团队在启动项目或制定技术路线时,应当根据核心瓶颈与团队技能储备做出科学决策。
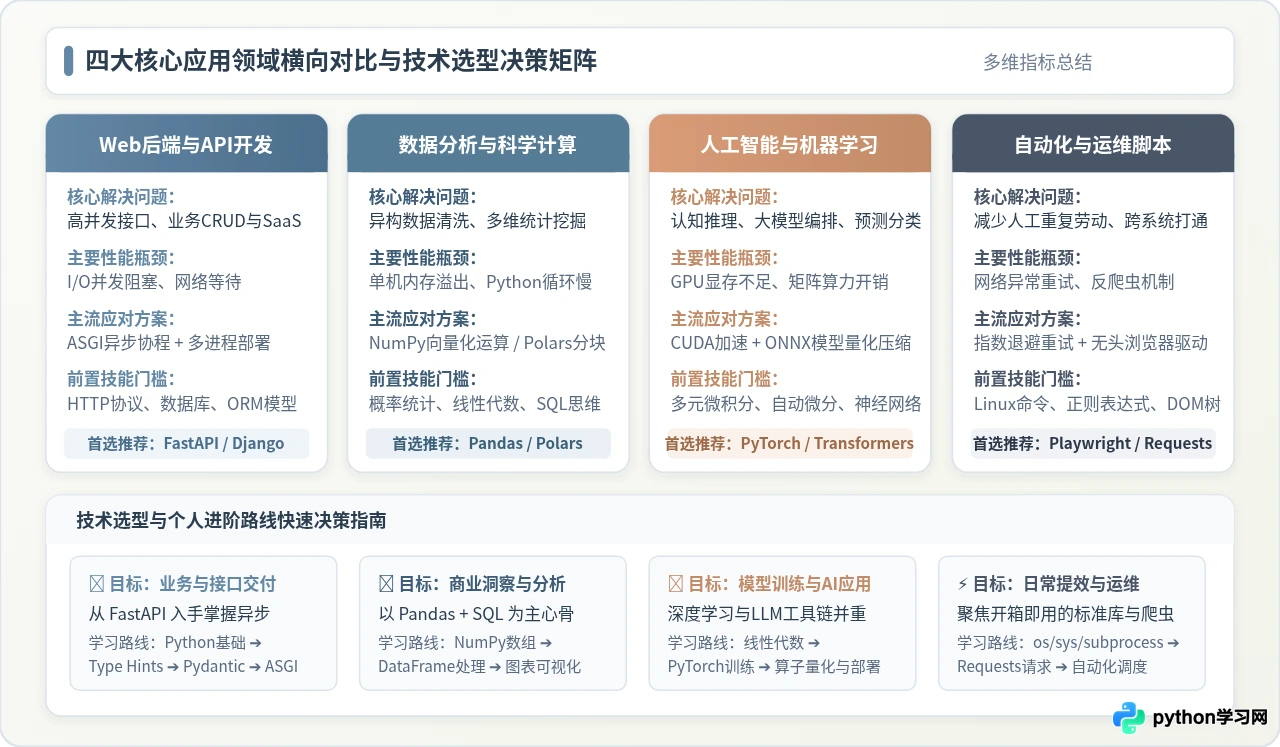
| 比较维度 | Web后端与API开发 | 数据分析与科学计算 | 人工智能与深度学习 | 自动化与运维脚本 |
|---|---|---|---|---|
| 核心解决目标 | 高并发接口、业务CRUD与SaaS系统 | 异构日志清洗、多维统计与业务洞察 | 认知推理、神经网络微调、大模型Agent | 消除机械重复劳动、基础设施编排 |
| 主要性能瓶颈 | 网络I/O等待、数据库连接阻塞 | 单机物理内存溢出、解释器循环低效 | GPU显存容量限制、矩阵浮点计算开销 | 目标服务网络超时、反爬虫机制对抗 |
| 推荐生产工具 | FastAPI / Django / Uvicorn | Pandas / NumPy / Polars | PyTorch / Transformers / ONNX | Requests / Playwright / Ansible |
| 关键突破方案 | ASGI异步协程 + 多进程部署 | C底层向量化运算 + 数据分块处理 | 动态Batching + 算子量化(INT8/FP16) | 指数退避重试 + 幂等性设计 |
| 入门前置知识 | HTTP协议、关系型数据库、ORM | 概率论与统计学、SQL查询、数据清洗 | 微积分、线性代数、自动微分机制 | Linux常用命令、正则表达式、JSON |
决策与能力演进建议
对于个人开发者或团队的技术路径选择,建议遵循以下两条递进路径:
- 工程交付路线:从学习基础脚本编写(os/Requests)出发 ➔ 掌握FastAPI构建规范的RESTful微服务 ➔ 进阶学习异步高并发架构与Docker容器化部署,成长为全栈工程交付专家。
- 数据与算法路线:从NumPy张量与Pandas表格数据处理切入 ➔ 掌握Scikit-learn经典统计建模 ➔ 深入PyTorch深度学习网络与大模型微调工程,成为兼具算法理论与落地能力的AI系统架构师。
八、工程实践通用守则与结语
在任何Python应用领域展开严肃生产开发时,应恪守以下三条核心准则:
- 环境彻底隔离:杜绝向操作系统全局Python环境中安装第三方包。所有项目必须通过
venv、uv或conda创建相互独立的虚拟环境,并输出严格锁定版本的依赖配置文件。 - 全面拥抱强类型提示(Type Hints):在Web接口数据出入参、数据处理流水线和模型调用函数中,全量声明类型注解。配合
mypy进行CI/CD静态代码检查,可消除超过60%的运行时类型错误。 - 清晰界定语言边界:牢记Python适合做逻辑抽象与业务编排。一旦遇到绝对意义上的CPU密集型算法或微秒级极致性能要求,及时编写C++或Rust扩展,充分发挥Python的胶水整合优势。
从Web开发的高并发接口到人工智能的前沿大模型,Python并非在每个单点上都具备最极端的运行速度,但它凭借统一的语言心智模型、极低的试错成本与极其强大的底层连接力,成为了当今软件工程中连接人、数据与计算硬件的最坚固桥梁。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















