


Python+OpenCV实现车牌字符分割和识别

本文介绍使用Python和OpenCV进行车牌字符分割与识别的入门方法。主要步骤包括将RGB图像灰度化并二值化为0-1矩阵,通过统计列像素值进行简单切割,最后利用像素比对或投影匹配算法识别字符。
近期开展了一项车牌识别项目,属于基础入门级别,整体流程较为简单。
车牌识别流程主要包含两个核心阶段:
第一阶段为车牌定位,即从原始图像中准确框选出车牌区域。
第二阶段为车牌字符识别。
本文重点阐述第二阶段,即字符识别,该过程包含以下两个子步骤:
1、图像预处理
原始图像由RGB三个通道定义像素,导致背景与字符难以直接区分。因此需对图像进行处理,将每个RGB像素转换为单比特值(0或1),具体处理流程如下:
①图像灰度化处理
该步骤旨在将每个像素的RGB值转换为相等的灰色值(即R=G=B)。具体实现细节无需手动计算,OpenCV已提供封装好的函数可直接调用。
②图像二值化处理
灰度化的目的是使每个像素可转换为0或1。由于灰度值中R=G=B,可将其统称为灰度值。假设灰度车牌图像中背景灰度值集中在180(十进制)左右,而字符灰度值集中在20左右,设定阈值100:灰度值小于100的像素点设为0,大于100的设为1,从而实现二值化。
③图像旋转与水平校正
此步骤涉及图像几何校正,此处暂不展开讨论。
④图像去噪处理
去噪涉及更复杂的算法,后续如有时间将补充相关内容,本入门项目暂不作要求。
2、图像切割与字符识别
①图像切割
切割算法的复杂度取决于具体方法的选择。
此处采用一种基础且直观的方法进行切割。
此时图像已转化为0-1矩阵,其中要么0代表背景、1代表字符,要么相反。可采用简单粗暴的方式,通过统计每一列中0和1的数量来进行切割。
假设图像基本水平且噪点极少,具体操作步骤如下:
a.分别统计每一列中1值和0值的数量。
b.根据每一列0-1数量的变化规律来界定字符边界并进行切割。
②图像识别
将每个字符图像分割出来后,即可通过模板匹配来判断具体字符。
这里介绍两种简单的方法:
a.逐像素比对:若像素值一致则计数加一,最终根据计数值确定匹配结果。
b.投影匹配:分别统计每行和每列的像素位,根据差值大小确定匹配结果。
将上述两种方法结合使用,可获得较好的识别效果。
具体的识别算法细节将在后续补充。
以下是实现字符分割的代码示例。
import cv2

# 1、读取图像,并把图像转换为灰度图像并显示
img = cv2.imread("chepai/6.png") # 读取图片
img_gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY) # 转换了灰度化
cv2.imshow('gray', img_gray) # 显示图片
cv2.waitKey(0)

# 2、将灰度图像二值化,设定阈值是100
img_thre = img_gray
cv2.threshold(img_gray, 100, 255, cv2.THRESH_BINARY_INV, img_thre)
cv2.imshow('threshold', img_thre)
cv2.waitKey(0)

# 3、保存黑白图片
cv2.imwrite('thre_res.png', img_thre)

# 4、分割字符
white = [] # 记录每一列的白色像素总和
black = [] # ..........黑色.......
height = img_thre.shape[0]
width = img_thre.shape[1]
white_max = 0
black_max = 0
# 计算每一列的黑白色像素总和
for i in range(width):
 s = 0 # 这一列白色总数
 t = 0 # 这一列黑色总数
 for j in range(height):
 if img_thre[j][i] == 255:
  s += 1
 if img_thre[j][i] == 0:
  t += 1
 white_max = max(white_max, s)
 black_max = max(black_max, t)
 white.append(s)
 black.append(t)
 print(s)
 print(t)

arg = False # False表示白底黑字;True表示黑底白字
if black_max > white_max:
 arg = True

# 分割图像
def find_end(start_):
 end_ = start_+1
 for m in range(start_+1, width-1):
 if (black[m] if arg else white[m]) > (0.95 * black_max if arg else 0.95 * white_max): # 0.95这个参数请多调整,对应下面的0.05
  end_ = m
  break
 return end_

n = 1
start = 1
end = 2
while n < width-2:
 n += 1
 if (white[n] if arg else black[n]) > (0.05 * white_max if arg else 0.05 * black_max):
 # 上面这些判断用来辨别是白底黑字还是黑底白字
 # 0.05这个参数请多调整,对应上面的0.95
 start = n
 end = find_end(start)
 n = end
 if end-start > 5:
  cj = img_thre[1:height, start:end]
  cv2.imshow('caijian', cj)
  cv2.waitKey(0)
源程序未直接输出图片文件,而是通过窗口显示结果,以下为执行效果展示。
原始输入图片:
经过灰度化处理后的图片:
二值化后的图片(呈现白底黑字效果):
完成字符分割后的结果:
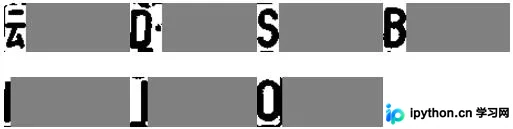
整体分割效果尚可,但若遇到干扰较多的图像(如左右边框过宽或噪点过多),则可能无法正确分割,建议读者尝试不同照片以验证效果。
本文内容至此结束,希望对各位的学习有所帮助,欢迎继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















