


pandas按若干个列的组合条件筛选数据的方法

发布时间:2026-10-14 |
4人浏览过
本文介绍如何使用pandas根据多个列的组合条件筛选数据。通过示例展示如何筛选“设计井别”、“投产井别”和“目前井别”均为11的记录,并演示如何通过反向逻辑删除这些行。包含完整的代码实现及文件读写注意事项,适用于需要复杂条件过滤的数据处理场景。
pandas多列组合条件筛选与反向删除操作
直接通过图表来直观展示操作效果。
以A文件为例:
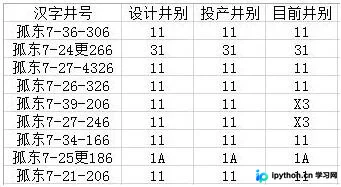
假设我们需要筛选出“设计井别”、“投产井别”以及“目前井别”这三列数据同时等于11的记录,最终结果如下图所示:
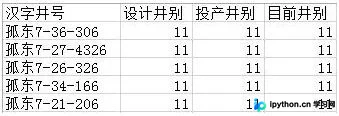
具体的筛选逻辑可以根据实际需求灵活调整,参考以下代码实现:
# -*- coding: utf-8 -*-
"""
Created on Wed Nov 29 10:46:31 2017
@author: wq
"""
import pandas as pd
#input.csv是那个大文件,有很多很多行
df1 = pd.read_csv(u'input.csv', encoding='gbk')
#加encoding=‘gbk'是因为文件中存在中文,不加可能出现乱码
#这里的筛选条件可以根据用户需要进行修改
outfile = df1[(df1[u'设计井别']=='11') & (df1[u'投产井别']=='11') &(df1[u'目前井别']=='11')]
outfile.to_csv('outfile.csv', index=False, encoding='gbk')
有时我们需要执行相反的操作,即删除那些“设计井别”、“投产井别”和“目前井别”三列数据均为11的行,处理效果如下:
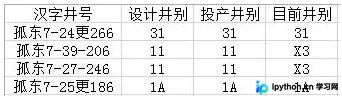
实现该反向删除功能的代码如下:
#input.csv是那个大文件,有很多很多行
df1 = pd.read_csv(u'input.csv', encoding='gbk')
df2 = pd.read_csv(u'outfile.csv', encoding='gbk')
#加encoding=‘gbk'是因为文件中存在中文,不加可能出现乱码
index = ~df1[u'汉字井号'].isin(df2[u'汉字井号'])
df4 = df1[index]
df4.to_csv('outfile1.csv', index=False, encoding='gbk')
以上关于pandas按若干个列的组合条件筛选数据的方法分享完毕,希望能为读者提供有益参考,欢迎继续支持本站获取更多技术内容。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















