


Python批量处理多个文本文件并分别生成词云图
详细讲解如何使用Python批量读取目录下的多个文本文件,结合jieba分词与停用词过滤,并分别生成独立的词云图保存到指定输出目录。
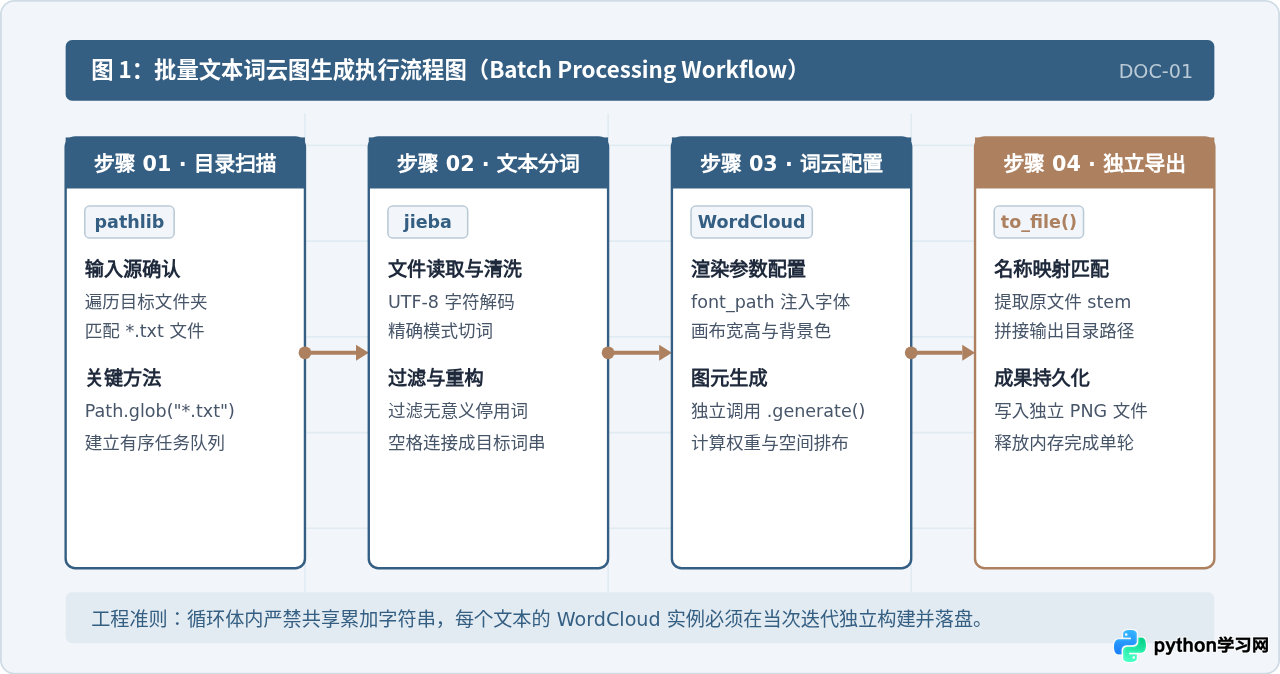
在处理多篇文本资料(如客户评价、调查问卷、文档章节或多篇调研报告)时,如果逐个手动提取内容并绘制词云,不仅费时费力,还容易在参数配置与文件命名上产生疏漏。使用 Python 批量生成词云图的核心思路非常清晰:利用 pathlib 模块扫描目标目录中的所有文本文件;对每个文件分别读取内容并使用中文分词库(如 jieba)进行切词与停用词过滤;接着为每个文件独立实例化 WordCloud 对象并完成词频统计与排版;最后以原文件名作为命名基准,将对应的词云图独立输出保存为图片文件。本文将按照实际开发顺序,拆解整个批处理流程并提供完整的代码与排错方法。
一、批量处理的核心逻辑与执行流程
批量处理的关键在于“循环内的独立性与状态隔离”。每次循环应当只读取当前这一个文本文件,并在处理完毕后将词云保存至对应的目标路径,不能将多个文本的分词结果混淆在一起。为了保证脚本在不同操作系统中稳定运行,推荐使用 Python 内置的 pathlib.Path 处理路径,既能自动化遍历匹配后缀,也能方便地解析无后缀的文件名(stem)。
二、环境准备与依赖安装
完成本文任务需要安装以下 Python 第三方库:
- jieba:中文分词组件。因为中文词语之间没有天然的空格分界,必须先使用分词工具切分成有意义的独立词汇,再交给词云统计。
- wordcloud:词云生成核心库,根据词语出现频次自动调整字号并完成防碰撞排版。
- matplotlib(可选):用于调配特定的颜色映射方案(colormap)或提供展示窗口,通常建议一同安装。
打开终端或命令行,执行如下安装命令:
pip install jieba wordcloud matplotlib三、目录结构规划与数据流动架构
为了让批量处理逻辑更严谨,推荐在工作目录下区分“输入文本目录”与“输出图片目录”。这样不仅防止输入和输出文件混淆,还能在脚本开头自动判断输出目录是否存在,不存在则自动创建。
推荐的文件组织方式如下:
project_dir/
│
├── batch_wordcloud.py       # 批量处理主脚本
├── stopwords.txt            # 中文停用词表(每行一个词)
├── text_inputs/             # 待处理的多个文本文件
│   ├── document_A.txt
│   ├── document_B.txt
│   └── document_C.txt
└── wordcloud_outputs/       # 自动生成的对应词云图
    ├── document_A.png
    ├── document_B.png
    └── document_C.png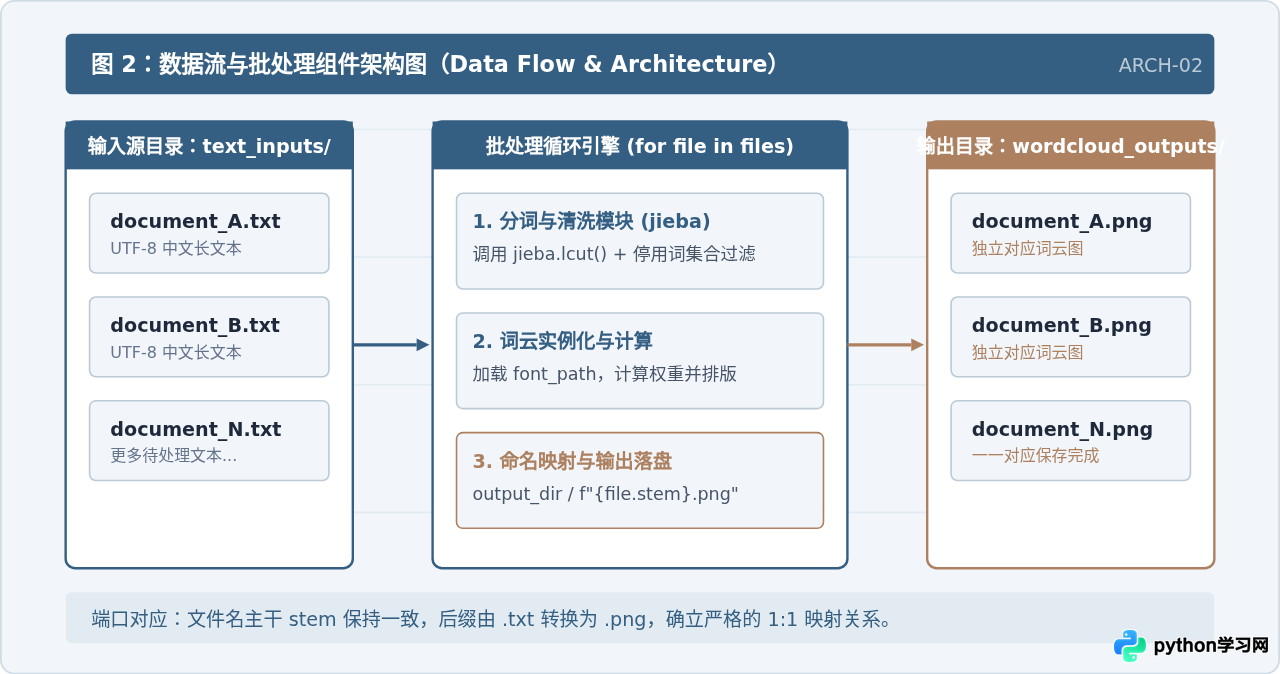
四、中文字体配置与核心参数映射
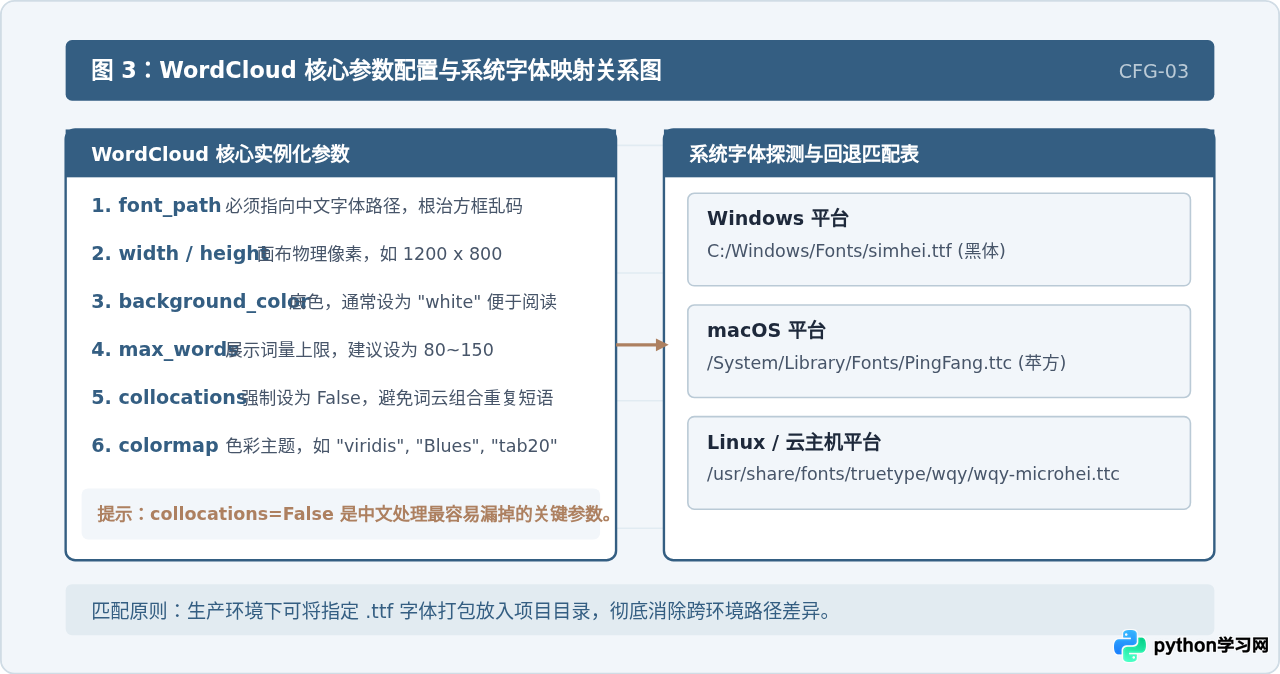
wordcloud 库默认自带的英文字体无法识别中文字符,若未显式指定支持中文的字体文件,生成的词云图中所有中文字都会退化成方框(俗称“豆腐块”)。解决该问题的唯一正确方式是在构建 WordCloud 对象时显式指定 font_path 参数,指向系统中客观存在的字体路径或项目自带的 .ttf/.ttc 字体文件。
| 操作系统 | 常用中文字体名称 | 参考绝对路径 |
|---|---|---|
| Windows | 黑体 (SimHei) / 微软雅黑 | C:/Windows/Fonts/simhei.ttf 或 msyh.ttc |
| macOS | 苹方 (PingFang SC) / 冬青黑体 | /System/Library/Fonts/PingFang.ttc 或 /System/Library/Fonts/Supplemental/Songti.ttc |
| Linux / Ubuntu | 文泉驿微米黑 / 思源黑体 | /usr/share/fonts/truetype/wqy/wqy-microhei.ttc |
五、完整批量处理代码实现
下面给出一段完整的 Python 批处理脚本。代码中包含了字体自适应检查、目录自动创建、停用词精准过滤、异常跳过保护以及文件名一一对应的生成逻辑。
import os
import sys
from pathlib import Path
import jieba
from wordcloud import WordCloud

# ==================== 1. 基础配置 ====================
INPUT_DIR = Path("./text_inputs")          # 文本输入文件夹
OUTPUT_DIR = Path("./wordcloud_outputs")    # 词云输出文件夹
STOPWORDS_FILE = Path("./stopwords.txt")    # 停用词表路径

# 自动定位当前系统的中文字体(确保无乱码)
def get_chinese_font():
    candidate_fonts = [
        # Windows
        "C:/Windows/Fonts/simhei.ttf",
        "C:/Windows/Fonts/msyh.ttc",
        # macOS
        "/System/Library/Fonts/PingFang.ttc",
        "/System/Library/Fonts/Supplemental/Songti.ttc",
        # Linux
        "/usr/share/fonts/truetype/wqy/wqy-microhei.ttc",
        "/usr/share/fonts/opentype/noto/NotoSansCJK-Regular.ttc"
    ]
    for font in candidate_fonts:
        if os.path.exists(font):
            return font
    return None

# ==================== 2. 加载停用词 ====================
def load_stopwords(filepath):
    stopwords = {"的", "了", "和", "是", "就", "都", "而", "及", "与", "在", "这", "那"}
    if filepath and filepath.exists():
        with open(filepath, "r", encoding="utf-8") as f:
            for line in f:
                word = line.strip()
                if word:
                    stopwords.add(word)
    return stopwords

# ==================== 3. 单文本处理逻辑 ====================
def process_single_text(text_content, font_path, stopwords):
    # 使用 jieba 精确分词
    words = jieba.lcut(text_content)
    # 过滤停用词、单字以及纯符号
    filtered_words = [
        w for w in words
        if len(w.strip()) > 1 and w.strip() not in stopwords
    ]
    if not filtered_words:
        return None
    # 拼接为空格分隔的词串
    return " ".join(filtered_words)

# ==================== 4. 批量主程序 ====================
def batch_generate_wordclouds():
    font_path = get_chinese_font()
    if not font_path:
        print("【错误】未在当前系统中检测到常用中文字体,请手动指定 font_path!")
        sys.exit(1)
    print(f"【信息】使用字体文件: {font_path}")

    # 确保输出目录存在
    OUTPUT_DIR.mkdir(parents=True, exist_ok=True)
    stopwords = load_stopwords(STOPWORDS_FILE)

    # 扫描所有的 .txt 文件
    text_files = sorted(list(INPUT_DIR.glob("*.txt")))
    if not text_files:
        print(f"【提示】在目录 {INPUT_DIR} 中未找到任何 .txt 文件。")
        return

    print(f"【开始处理】共找到 {len(text_files)} 个文本文件,开始批量生成...")

    for idx, file_path in enumerate(text_files, 1):
        try:
            # 读取文本内容(优先使用 utf-8,附带回退保护)
            try:
                content = file_path.read_text(encoding="utf-8")
            except UnicodeDecodeError:
                content = file_path.read_text(encoding="gbk", errors="ignore")

            # 分词清洗
            cleaned_text = process_single_text(content, font_path, stopwords)
            if not cleaned_text:
                print(f"[{idx}/{len(text_files)}] 跳过空文本或无有效词文件: {file_path.name}")
                continue

            # 构建词云对象
            wc = WordCloud(
                font_path=font_path,
                width=1200,
                height=800,
                background_color="white",
                max_words=100,
                collocations=False,  # 避免中文词重复
                random_state=42
            )
            wc.generate(cleaned_text)

            # 确定输出文件名,并落盘保存
            output_file = OUTPUT_DIR / f"{file_path.stem}.png"
            wc.to_file(str(output_file))
            print(f"[{idx}/{len(text_files)}] 成功生成: {output_file.name}")

        except Exception as e:
            print(f"[{idx}/{len(text_files)}] 处理文件 {file_path.name} 时发生异常: {e}")

    print("【完成】所有文件的词云图均已批量生成完毕!")

if __name__ == "__main__":
    batch_generate_wordclouds()
代码细节要点解析
file_path.stem的妙用:pathlib.Path对象的stem属性可以直接提取无后缀的文件名(例如document_A.txt的stem为document_A)。通过OUTPUT_DIR / f"{file_path.stem}.png"即可精准生成同名但后缀为.png的图片路径。- 双重编码容错:在批量处理多种来源的文本时,个别文件可能是 Windows 平台下的 GBK 编码。采用先
utf-8、失败后再gbk回退的读取策略,能显著提高批处理流程的鲁棒性。 - 空有效词保护:如果文本文件内容全为空白符号或纯标点,分词过滤后可能得到空列表。此时直接调用
generate()会抛出ValueError: We need at least 1 word to plot a word cloud。代码中的if not cleaned_text: continue避免了整个批处理因单个异常文件而中断。
六、常见问题排查与解决办法
原因:未指定
font_path 或指定的字体文件不存在。确保 get_chinese_font() 能找到有效文件,或者将任意一个开源中文字体(如思源黑体)直接拷贝到代码同级目录下并硬编码路径。
原因:
WordCloud 默认开启了双词搭配统计参数 collocations=True,该参数适用于英文,但在中文通过空格分词拼接的场景下容易引发重复。解决方法是在初始化时设置 collocations=False。
原因:如果在脚本中使用了
matplotlib.pyplot.imshow() 来显示图片而没有及时调用 plt.close(),图元对象会滞留在内存中。本文推荐直接使用 wc.to_file(str(output_file)) 保存图片,完全绕过 matplotlib 绘图窗口,内存占用恒定且速度更快。
七、全流程总结与工程化复查清单
在投入生产或执行大批量文档处理之前,可以通过下方总结卡片进行关键步骤的核对,确保整个批量任务高质、高效地完成。
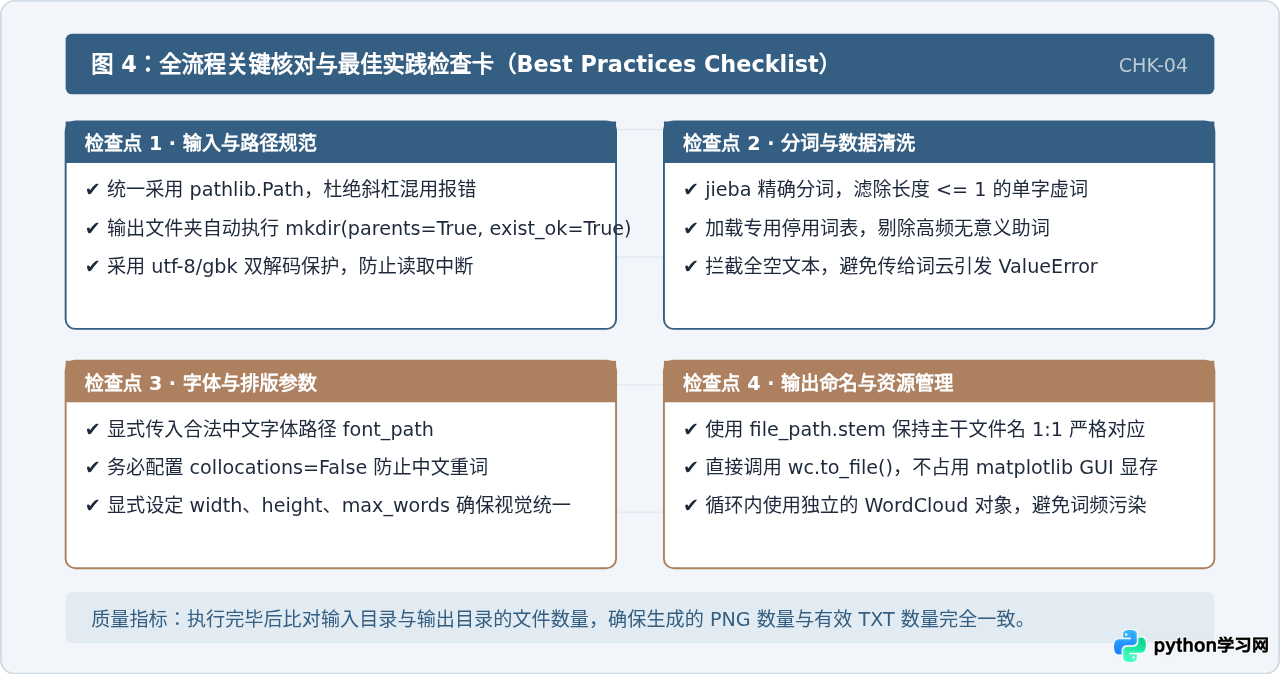
通过本文介绍的自动化脚本与流程规范,即可在数秒内完成数十乃至上百个中文文本的批量词云图绘制任务,整个过程兼具高效性与稳定性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















