



在 C++ 里,很多字符串处理问题表面上是“读写文本”,本质上却是“在字符串和类型之间来回转换”。`stringstream` 之所以常用,就在于它把字符串当成流来处理,让插入、提取、分隔读取和状态检查能放在同一套接口里完成。下面按使用场景拆开讲,既保留基础写法,也补出判断标准,方便你在实际代码里决定它该不该上场。
什么是 stringstream,适合解决哪些问题
stringstream 是 C++ 中用于操作字符串流的类,定义在 <sstream> 头文件中。它可以像 cin、cout 一样处理输入输出,只不过数据源和目标都变成了字符串,因此很适合以下几类任务:
- 把字符串转换为整数、浮点数等数值类型
- 把数值或多种类型拼接成字符串
- 按空格、逗号、冒号等规则解析文本
- 在一次处理过程中顺便检查输入是否有效
使用前通常需要包含这些头文件:
#include <sstream>
#include <string>
#include <iostream>
最基本的构造方式有两种:创建空流,或直接用已有字符串初始化。
std::stringstream ss;  // 默认构造函数
std::stringstream ss("Initial content");  // 带初始字符串的构造函数
如果你的任务只是“拿一段字符串,按顺序读出几个值”,或者“把几个变量拼成一行文本”,`stringstream` 往往是最顺手的方案。
基本输入输出:写入、读取与重用
把数据写入字符串流时,使用插入运算符 <<;从字符串流中提取数据时,使用提取运算符 >>。这套写法和标准输入输出流一致,迁移成本很低。
写入字符串流
std::stringstream ss;
ss << "Hello ";  // 插入字符串
ss << 42;        // 插入整数
ss << " World";  // 追加更多内容
写入完成后,可以通过 ss.str() 取出当前累积的字符串内容。它很适合拼接日志、提示信息或结构化文本。
从字符串流读取
std::stringstream ss("123 456");
int num1, num2;
ss >> num1 >> num2;  // num1 = 123,num2 = 456
这里的读取规则与流一致:默认按空白字符分隔。所以当输入是空格分隔的数据时,`stringstream` 用起来尤其自然。
典型工作流程
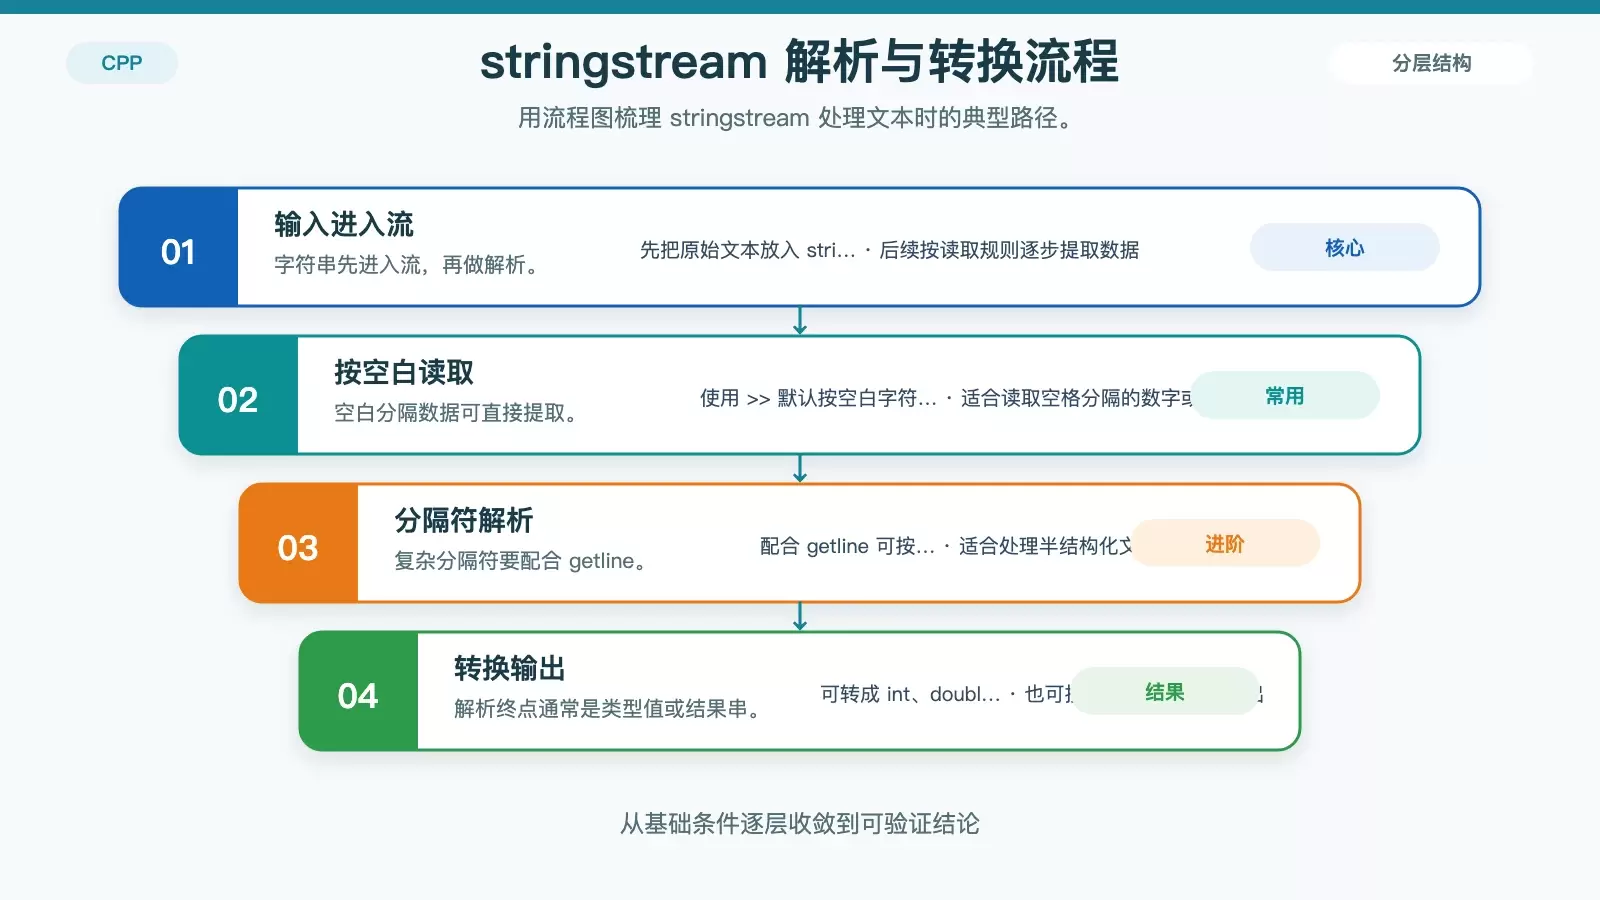
它的常见处理路径可以概括为:先把原始文本放入流,再按目标类型逐步提取,过程中根据状态决定是否继续。
- 输入字符串进入
stringstream - 流按规则解析文本
- 提取出目标数据类型
- 根据成功或失败结果继续处理
流重用时要注意什么
不少问题出在“同一个流对象反复使用”上。`clear()` 只能清除错误标志,不能清空内部文本;如果你还要把内容也重置掉,需要配合 str("") 一起用。
std::stringstream ss;
ss << "初始内容";
ss.clear();  // 重置错误标志
ss.str("");  // 清除实际内容
这也是 `stringstream` 最容易被误用的地方之一:只调 clear(),下一次读取时旧内容还在。
类型转换与文本解析怎么写
`stringstream` 的核心价值,不只是“像流一样读写字符串”,更在于它能把转换和解析合并到一个步骤里完成。相比手动拆分字符串后再逐项转换,这种写法更集中,也更容易统一处理错误。
字符串转整数与浮点数
std::string str = "42";
std::stringstream ss(str);
int number;
ss >> number;  // number = 42
std::string str = "3.14159";
std::stringstream ss(str);
double value;
ss >> value;  // value = 3.14159
这类写法简单直接,特别适合处理来自配置、命令行参数或文本输入的数值内容。
数值转字符串
std::stringstream ss;
int number = 123;
ss << number;
std::string str = ss.str();  // str = "123"
如果你要拼接多种类型,`stringstream` 比手动调用多个转换函数更统一:
std::stringstream ss;
int age = 30;
double height = 1.75;
std::string name = "John";

ss << "姓名:" << name
   << ", 年龄:" << age
   << ", 身高:" << height;

std::string result = ss.str();
解析带分隔符的复杂字符串
当文本不再只是空格分隔,而是包含冒号、逗号等符号时,可以把 stringstream 和 std::getline() 配合使用。
std::stringstream ss("姓名:约翰,年龄:30,城市:纽约");
std::string key, value;

while(std::getline(ss, key, ':') && std::getline(ss, value, ',')) {
    std::cout << "键:" << key << ", 值:" << value << std::endl;
}
这种模式适合半结构化文本:字段数量不多、格式基本稳定,但不值得专门上更重的解析器。
CSV 与结构化记录解析
对简单 CSV 行,逐项读取通常已经够用:
std::vector<std::string> splitCSV(const std::string& line) {
    std::vector<std::string> result;
    std::stringstream ss(line);
    std::string item;

    while (std::getline(ss, item, ',')) {
        result.push_back(item);
    }

    return result;
}
如果要把一行文本直接映射到结构体,也可以继续沿用这套思路:
struct Person {
    std::string name;
    int age;
    double salary;
};

Person parsePerson(const std::string& data) {
    std::stringstream ss(data);
    Person p;

    std::getline(ss, p.name, ',');
    ss >> p.age;
    ss.ignore(); // 跳过逗号
    ss >> p.salary;

    return p;
}

int main() {
    std::string personData = "John Doe,35,50000.50";
    Person person = parsePerson(personData);
}
但也要注意,`stringstream` 并不是完整 CSV 解析器。遇到引号、转义、嵌套分隔符等情况,它的能力就不够了。
流状态检查与安全转换
教程里最容易被忽略的一环,就是流状态。`stringstream` 的读取失败并不会自动抛错,很多 bug 恰恰来自“转换失败了,但代码还在继续跑”。
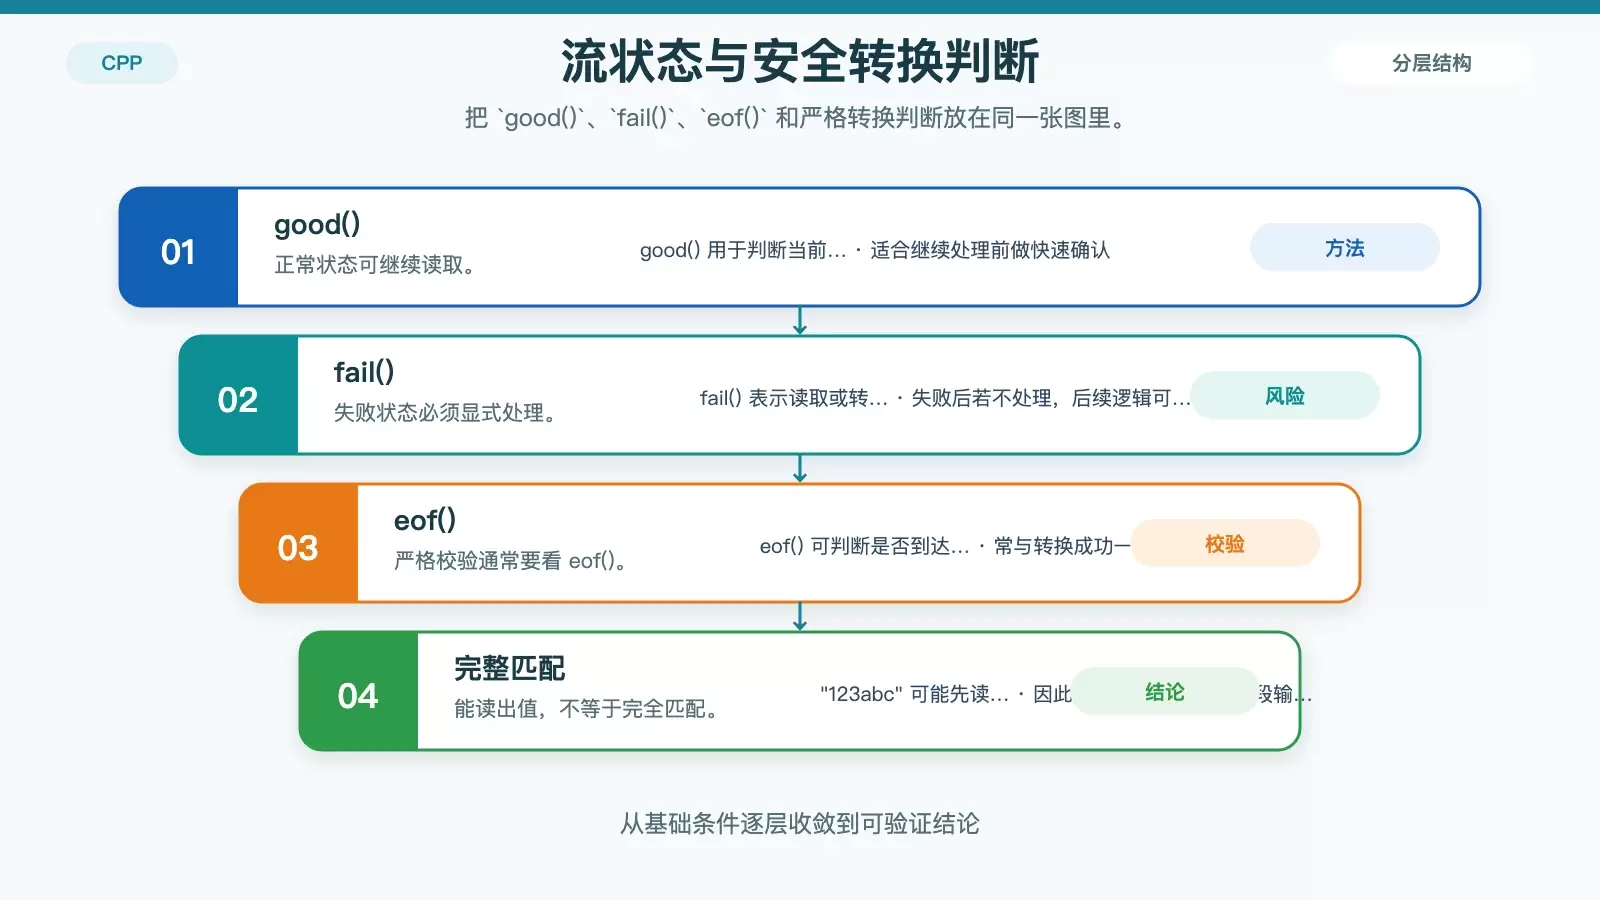
几个常用状态方法
| 方法 | 描述 | 使用方式 |
|---|---|---|
good() |
检查是否没有错误发生 | if(ss.good()) |
fail() |
检查是否发生了错误 | if(ss.fail()) |
eof() |
检查是否到达流的末尾 | if(ss.eof()) |
最基础的错误处理
std::stringstream ss("不是一个数字");
int value;

if (!(ss >> value)) {
    std::cerr << "转换失败" << std::endl;
}
这类写法比“先读,再假定成功”稳妥得多,尤其是在处理外部输入时。
安全转换为什么常要配合 eof()
仅仅 ss >> value 成功,并不代表整段输入都合法。例如字符串 "123abc" 仍可能先读出 123。如果你想确保整段输入完整匹配目标类型,通常还要检查是否已经到达末尾。
bool validateConversion(const std::string& input) {
    std::stringstream ss(input);
    int value;

    // 检查是否可以进行转换
    return (ss >> value) && ss.eof();
}
这一点在输入校验、配置解析、接口参数检查中非常实用。
封装成可复用的安全转换函数
bool safeConvert(const std::string& input, int& result) {
    std::stringstream ss(input);
    return !!(ss >> result);
}

int main() {
    std::string str = "456";
    int number;

    if (safeConvert(str, number)) {
        std::cout << "已转换:" << number << std::endl;
    } else {
        std::cout << "转换失败" << std::endl;
    }

    return 0;
}
如果你的项目里会反复做类似转换,把检查逻辑封装起来通常更容易维护。
完整示例与性能取舍
先看一个综合示例,它把写入、读取和后续处理放在了一起:
#include <sstream>
#include <iostream>
#include <vector>

int main() {
    std::stringstream ss;
    std::vector<int> numbers;

    // 输入多个值
    ss << "10 20 30 40 50";

    int num;
    while (ss >> num) {
        numbers.push_back(num);
    }

    // 输出处理后的数据
    for (int val : numbers) {
        std::cout << val << " ";
    }

    return 0;
}
再看一个更短的“写入后再读取”的例子:
#include <sstream>
#include <iostream>
#include <string>

int main() {
    std::stringstream ss;

    // 写入流
    ss << "Temperature: " << 25 << " Celsius";

    // 从流读取
    std::string prefix;
    int temperature;

    ss >> prefix >> temperature;

    std::cout << "解析结果:" << prefix << " " << temperature << std::endl;

    return 0;
}
这两个例子都说明了同一件事:`stringstream` 的优势在于接口统一、代码可读性高,尤其适合中等复杂度的字符串处理。
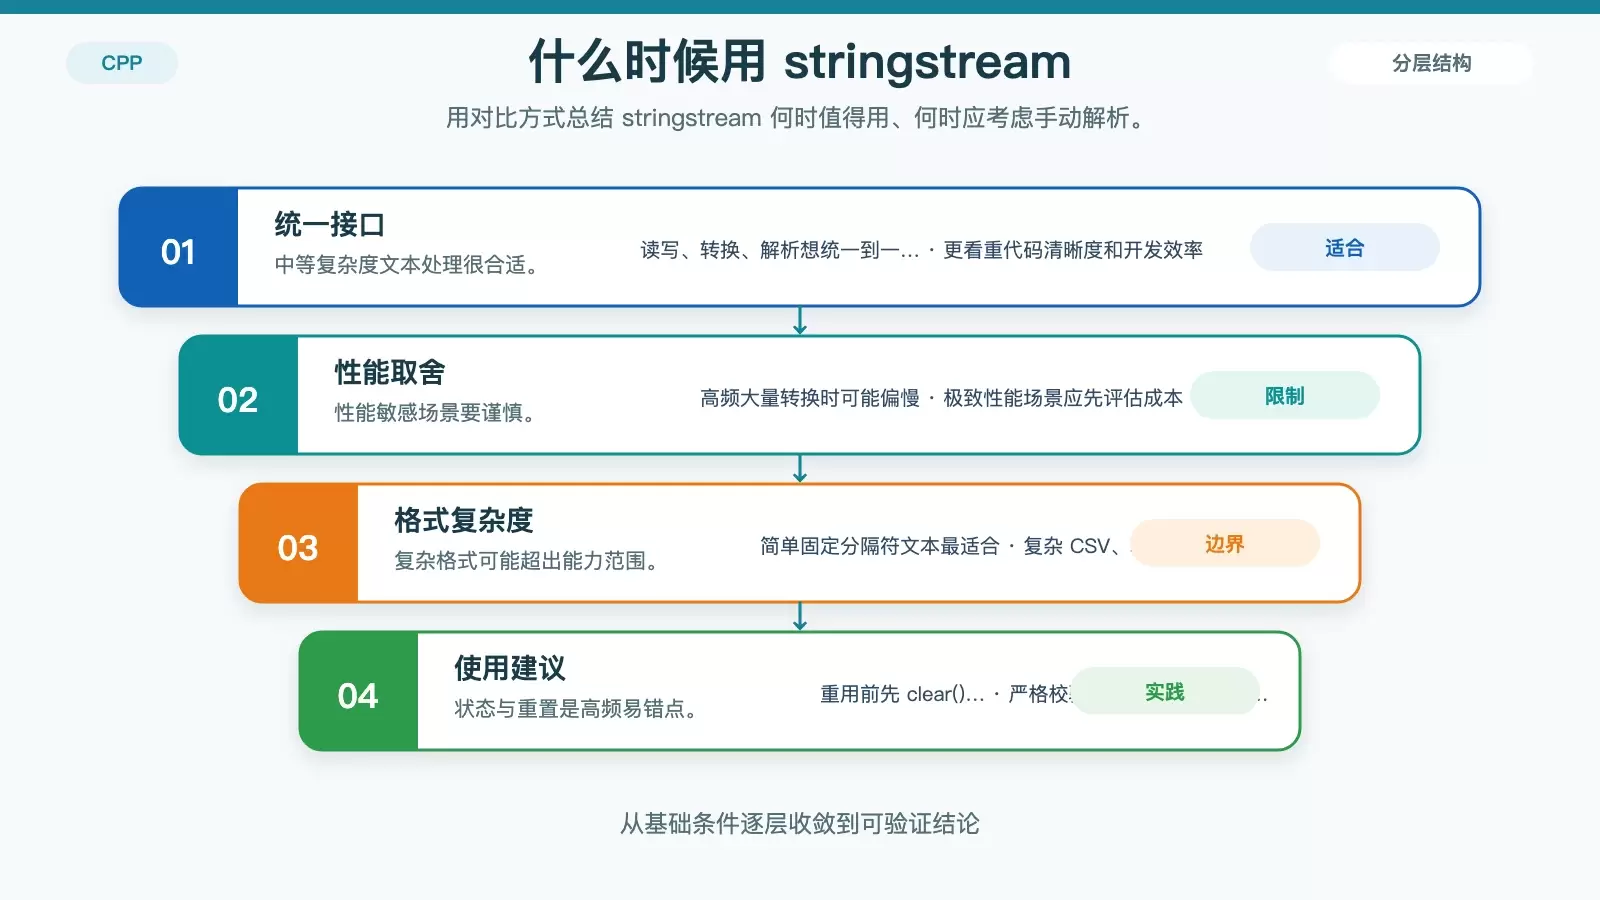
什么时候适合用 stringstream
- 需要把读写、转换、解析放在同一套流式接口里完成
- 输入格式相对简单,按空白或固定分隔符就能拆开
- 更看重代码清晰度和开发效率,而不是极致性能
什么时候要谨慎使用
- 需要高频、大量地做类型转换
- 对性能非常敏感
- 文本格式复杂,已经超出简单分隔读取的范围
原文也提到这一点:字符串流虽然方便,但和手动解析相比可能更慢。因此在高性能场景下,应该优先评估是否有更直接的方案。
可以直接记住的实践要点
- 操作完成后检查流状态
- 重用流前先
clear(),必要时再配合str("") - 通过
str()获取当前字符串内容 - 做严格校验时,把转换结果和
eof()一起判断
如果你的目标是把“文本输入”快速转成“可用数据”,`stringstream` 依然是 C++ 里很稳的一把基础工具。它不一定是最快的,但在很多教程、练习题和业务代码中,往往是最容易写对、也最容易读懂的方案。















