



在 C++ 里,std::queue 的重点通常落在 push、pop 和 front 这些操作上,但真正决定代码是否稳妥的,往往是看似不起眼的 empty()。它不只是“判断一下有没有元素”这么简单,还牵涉到表达意图、避免未定义行为,以及在不同容器和并发场景下写出更可靠代码。下面就围绕这个函数,把它为什么值得单独拿出来讲、实际应该怎么用,以及哪些地方最容易踩坑,系统梳理一遍。
为什么判断空状态时应优先用 empty()
复杂度保证与接口语义
queue::empty() 的作用很直接:检查队列是否为空,返回 bool。如果队列没有元素,返回 true;否则返回 false。它本身不会修改队列内容,因此是一个常量成员函数。
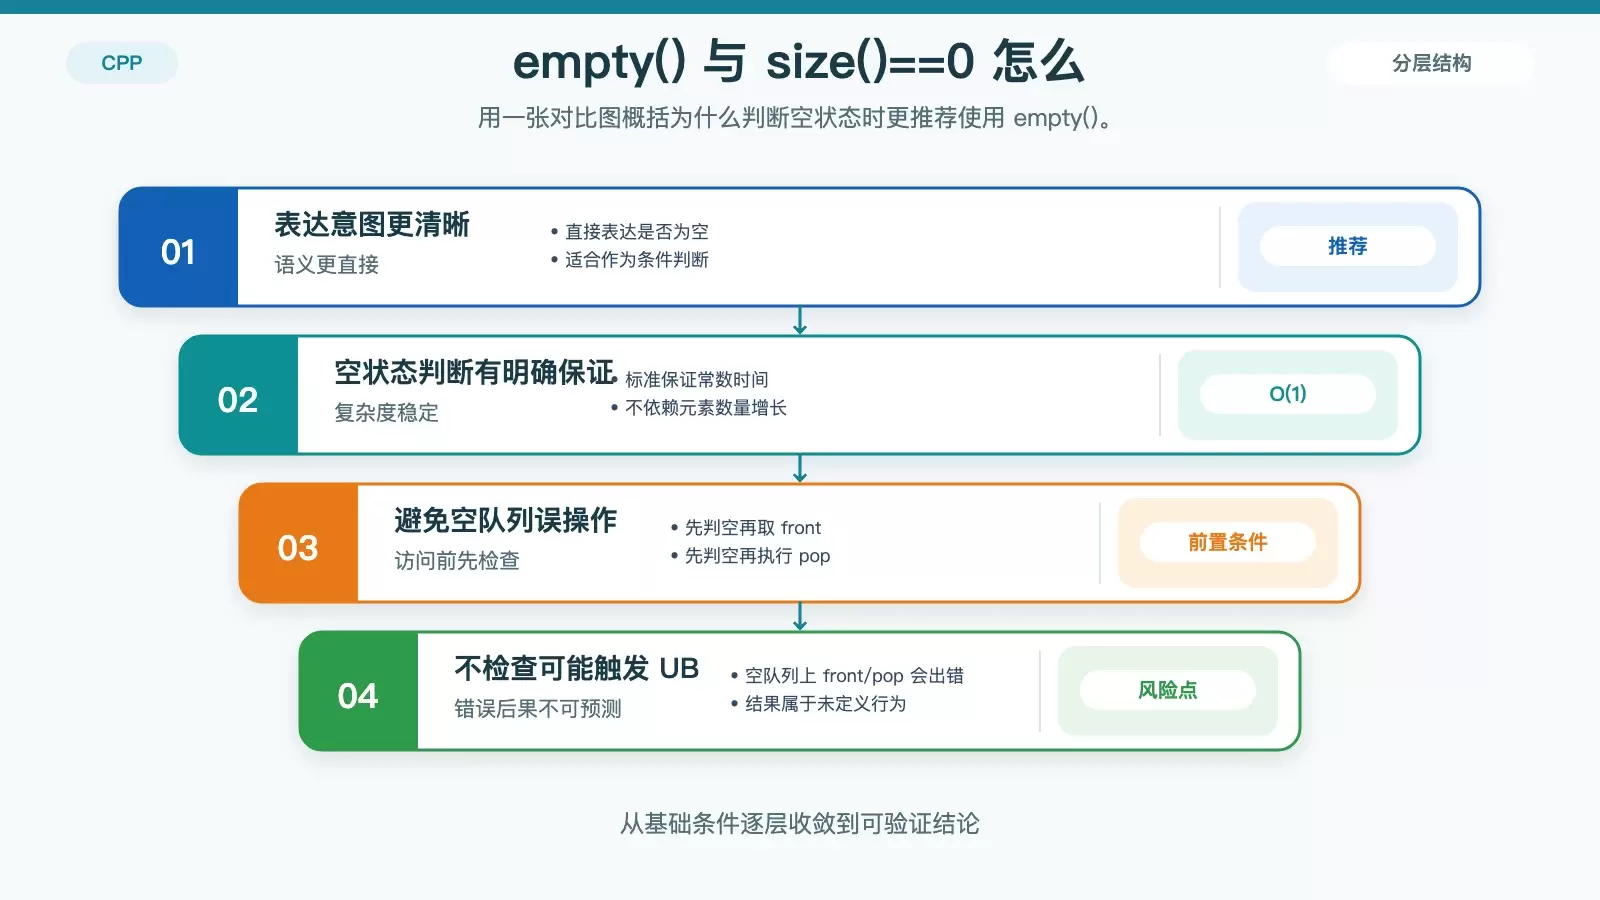
在标准库里,empty() 的时间复杂度被明确保证为常数时间,也就是 O(1)。这意味着无论队列中有 0 个元素还是十亿个元素,这个判断的成本都基本一致。
与之相比,size() 虽然在现代标准库的大多数常见容器里也能做到 O(1),但它表达的是“元素个数”,而不是“是否为空”。从代码语义上看,下面这两种写法逻辑等价,但传达的信息并不一样:
// 版本A:使用 size()
while (myQueue.size() > 0) {
    process(myQueue.front());
    myQueue.pop();
}

// 版本B:使用 empty()
while (!myQueue.empty()) {
    process(myQueue.front());
    myQueue.pop();
}
第二种写法更直接。读代码的人一眼就能明白:这里只关心队列是不是空,而不是它到底有几个元素。对于维护者来说,这种表达力很重要,尤其是在条件越来越复杂、容器类型可能替换的代码里。
还有一点容易被忽略:从历史和通用性角度看,empty() 也是更稳妥的选择。C++11 之前,某些实现里的 std::list::size() 可能是 O(n);而在一些特殊容器或较旧实现里,size() 甚至不一定总是适合作为空状态判断接口。即便今天标准容器普遍已经对 size() 做了更严格的复杂度约束,养成优先使用 empty() 的习惯仍然是更清晰、更通用的做法。
避免空队列上的未定义行为
empty() 最重要的价值,其实不是性能,而是安全。对空队列调用 front()、back() 或 pop(),都会导致未定义行为。程序可能崩溃,也可能读取到错误数据,或者表现出不可预测的结果。
std::queue<int> q;
// 错误!未定义行为。队列是空的,没有“第一个元素”。
int value = q.front();

// 正确做法
if (!q.empty()) {
    int value = q.front(); // 安全访问
    q.pop(); // 安全弹出
} else {
    // 处理队列为空的情况,例如记录日志、返回错误码或进行初始化
    std::cout << "Queue is empty, cannot access front element." << std::endl;
}
这也是为什么很多有经验的 C++ 开发者会把 empty() 看成一个“守门员”:凡是要读取队首元素、弹出元素,都应该先让它把关。写对一次不难,难的是在长期开发里始终保持这个前置判断习惯。
empty() 在实际开发中的典型用法
循环处理队列中的全部任务
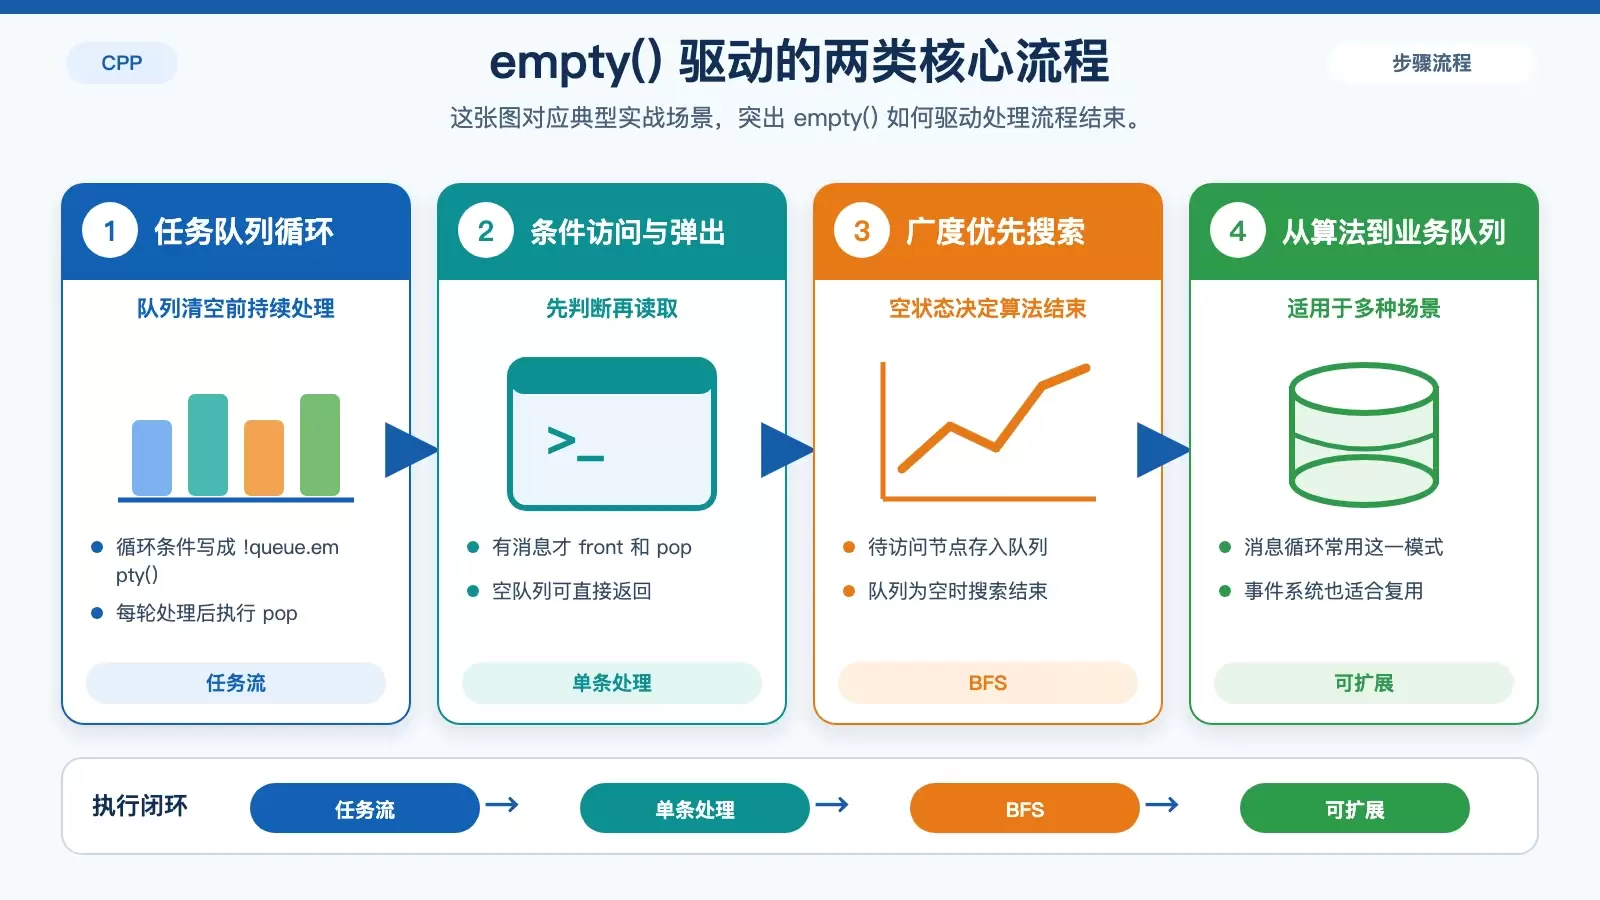
这是 std::queue 最经典的使用方式,消息循环、任务队列、事件系统、广度优先搜索都在用这一模式。写法也很固定:只要队列不空,就继续处理。
#include <queue>
#include <iostream>

void processTask(int task) {
    std::cout << "Processing task: " << task << std::endl;
    // 模拟任务处理...
}

int main() {
    std::queue<int> taskQueue;

    // 模拟一些任务入队
    for (int i = 1; i <= 5; ++i) {
        taskQueue.push(i);
    }

    // 核心循环:使用 empty() 作为循环条件
    while (!taskQueue.empty()) {
        int currentTask = taskQueue.front(); // 安全,因为循环条件保证了非空
        processTask(currentTask);
        taskQueue.pop(); // 移除已处理的任务
    }

    std::cout << "All tasks processed. Queue is empty." << std::endl;
    return 0;
}
这种写法的好处有两层。第一,它把“是否还有任务”作为循环本身的退出条件,逻辑紧凑。第二,它适合动态变化的数据流。如果你只是先读取一次 size(),再按固定次数循环,那么中途新增的任务可能根本不会被这轮处理覆盖;而 while (!taskQueue.empty()) 会持续处理到队列真正清空为止。
条件访问与条件弹出
很多时候,队列并不是持续有数据的。比如消息收发、用户输入缓冲、网络包处理,都可能经常遇到“当前没有可处理对象”的情况。此时最稳妥的模式就是先判断,再访问。
#include <queue>
#include <string>
#include <iostream>

std::queue<std::string> messageQueue;

// 模拟接收消息的函数
void receiveMessage(const std::string& msg) {
    messageQueue.push(msg);
}

// 处理消息的函数
void processMessages() {
    // 可能被多次调用,每次处理一条消息
    if (!messageQueue.empty()) {
        std::string msg = messageQueue.front();
        messageQueue.pop();
        std::cout << "[Processed]: " << msg << std::endl;
        // 进行实际的消息处理逻辑...
    } else {
        // 队列为空是正常状态,不是错误。可以记录调试信息或直接返回。
        std::cout << "[Info]: No messages to process." << std::endl;
    }
}
这里有一个很实用的判断标准:队列为空,很多时候并不代表异常,而只是当前没有工作可做。因此空分支不一定要写成报错逻辑,也可以是安静返回、记录调试信息,或者等待下一次调度。
算法实现中的循环驱动条件
在图论和搜索类算法里,empty() 经常直接决定算法是否结束。最典型的例子就是广度优先搜索 BFS:队列里存放待访问节点,只要队列不空,搜索就继续推进。
#include <queue>
#include <vector>
#include <iostream>

void bfs(int startNode, const std::vector<std::vector<int>>& graph) {
    int numNodes = graph.size();
    std::vector<bool> visited(numNodes, false);
    std::queue<int> q;

    visited[startNode] = true;
    q.push(startNode);

    // 核心循环:当队列不为空时,持续探索
    while (!q.empty()) {
        int currentNode = q.front();
        q.pop();
        std::cout << "Visiting node: " << currentNode << std::endl;

        // 遍历当前节点的所有邻居
        for (int neighbor : graph[currentNode]) {
            if (!visited[neighbor]) {
                visited[neighbor] = true;
                q.push(neighbor); // 将未访问的邻居入队
            }
        }
    }
    // 当队列为空时,说明从startNode可达的所有节点都已访问完毕
}
在这类代码里,empty() 不只是一个保护条件,它本身就是算法状态的一部分。队列为空,意味着没有后续节点可扩展,搜索自然结束。迷宫求解、社交图遍历、网络爬虫任务调度等场景,本质上都遵循这一思路。
std::queue 的底层实现与 empty() 的工作方式
std::queue 并不是一个独立存储结构,而是一个容器适配器。默认情况下,它基于 std::deque 实现,也可以基于满足接口要求的其他底层容器,例如 std::list。
这也决定了 queue::empty() 的实现非常直接:它通常只是把请求转发给底层容器。
// queue 的 empty() 成员函数典型实现(概念性)
bool empty() const {
    return c.empty(); // ‘c' 是 queue 内部保护的底层容器对象
}
其中 c 就是内部持有的实际容器对象。因此,queue::empty() 的复杂度和行为,最终取决于底层容器的 empty()。对默认的 std::deque 来说,这个判断通常只需要检查内部状态,因此是 O(1)。
理解这一点有两个实际价值。其一,你知道它为什么足够快:因为大多数实现根本不需要遍历任何元素。其二,如果你在自定义 queue 的底层容器,或者自己写一个适配器,就必须确保底层结构提供高效而稳定的 empty()、front()、back()、push_back() 和 pop_front() 等接口。
例如,一个简单链表队列的 empty() 往往也只是判断头指针是否为空:
template<typename T>
class SimpleQueue {
private:
    struct Node {
        T data;
        Node* next;
    };
    Node* head;
    Node* tail;
public:
    SimpleQueue() : head(nullptr), tail(nullptr) {}
    // ...
    bool empty() const { // 注意 const 关键字
        return head == nullptr;
    }
    // ...
};
这里的重点不是实现有多复杂,而是接口语义要明确:empty() 不应该改动对象状态,并且应该尽可能维持常数时间。
最容易踩坑的地方:并发、误用与性能误判
empty() 和 size() == 0 到底怎么选
如果只是单纯判断容器里有没有元素,结论很简单:优先用 empty()。原因主要有三点。
- 表达更直接。
empty()就是在问“空不空”。 - 更通用。它适用于标准容器、容器适配器以及很多第三方容器实现。
- 更符合 C++ 社区长期形成的编码习惯和风格指南。
对应的经验法则也很实用:如果你关心的是“有没有”,就用 empty();如果你关心的是“有多少”,才用 size()。
多线程里的“先检查再操作”并不天然安全
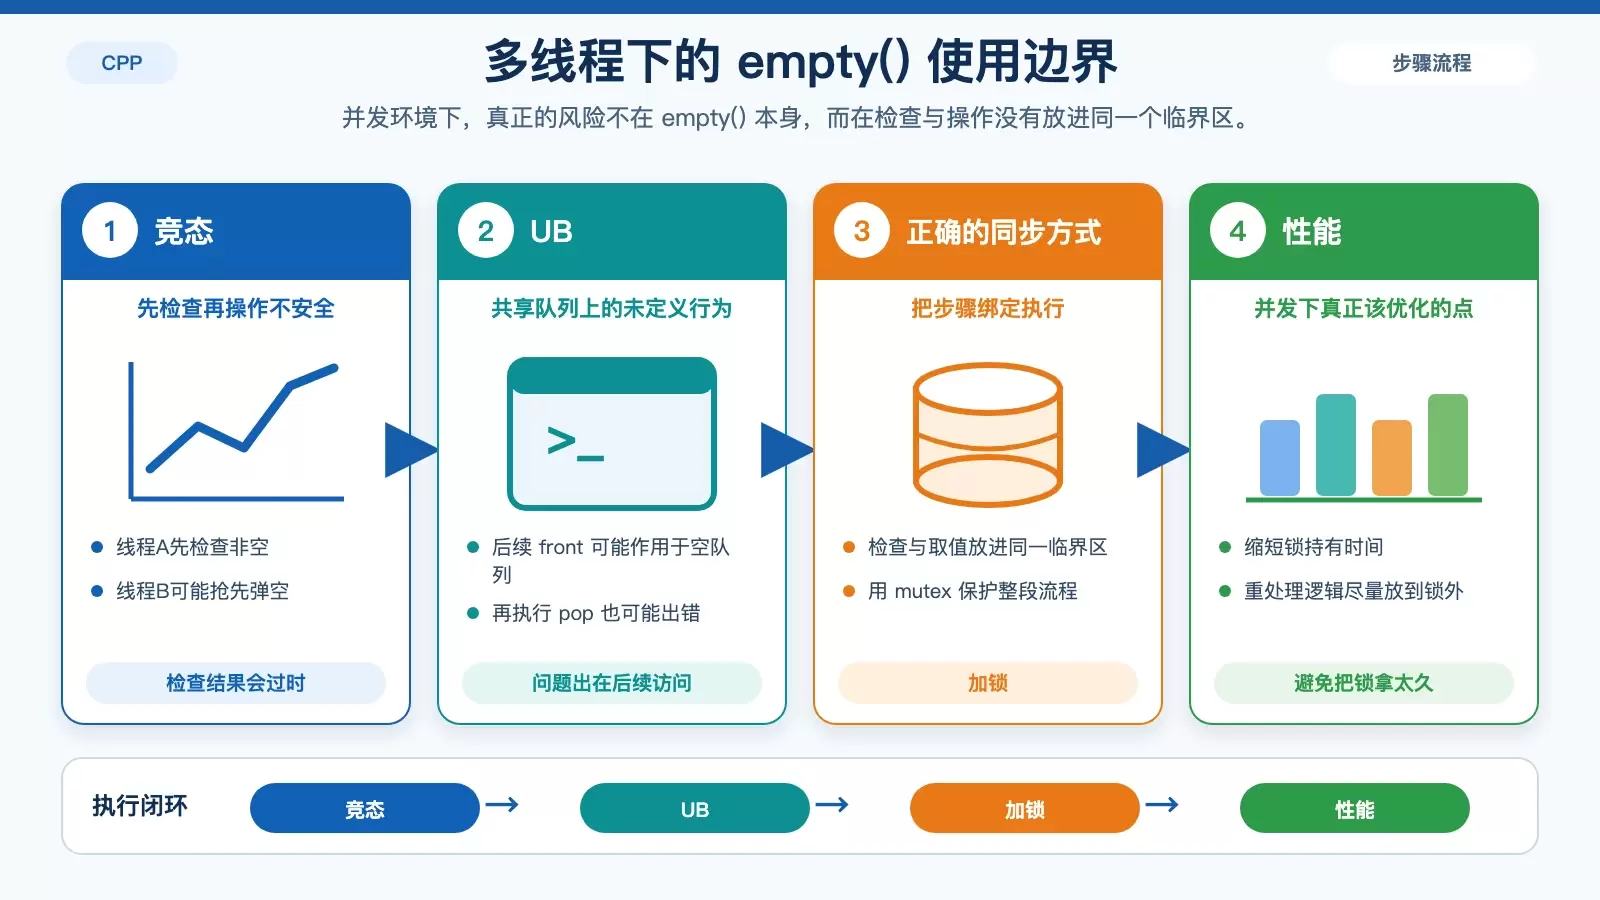
这是很多人刚接触并发容器处理时最容易误判的地方。empty() 自己没有问题,但“先判断非空,再调用 front() 和 pop()”这一串动作,如果作用在共享队列上,必须视为一个整体。
// 危险的非线程安全代码
if (!sharedQueue.empty()) {          // 线程A检查,发现非空
    // 此时,线程B可能执行了 sharedQueue.pop(),使队列变空
    auto item = sharedQueue.front(); // 线程A访问,可能UB!
    sharedQueue.pop();               // 线程A弹出,可能UB或逻辑错误!
}
问题在于,线程 A 刚检查完队列非空,线程 B 可能立刻把最后一个元素弹走。这样线程 A 后面的 front() 和 pop() 就可能落在空队列上,仍然触发未定义行为。
正确做法是把检查和访问放在同一个临界区内,用互斥锁保护起来:
// 简化的线程安全版本示例
#include <mutex>
std::mutex queueMutex;

void threadSafeProcessMessages() {
    std::lock_guard<std::mutex> lock(queueMutex); // 加锁
    if (!messageQueue.empty()) {
        std::string msg = messageQueue.front();
        messageQueue.pop();
        // 注意:处理消息(msg)的过程最好在锁外进行,以减少锁的持有时间。
        // 这里先解锁,再处理。
        lock.~lock_guard(); // 手动释放锁(不推荐,仅示意)。更好的做法是定义作用域。
        std::cout << "[Processed]: " << msg << std::endl;
        // ... 处理 msg
    }
    // lock_guard 在作用域结束时自动释放锁
}
需要特别指出的是,上面这段代码虽然保留了原始示意,但其中 lock.~lock_guard() 这种手动调用析构的写法并不推荐,真实项目里应该通过额外作用域或改用 std::unique_lock 来控制解锁时机。核心原则只有一个:检查和取值必须在同一份同步保护下完成。
性能上真正该关心什么
围绕 empty() 的性能讨论经常被放大,但在大多数项目里,它本身几乎不会成为瓶颈。因为这个函数通常足够简单,编译器也很容易把它内联掉。
真正更值得关注的,往往是这几件事:
- 队列底层容器是否适合你的插入、删除模式。
- 循环里是否存在不必要的重复判断和冗余访问。
- 并发场景下锁的持有时间是否过长。
换句话说,empty() 通常不是性能热点,错误的容器选择、过粗的锁粒度,或者不合理的处理流程,才更容易影响整体吞吐。
可直接套用的实践规则
std::queue::empty() 看似很小,但它背后对应的是一整套稳定的 C++ 容器使用习惯。整理成可执行规则,基本可以归纳为以下几条:
- 检查空状态时,优先使用
empty(),不要把size() == 0当成默认写法。 - 在调用
front()、back()、pop()之前,先确认容器非空,这是避免未定义行为的基本要求。 - 处理整队元素时,优先采用
while (!container.empty())这一惯用模式。 - 多线程访问共享队列时,把“检查 + 读取/弹出”当成一个原子流程,用锁或专门的线程安全队列保护。
- 理解
queue是适配器,它的empty()效率依赖底层容器,但在正常标准实现里通常都是 O(1)。 - 把这套习惯推广到其他标准容器上,例如
vector、map、set、string等,同样成立。
例如,对 std::vector 和 std::string,同样更推荐写成 vec.empty()、str.empty(),而不是反复比较 size() 或 length() 是否为 0。这不仅统一了风格,也能让代码在表达上更自然。
std::vector<int> vec;
// 在使用 std::accumulate 等算法前,检查空容器是良好的防御性编程
if (!vec.empty()) {
    int sum = std::accumulate(vec.begin(), vec.end(), 0);
}
// 虽然 accumulate 对空范围也能工作(返回初始值0),但某些算法或操作可能不是。
回到 std::queue 本身,empty() 的价值并不在于它有多复杂,而在于它把“状态判断”“访问前置条件”和“代码意图”这三件事压缩成了一个非常明确的接口。它小,但绝不是可有可无的细节。写队列代码时,把这个判断放在正确的位置,往往比你多记住几个 STL 成员函数更重要。















