



很多 C++ 程序跑得慢,并不一定是算法本身有问题,常见瓶颈往往先出在编译参数没开、容器没选对,或者系统环境没有为高负载场景做好准备。本文按 CentOS 上最常见的调优路径,拆成编译器、代码、系统、分析工具、硬件与库五部分,方便你先做低成本优化,再判断哪些改动真正值得投入。
先从编译器选项拿到第一波性能收益
如果你还没有系统做过优化,编译参数通常是最省力的一步。它的好处是不用改业务代码,就能直接释放一部分性能潜力。
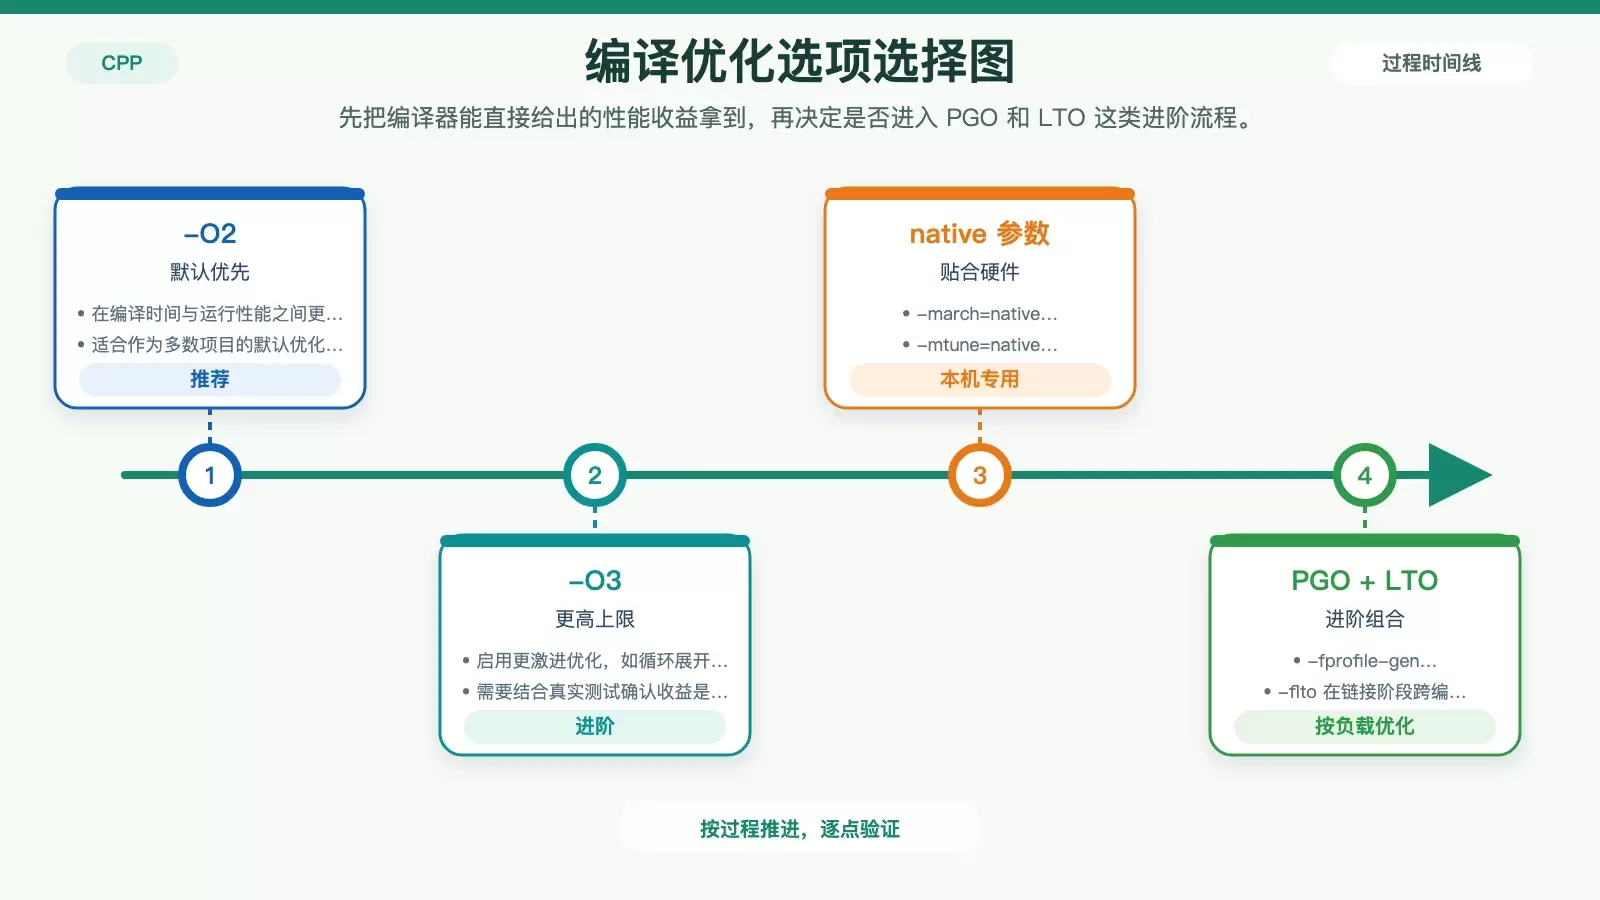
基础优化选项怎么选
大多数场景下,-O2 是更稳妥的默认选择,在编译时间和运行性能之间比较均衡。如果你希望进一步压榨性能,可以尝试 -O3,它会启用更激进的优化,例如循环展开和更多内联。
和优化等级一起使用的,还有针对本机 CPU 的编译参数:
-march=native:针对当前 CPU 架构生成代码,例如 x86-64 上可利用 AVX2 等指令集。-mtune=native:根据当前 CPU 微架构调整调度和执行策略。
如果程序部署环境和编译环境一致,这两个参数通常值得开启;如果需要跨机器分发二进制,则要谨慎使用。
PGO 和 LTO 适合什么场景
当基础优化已经开启,下一步可以考虑更偏工程化的编译技术。
PGO(Profile-Guided Optimization) 的流程是先采样、再重编译:
-fprofile-generate
-fprofile-use
先用 -fprofile-generate 编译程序,运行实际工作负载收集数据,再使用 -fprofile-use 重新编译。这样编译器就能基于真实执行路径去优化分支预测、函数内联等细节。
LTO(Link Time Optimization) 则是在链接阶段继续优化:
-flto它可以跨编译单元做全局分析,减少冗余代码,适合模块较多、函数调用关系复杂的项目。
代码层优化重点看算法、内存和并行方式
编译器只能优化你已经写出来的逻辑,真正决定上限的,还是算法选择、数据结构布局和热点路径的写法。
先确认算法和容器是不是选错了
如果一个热点路径主要在查找和遍历,容器选型会直接影响复杂度和缓存命中率。
- 查找场景下,
std::unordered_map可以替代std::map,把查找复杂度从O(log n)降到O(1)。 - 顺序存储优先考虑
std::vector,通常比链表更友好,因为它减少了内存碎片和指针跳转。
这类改动往往不是语法层优化,而是直接改变程序的数据访问模式,收益通常比微调表达式更明显。
减少无谓分配和对象拷贝
内存分配频繁、对象复制过多,是不少 C++ 程序的隐性开销来源。常见做法包括:
- 能用栈内存就尽量少用堆内存。
- 对可增长容器提前预留空间,例如使用
std::vector::reserve。 - 使用
std::unique_ptr、std::shared_ptr管理生命周期,降低泄漏风险。 - 传递大对象时优先使用
const&,避免不必要的拷贝。
如果分析工具显示时间耗在分配器或构造/析构路径,这一节通常就是优先排查项。
循环热点要减少重复计算
循环中的一点点重复工作,在高频执行下都会被放大。原文中的例子很典型:
for(int i=0; i<n; i++) arr[i] = i*i;可以改写为:
int square = 0; for(int i=0; i<n; i++, square+=2*i+1) arr[i] = square;这种写法通过递推减少乘法开销。除此之外,也可以考虑:
- 使用
#pragma unroll提示编译器展开循环。 - 在热点代码中手动展开循环,降低循环控制成本。
不过这类优化要建立在性能分析结果之上,避免为了“看起来更快”而牺牲可维护性。
多核机器上别忽略并行化
如果任务天然可分割,单线程优化到一定程度后,并行化通常才是下一步的主要增益来源。
- OpenMP 可以直接用
#pragma omp parallel for并行化循环。 - C++11 线程库适合构建线程池和更细粒度的并发任务管理。
要注意的是,并行化并不总是稳赚不赔。任务划分、锁竞争、缓存一致性开销,都会影响最终收益。
CentOS 系统参数会影响程序能跑多快
当程序已经接近业务负载,系统默认参数往往会先成为限制条件,尤其是在高并发、网络服务或内存敏感型程序里更明显。
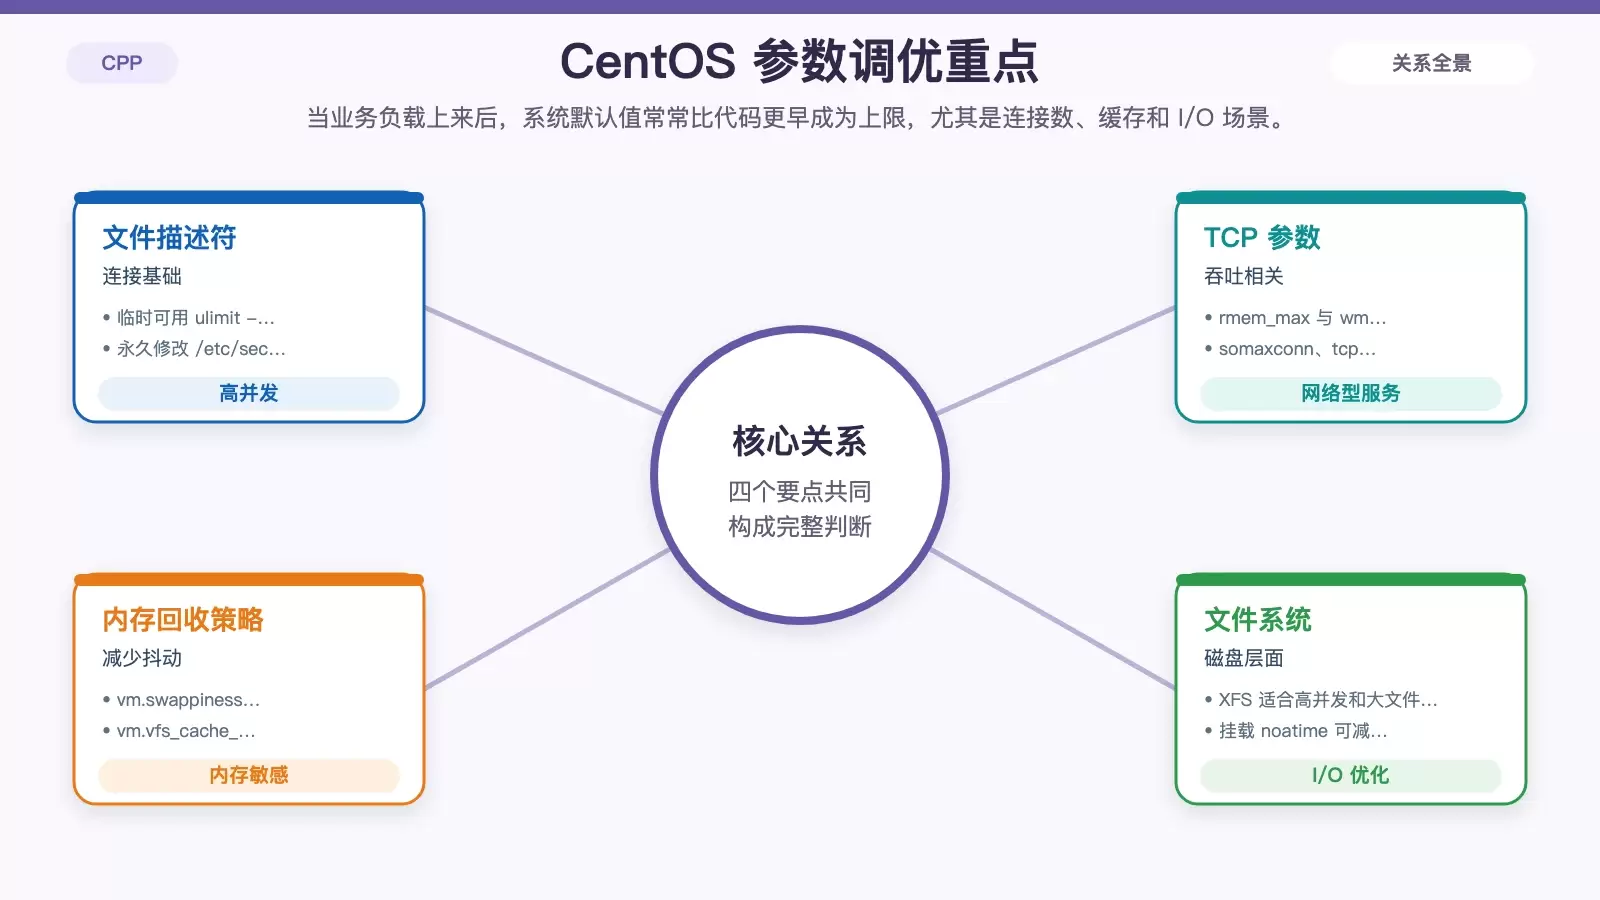
先检查文件描述符上限
高连接数程序首先会碰到文件描述符限制。临时调整可以直接执行:
ulimit -n 65535如果要永久生效,则修改 /etc/security/limits.conf,加入:
* soft nofile 65535
* hard nofile 65535
网络服务重点关注 TCP 和内核队列参数
对于网络型 C++ 服务,CentOS 默认 TCP 参数常常偏保守,可以按需提高缓冲区和连接队列上限:
sysctl -w net.core.rmem_max=16777216
sysctl -w net.core.wmem_max=16777216
sysctl -w net.core.somaxconn=65535
sysctl -w net.ipv4.tcp_max_syn_backlog=65535
sysctl -w net.ipv4.ip_local_port_range="1024 65535"
这些参数分别影响接收/发送缓冲区、监听队列长度、半连接队列和可用本地端口范围。是否需要调大,取决于你的连接模型和流量特征。
内存回收策略和文件系统也会拖慢程序
内存敏感场景下,可以适当降低交换倾向,把更多物理内存留给业务进程:
- 将
vm.swappiness调整到 10,减少内存交换。 - 将
vm.vfs_cache_pressure调整到 50,减缓内核回收文件缓存的速度。
如果程序 I/O 较重,还要考虑文件系统和挂载方式。XFS 在高并发、大文件场景下表现较好,EXT4 在默认优化后也足够实用。挂载时加上 noatime 可以减少访问时间更新开销:
mount -o noatime /dev/sda1 /mnt优化前后都要用工具验证瓶颈
性能调优最容易犯的错误,就是凭感觉改代码。更可靠的办法是先定位热点,再确认每一步调整到底带来了什么变化。
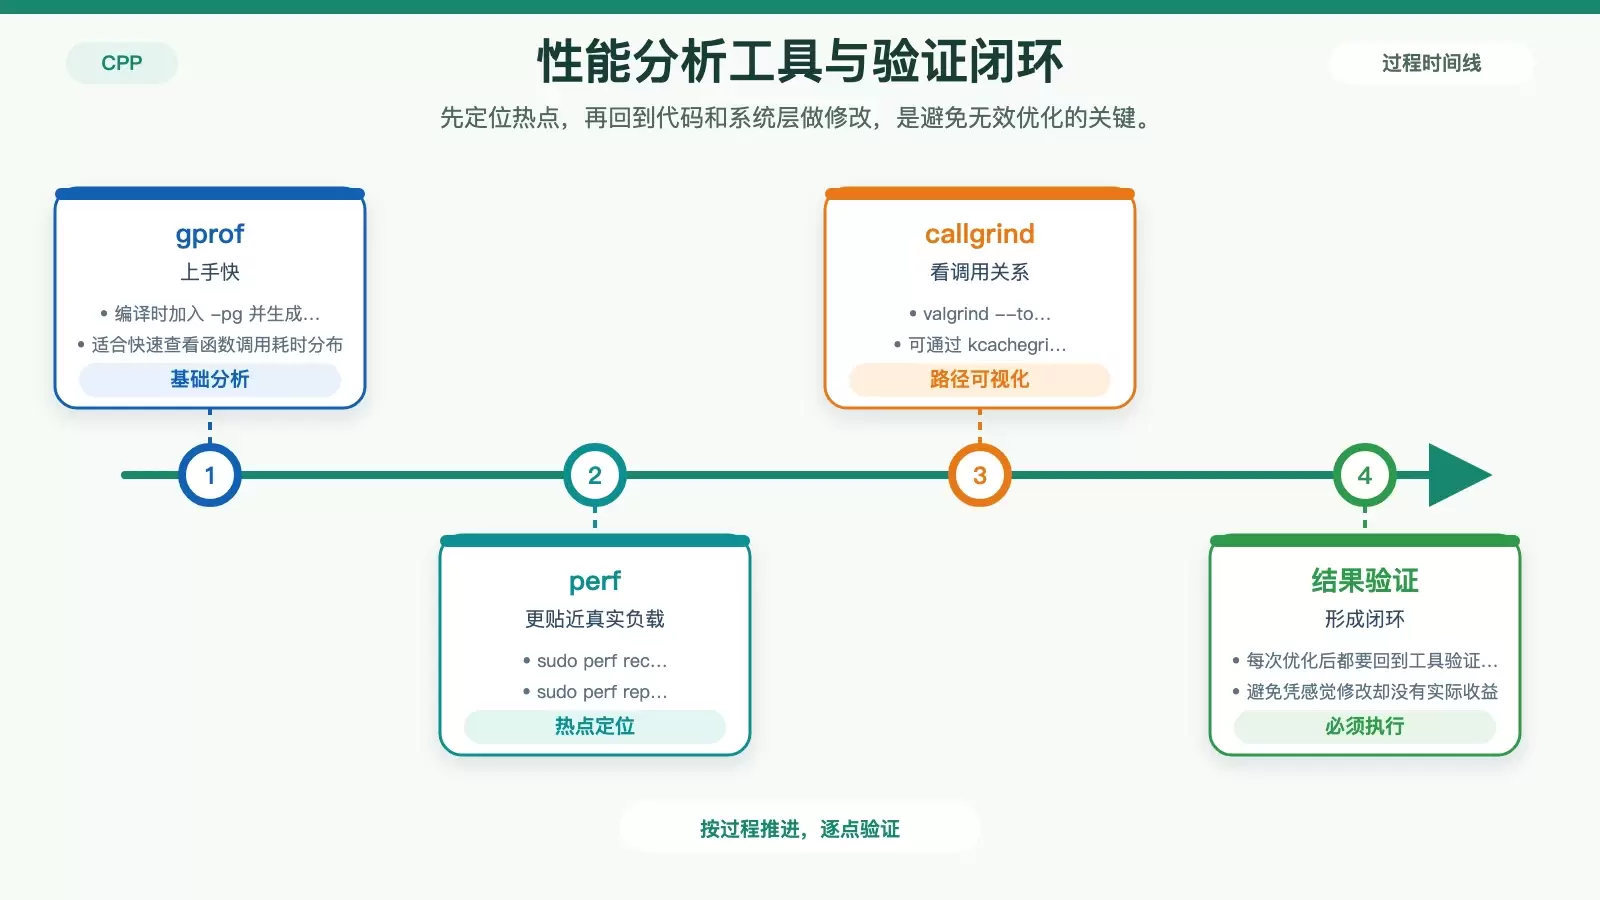
用 gprof 做基础函数耗时分析
如果你需要快速看到函数级别的耗时分布,可以先从 gprof 开始。
编译时加上:
-pg运行程序后会生成 gmon.out,再执行:
gprof myprogram gmon.out > analysis.txt它适合快速查看函数调用耗时,但对复杂现代工作负载的分析能力相对有限。
perf 更适合看真实热点和调用栈
perf 是 Linux 内核自带工具,适合排查 CPU 热点、调用栈和采样分布。常用命令是:
sudo perf record -g ./myprogram
sudo perf report如果你需要确认时间到底耗在用户态、内核态,还是某条热点调用链上,perf 通常比基础分析工具更直接。
Valgrind 适合补充调用路径分析
要看更细的调用关系,可以使用 callgrind:
valgrind --tool=callgrind ./myprogram随后通过 kcachegrind 可视化查看耗时函数和调用路径。它的优势是路径清晰,代价是运行开销较大,更适合离线分析而不是生产压测。
硬件与高性能库决定最终上限
当软件层优化已经比较充分,剩下的提升空间,往往就来自运行环境本身,包括 CPU 绑定、大页内存和成熟高性能库的复用。
硬件侧可以从 CPU 亲和性和大页开始
为了减少多核迁移带来的上下文切换和缓存失效,可以把进程绑定到指定核心:
taskset -c 0-3 ./myprogram如果程序对内存访问延迟敏感,还可以配置大页:
hugeadm --pool-pagesize 2M --num-pages 1024这样有助于减少 TLB 缺失,提升内存访问效率。
更直接的办法当然是升级硬件,例如多核 CPU、DDR4/DDR5 内存和 NVMe SSD,它们会直接抬高计算和 I/O 的上限。
尽量复用成熟的高性能库
很多性能问题其实不必自己从零优化,直接使用成熟库通常更省时间,也更容易拿到稳定收益。
- 数学计算:Intel MKL 支持 BLAS、LAPACK 等线性代数运算;OpenBLAS 是开源替代方案。
- 快速傅里叶变换:FFTW 支持多维 FFT,并针对内存访问模式做了优化。
- 线程池与并行框架:Boost.Asio 适合异步 I/O 和线程池,TBB(Intel Threading Building Blocks)适合并行算法与并发数据结构。
一套更实用的排查顺序
如果你想把调优工作做得更稳,可以按下面的顺序推进:
- 先开启
-O2、-march=native、-mtune=native,再评估是否需要-O3、-flto、PGO。 - 用
perf、gprof或valgrind --tool=callgrind找出热点,而不是直接大面积改代码。 - 优先检查容器选型、内存分配和热点循环。
- 确认 CentOS 的文件描述符、TCP、内存回收和文件系统参数是否匹配业务负载。
- 最后再考虑 CPU 亲和性、大页、硬件升级和高性能库替换。
这样做的好处是,每一步都能基于数据判断收益,避免把时间花在体感明显、实际提升很小的细节上。















