



在 C++ 里清理字符串中的 "http://"、"https://"、"ftp://" 这类协议头,难点不在语法,而在于不同场景下对“删除”的定义并不一样:有的是要把整串里所有匹配都删掉,有的只是想拿到去掉协议后的主体做解析。下面按三种常见方案拆开说明,并把循环删除、大小写匹配、长度顺序和边界条件这些容易踩坑的地方一次讲清楚,方便你判断该选哪一种。
用 std::string::find + std::string::erase 循环删除
这是最直观的办法,适合协议头固定、出现次数不多的情况,比如统一去掉 "http://" 或 "https://"。核心思路很简单:先找到协议头,再把这一段从原字符串里删掉。
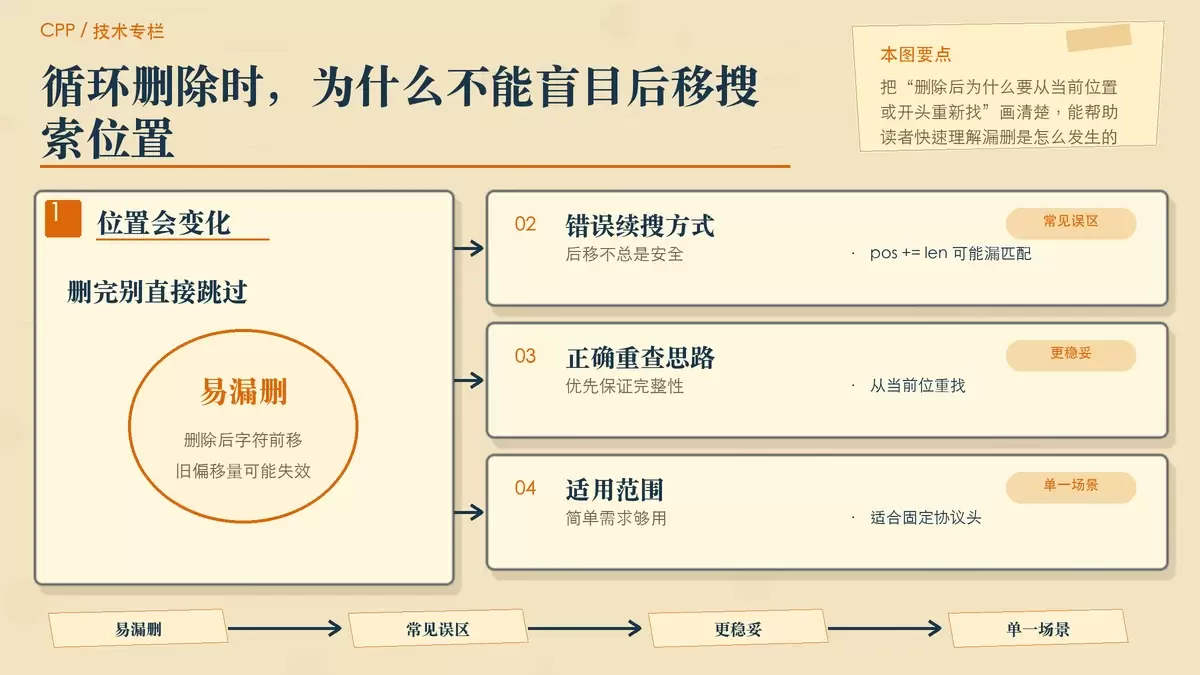
但这类写法最容易犯的错误,也恰恰出在“删掉之后怎么继续找”。因为 erase 会让后面的字符整体前移,如果还沿用删除前的偏移量继续搜索,就可能漏掉紧邻的下一个匹配。
常见误区是写成 pos += len 后继续查找。这在协议头连续出现、嵌套出现,或者删除后字符串结构发生收缩时,都可能跳过本该继续处理的位置。更稳妥的办法,是让下一轮从当前删除点重新找,或者直接从头重新扫描。
std::string s = "https://http://example.com";
std::string prefix = "http://";
size_t pos = 0;
while ((pos = s.find(prefix, pos)) != std::string::npos) {
s.erase(pos, prefix.length());
// 不加 pos += prefix.length(),让下一轮从 pos 开始找(已缩短)
}
// 结果: "s://example.com" —— 注意:这里只删了第一个 "http://",第二个被保留
上面这段代码也说明了另一个问题:如果待删协议头不止一种,或者不同协议头之间会互相覆盖,单独只找一个 prefix 往往不够。比如示例里删掉 "http://" 之后,剩下的 "https://" 并不会自动处理。
因此,这种方案更适合下面两类需求:
- 协议头类型单一,目标非常明确
- 你就是要在原字符串上原地修改,而不是做只读分析
如果要提高稳妥性,可以在每次删除后把搜索起点重置为 0,或者改成每轮都执行一次 pos = s.find(prefix)。这样虽然会多做一点扫描,但逻辑更不容易漏删。
协议头种类多时,用 std::regex_replace 更省事
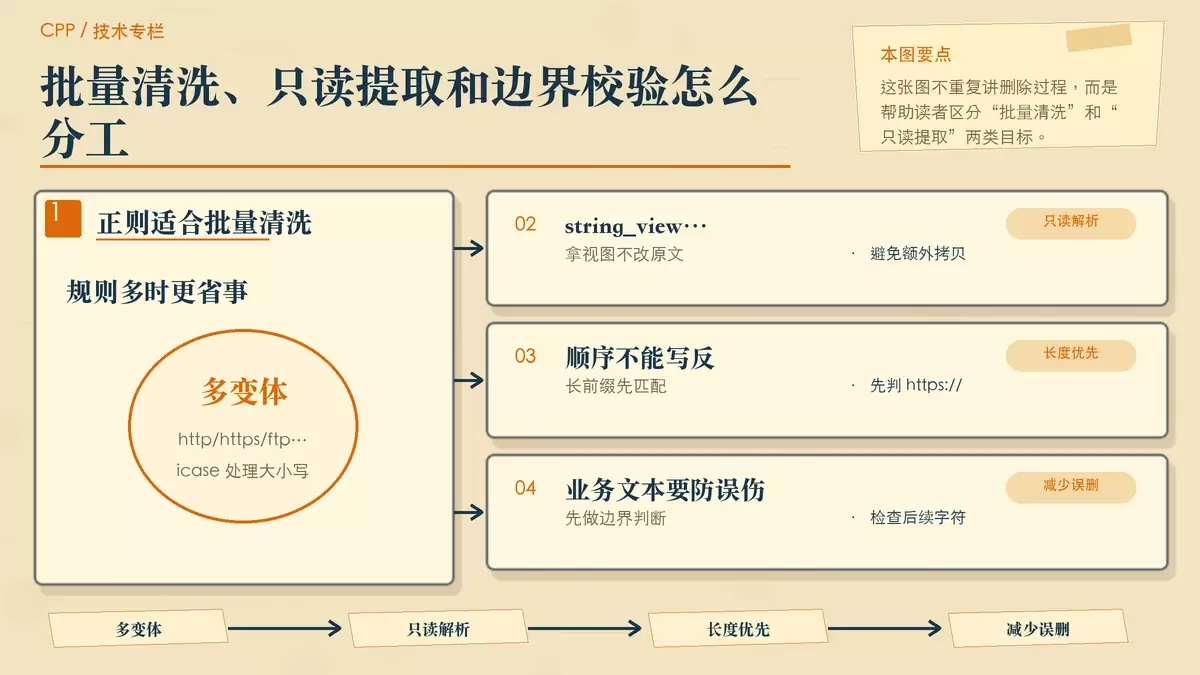
当你面对的不只是一个固定协议头,而是同时要处理 "http://"、"https://"、"ftp://",甚至还要兼容 "HTTP://" 这种大小写混写形式时,正则替换会更直接。它的优势在于可以一次性描述多种匹配规则,再统一清除所有命中内容。
一个典型写法如下:
#include <regex>
std::string s = "Visit http://a.com or HTTPS://b.net";
std::regex proto_re(R"(https?://|ftp://)", std::regex_constants::icase);
s = std::regex_replace(s, proto_re, "");
// 结果: "Visit a.com or b.net"
这段代码里有两个关键点值得注意。
大小写不敏感要显式指定
如果业务字符串里可能出现 "HTTP://"、"Https://" 这类变体,就需要加上 std::regex_constants::icase。否则正则只会按字面大小写精确匹配,结果看起来像“有些能删,有些删不掉”。
不要把“所有匹配”误写成“只匹配开头”
如果题目要求删除字符串中所有协议头,就不要写成 ^http:// 这种只锚定开头的模式。这个 ^ 会把匹配范围限制在字符串起始位置,导致正文中间出现的协议头完全保留。
反过来说,如果你的真实需求只是“只去掉 URL 开头的协议部分”,那就应该明确写成更精确的模式,例如 ^https?://。这样误删概率更低,也更符合意图。
正则方案也有环境差异
虽然 std::regex_replace 表达力更强,但 C++11 的 std::regex 在不同标准库实现上的表现并不完全一致。尤其在部分 libstdc++ 环境里,性能和稳定性口碑一直一般;相对来说,Clang 的 libc++ 或 MSVC 通常更稳一些。
所以这类方案更适合规则复杂、协议变体多、维护成本优先的场景;如果只是删除一个固定前缀,为了这点需求上正则,反而可能显得过重。
只读解析时,优先考虑 std::string_view
很多时候,你并不是一定要“修改原字符串”,而只是想在解析 URL 时拿到去掉协议头后的主体。例如提取主机名、继续做分段判断,或者把剩余部分交给后续逻辑处理。这个时候直接复制、删除、再生成新字符串,往往没有必要。
如果只是做只读判断,std::string_view 会更合适。它不拥有内存,只是对原字符串的一段视图,因此可以避免额外拷贝。
std::string_view get_host_part(std::string_view s) {
if (s.starts_with("https://")) return s.substr(8);
if (s.starts_with("http://"))return s.substr(7);
if (s.starts_with("ftp://")) return s.substr(6);
return s;
}
这段代码看起来简单,但有三个细节不能忽略。
匹配顺序要按长度降序写
像 "https://" 和 "http://" 这种前缀,前者包含了后者的开头部分。判断时必须先试更长的 "https://",再试 "http://",否则长前缀会被短前缀提前截走,结果自然就错了。
substr 的位置是“协议结束处”
返回 sv.substr(pos) 时,pos 必须指向协议头之后的位置,而不是协议头起始位置。比如 "https://" 的长度是 8,那就要传 8,否则返回结果还会残留协议字符。
string_view 不适合脱离原始存储长期保存
string_view 本身不管理内存,这意味着它引用的数据必须继续有效。把它返回给调用者通常没问题,但前提是底层字符串没有提前销毁;如果它指向的是临时对象或已经离开作用域的内容,就会留下悬空视图。
因此,string_view 更适合高频只读判断、轻量解析和零拷贝切片,而不适合替代所有字符串存储场景。
别忽略协议头后的边界条件
实际业务里,单纯“看到 :// 就删”并不总是安全。问题不在代码能不能删掉,而在删掉之后字符串语义是否还成立。
例如只有一个单独的 "http://",后面没有域名;或者协议头后面紧跟空格、异常字符、甚至只是普通文本的一部分。此时如果直接删除,得到的结果可能既不是合法 URL,也不是你真正想保留的内容。
所以在偏业务化的文本清洗里,通常要增加一层边界判断,例如确认协议头后面是不是紧跟域名里常见的字符,再决定要不要删:
// 粗略检查:协议头后是不是域名常见字符
if (pos + prefix.length() < s.length()) {
char next = s[pos + prefix.length()];
if (std::isalnum(next) || next == '.' || next == '-') {
s.erase(pos, prefix.length());
}
}
这类判断不能替代完整 URL 解析,但足以覆盖很多常见清洗需求。它的意义在于避免把原本只是普通文本的一段内容误当成可删协议头。
举例来说,如果字符串里出现类似 "I use http:// daily" 这种内容,虽然并不常见,但在一些日志、评论、业务文本中确实可能出现。没有边界校验时,代码会直接删掉其中的 "http://";加了判断后,至少能减少这类误伤。
再往前走一步,如果你面对的是完整 URL 清洗、协议规范校验、复杂转义处理或 RFC 3986 兼容需求,那么纯字符串替换只能覆盖典型案例,不能替代专门的解析器。需要健壮性时,应该考虑使用完整 URI 解析库,例如 uri-parser 这一类工具,而不是指望一次 replace 就处理所有变体。
怎么选:修改字符串、批量清洗,还是只读提取
把这三种方案放在一起看,选择标准其实并不复杂。
- 如果协议头固定、数量少,而且你明确需要改写原字符串,优先用
find + erase - 如果协议头种类多、规则多、还要处理大小写,
std::regex_replace更省事 - 如果只是解析并提取协议后的主体,不想产生额外拷贝,就用
std::string_view
真正决定方案的,不是“哪种写法更高级”,而是你的目标到底是删除、替换,还是只读切片。把这个前提先想清楚,代码反而容易写对。
最后还要记住一点:协议头处理看起来像小问题,但一旦进入真实文本环境,重复匹配、重叠前缀、大小写、边界字符这些细节都会影响结果。对典型用例,字符串操作已经够用;对规范级处理,还是应该交给专门解析器。















