



CentOS 上的 C++ 内存泄漏排查,难点通常不在“有没有工具”,而在“该先用哪个、结果怎么看、适合放到什么场景里”。这篇文章按实际排查路径,把 Valgrind、AddressSanitizer(ASan)和 glibc 自带的 mtrace 拆开说明,保留安装、编译和运行命令,并补上它们各自的适用判断,方便你根据项目规模、排查速度和环境限制直接选型。
为什么 CentOS 上要分工具排查内存泄漏
C++ 程序出现内存泄漏时,表现未必总是立刻明显。有些问题会在长时间运行后才逐渐放大,比如进程常驻内存持续上涨、服务重启前越来越慢,或者压测时出现异常资源占用。
在 CentOS 环境里,常见的排查工具大致可以分成三类:
- Valgrind:覆盖面广,适合做一次比较彻底的检查。
- AddressSanitizer:编译期注入检测,运行速度通常比 Valgrind 更快。
- mtrace:glibc 自带,依赖少,适合快速记录
malloc/free调用。
如果你是第一次定位问题,通常可以先看项目当前条件:能不能接受较慢的运行速度、是否方便重新编译、线上环境是否适合安装额外工具。这几个判断,基本就能决定优先使用哪一类方案。
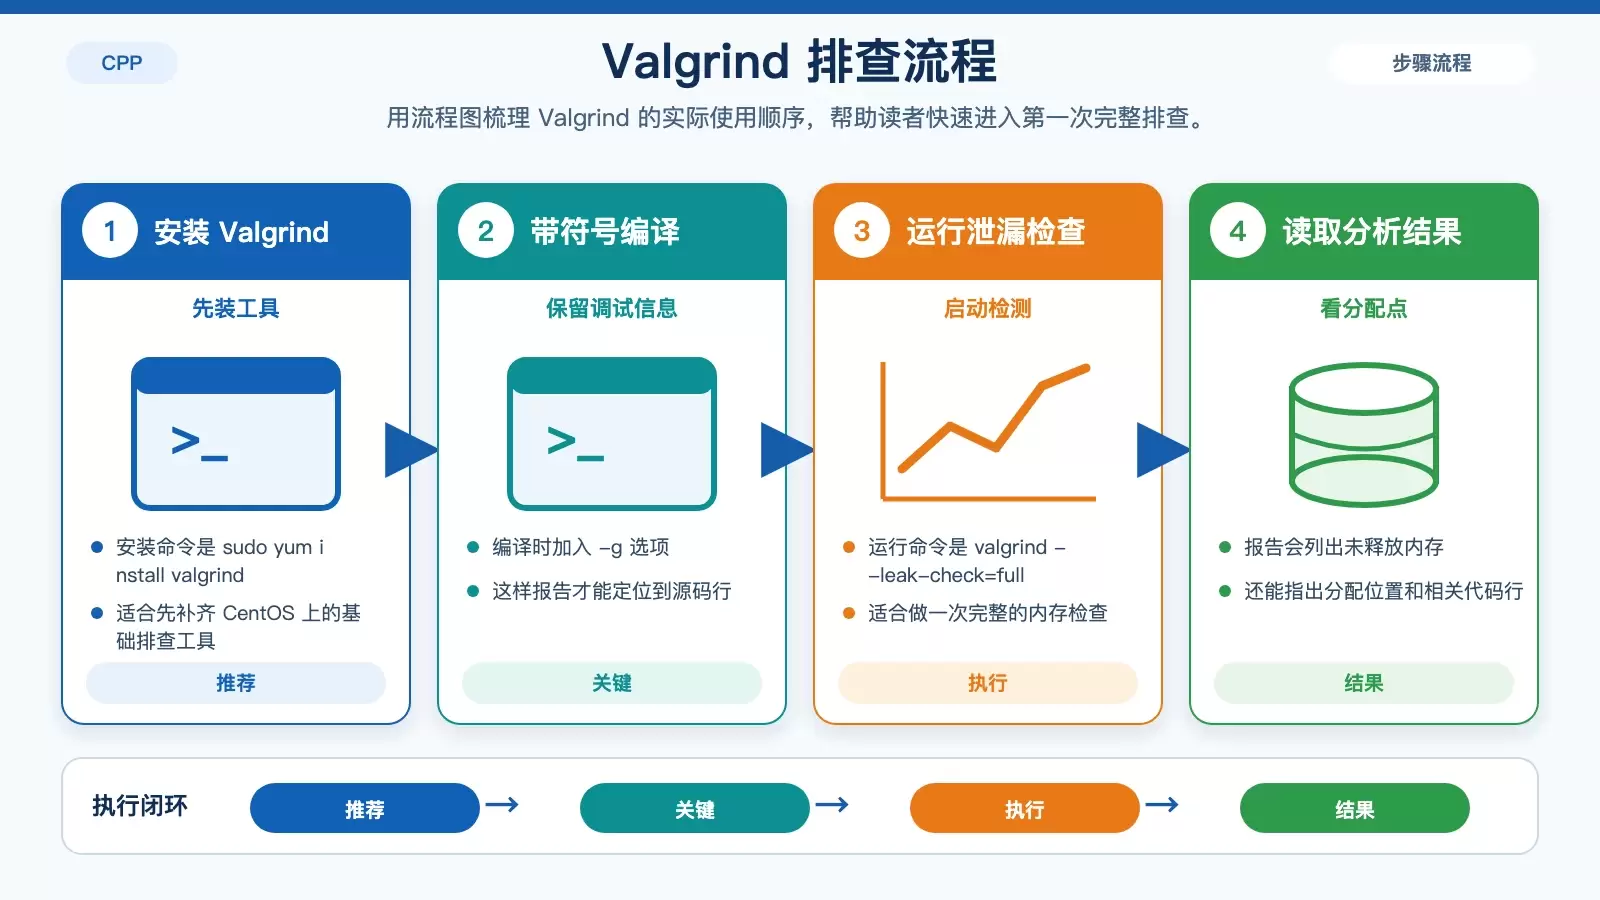
用 Valgrind 做一次全面检查
Valgrind 是排查内存问题时最常见的工具之一,不仅能查泄漏,也经常用于发现越界访问等问题。它的优势在于报告信息比较完整,适合在问题范围还不明确时先做一轮“体检”。
1. 安装 Valgrind
sudo yum install valgrind2. 编译程序时保留调试信息
为了让报告能定位到源码行,编译时要加上 -g:
g++ -g -o my_program my_program.cpp3. 运行泄漏检查
valgrind --leak-check=full ./my_program程序结束后,Valgrind 会输出详细的内存分配与释放信息,包括哪些内存没有释放、对应的分配位置以及相关调用链。对排查“到底是哪一段逻辑忘了释放”这类问题很有帮助。
它的代价也很明确:运行会明显变慢。因此更适合本地复现、测试环境排查,或者对可疑模块做定向检查,而不是默认拿来跑所有大型任务。
AddressSanitizer:更适合日常开发和大型项目
AddressSanitizer,通常简称 ASan,是另一条非常实用的路径。它的思路不是像 Valgrind 那样在外部“托管运行”,而是在编译阶段插入检测代码,程序运行时直接报告内存问题。
原文以 Clang 为例,但 GCC 同样支持该能力。在 CentOS 上,如果你的项目本来就能方便地重新编译,ASan 往往是效率更高的选择。
1. 安装 Clang
sudo yum install clang2. 编译时开启 ASan
g++ -fsanitize=address -o my_program my_program.cpp3. 直接运行程序
./my_program一旦出现内存泄漏或越界访问,ASan 会在程序退出时打印详细堆栈,指出问题发生的位置。相比 Valgrind,它通常有更好的执行速度,因此更适合大型项目、日常测试,或者集成进持续集成流程里做自动检查。
如果你的目标是“尽早发现、持续拦截”,ASan 往往比一次性的手工排查工具更容易形成习惯用法。
不装第三方工具时,可以用 glibc 的 mtrace
如果当前环境不方便安装额外工具,glibc 自带的 mtrace 是一个更轻量的方案。它通过记录每次 malloc/free 调用生成日志,再用配套命令分析未释放的分配点。
1. 在代码中启用 mtrace
#include <mtrace.h>

int main(int argc, char *argv[]) {
    mtrace();
    // ... 你的代码
}
2. 编译时保留调试信息
g++ -g -o my_program my_program.cpp3. 运行时写出跟踪日志
MALLOC_TRACE=/tmp/mtrace.out ./my_program4. 分析日志文件
mtrace my_program /tmp/mtrace.outmtrace 会列出未释放的内存分配点以及对应源码行号。它没有 Valgrind 和 ASan 那么全面,但零依赖这一点很实用,尤其适合在受限环境下先快速确认“是否确实存在泄漏”。
三种方法怎么选,适合什么场景
如果把这三种方法放到同一张表里理解,差异会更清楚:
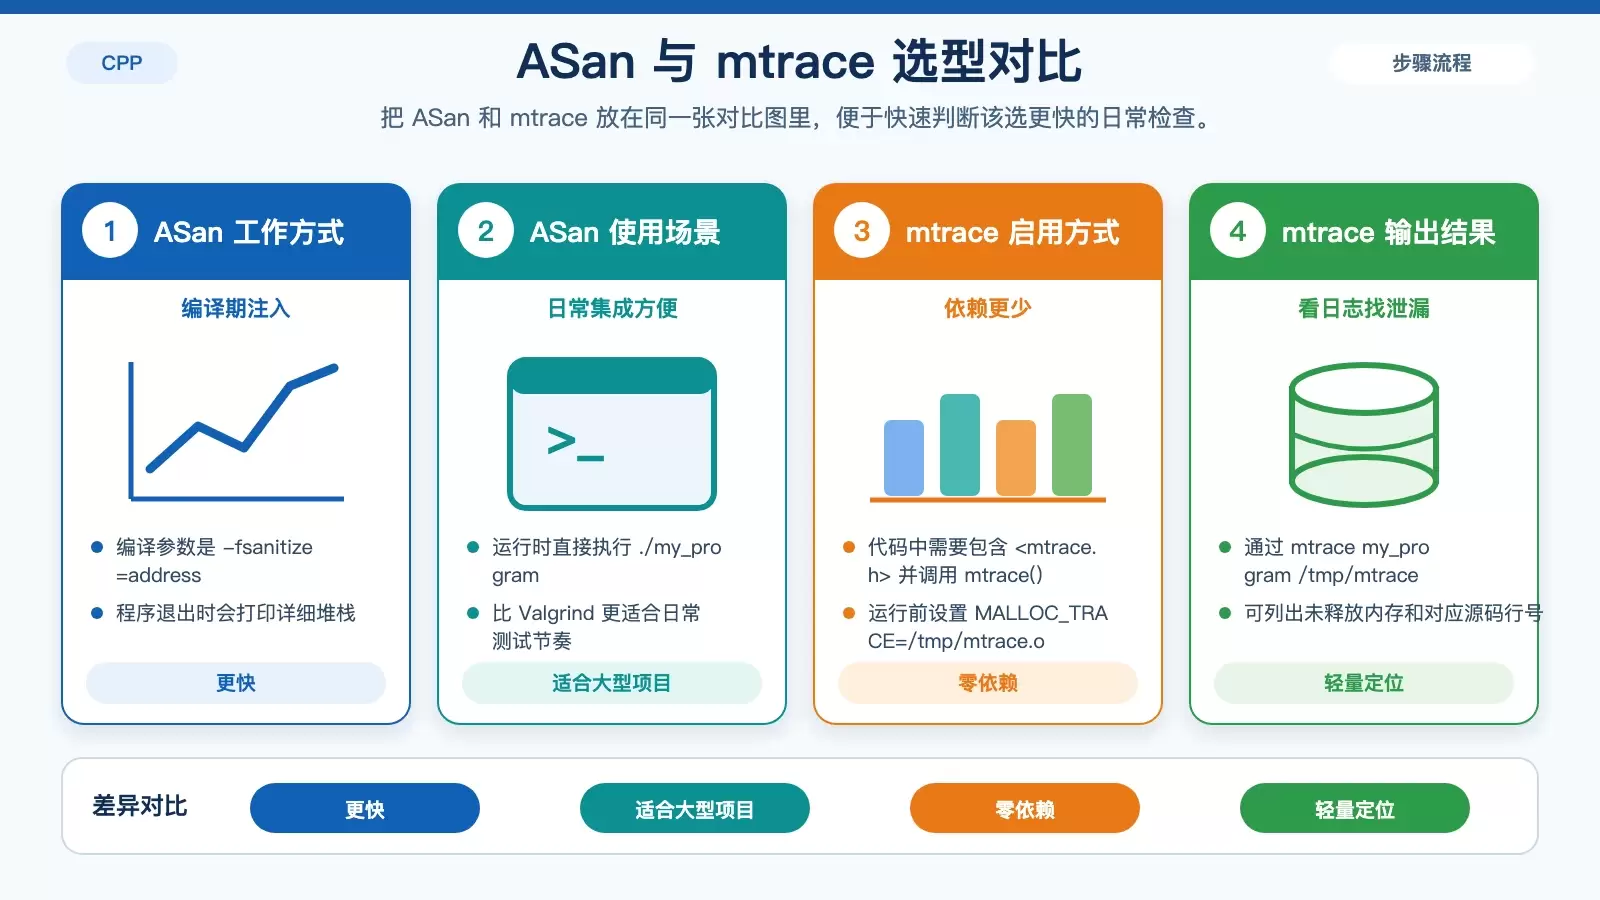
- Valgrind:最全面,但运行慢。适合深入排查、问题复现后精确定位。
- ASan:速度更快,接入现代开发流程更顺手。适合大型项目和日常测试。
- mtrace:最轻量,零依赖。适合环境受限时快速确认和初步定位。
实际开发里,不一定只选一个。更常见的做法是:
- 日常开发和 CI 中启用 ASan 做持续检查;
- 遇到复杂疑难问题时,再用 Valgrind 补一次深度分析;
- 特殊环境或临时排查时,用 mtrace 作为轻量替代。
内存泄漏问题越早发现,修复成本通常越低。把其中一到两种方法纳入固定流程,比等到线上内存持续增长后再临时排查,要有效得多。















