



在 CentOS 上写 C++ 程序时,很多异常问题并不是“不会处理”,而是代码抛出、编译支持、调试定位和日志留痕这几步没有连起来看。本文按实际排查顺序,把最常用的异常处理方法拆开说明,读完后你可以判断:当前问题是出在异常写法、构建配置,还是出在调试和记录手段不足。
先把异常处理的基本写法跑通
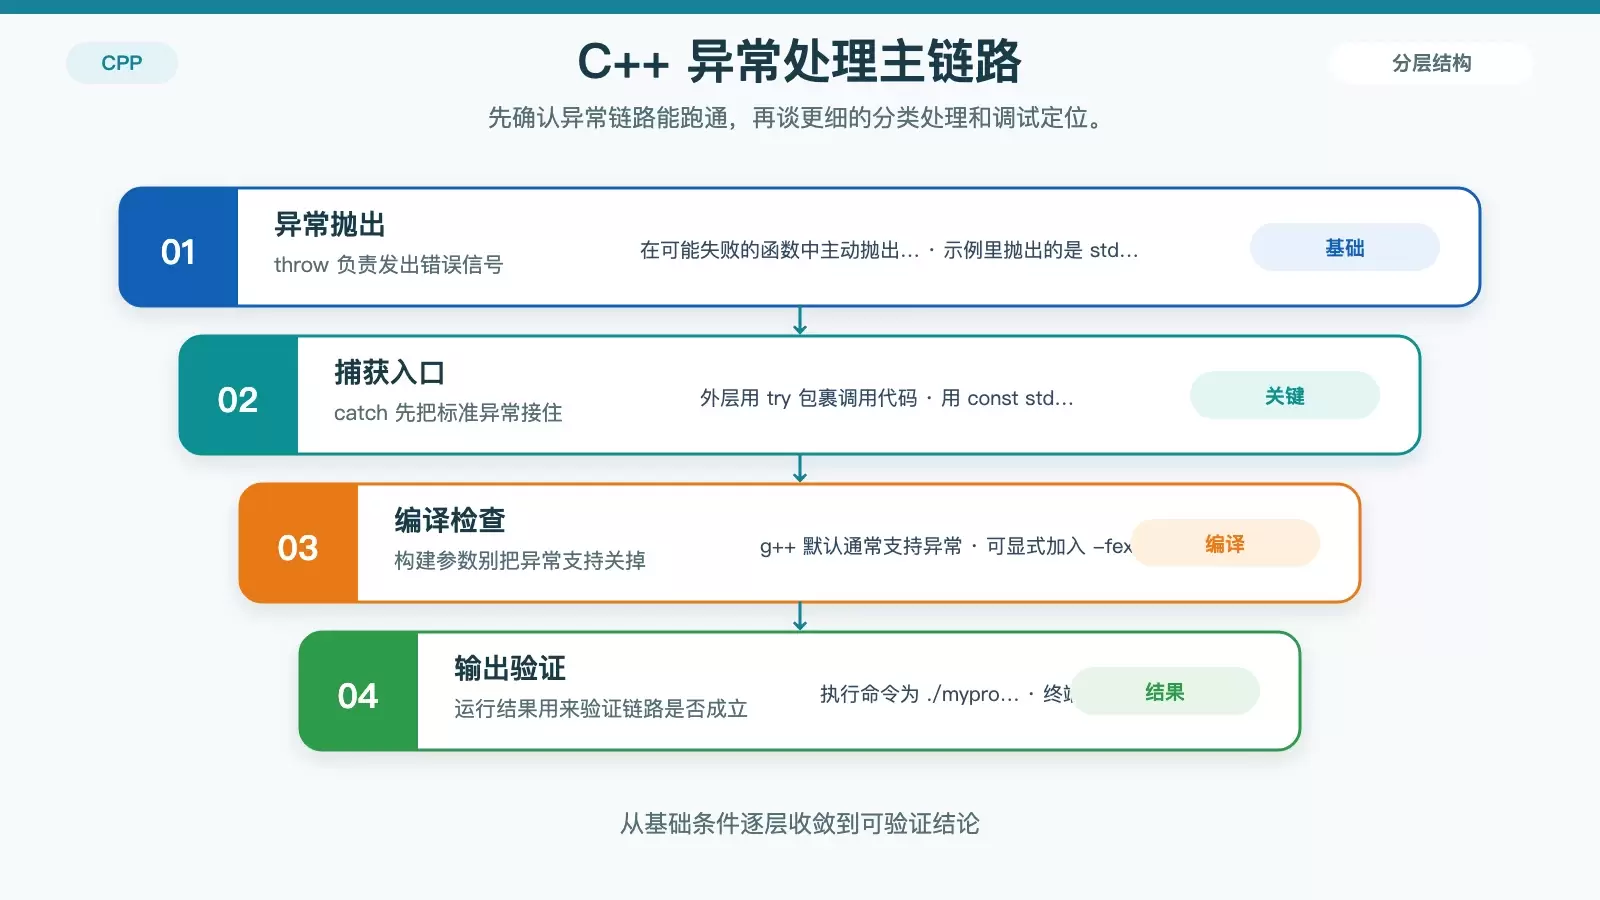
C++ 异常处理的核心就是 try、catch 和 throw。常见做法是:在可能失败的函数里用 throw 抛出异常,在调用层用 try 包裹,再通过 catch 接住并处理。
先看一个最小可运行示例:
#include <iostream>
#include <stdexcept>

void riskyFunction() {
    throw std::runtime_error("An error occurred");
}

int main() {
    try {
        riskyFunction();
    } catch (const std::exception& e) {
        std::cerr << "Caught exception: " << e.what() << std::endl;
    }
    return 0;
}
这里抛出的是 std::runtime_error,捕获时使用的是它的基类 std::exception。这样写的好处是,标准库里大多数常见异常都能统一接住,适合先把异常链路建立起来。
如果你的程序在 CentOS 上遇到错误直接退出,而不是走到 catch 分支,第一步就应该先确认:异常到底有没有被抛出,外层是不是确实做了捕获。
编译和运行时要确认什么
编译时检查异常支持
用 g++ 编译时,异常支持默认通常是开启的,但为了避免构建参数被其他脚本覆盖,显式加上 -fexceptions 更稳妥:
g++ -o myprogram myprogram.cpp -fexceptions如果项目通过 CMake 或其他构建系统编译,也要顺手检查对应编译选项,确认没有把异常相关支持静默关掉。
运行后如何判断异常已被正确处理
编译成功后,直接执行程序:
./myprogram如果示例中的异常按预期被捕获,终端会输出:
Caught exception: An error occurred这一步的意义不只是“程序能跑”,而是验证完整链路是否成立:异常被抛出、被捕获、错误信息被输出。只有先确认这条链路是通的,后面排查复杂问题才有基础。
出现异常时,怎么用 gdb 定位调用链
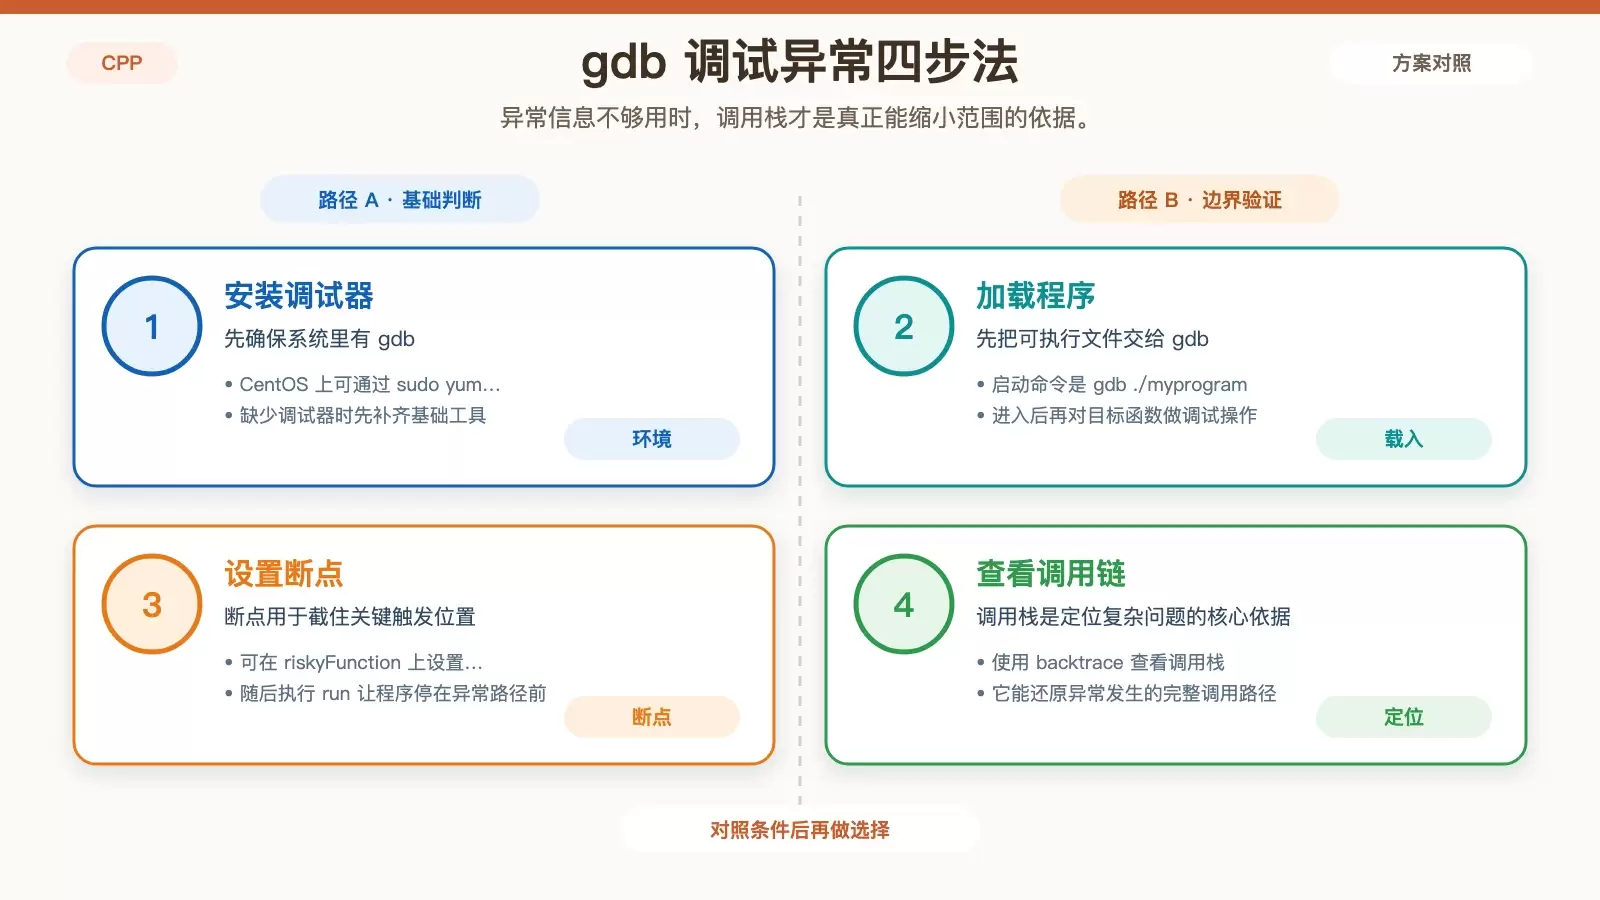
当终端里只有一句报错信息、但你还不知道异常从哪一层冒出来时,就该用 gdb 看调用栈了。这在排查多层函数调用、库调用或条件触发类问题时尤其有用。
先安装 gdb
如果 CentOS 环境里还没有安装 gdb,先执行:
sudo yum install gdb常用调试步骤
启动 gdb 并加载你的程序:
gdb ./myprogram进入调试器后,可以先在 riskyFunction 上设置断点,再运行程序:
(gdb) break riskyFunction
(gdb) run
程序停住后,用下面的命令查看调用栈:
(gdb) backtracebacktrace 的价值在于,它能把“异常发生了”进一步变成“异常是从哪条调用路径上来的”。对线上问题复现、复杂逻辑回溯和第三方库问题确认都很实用。
需要分类型处理时,catch 顺序别写反
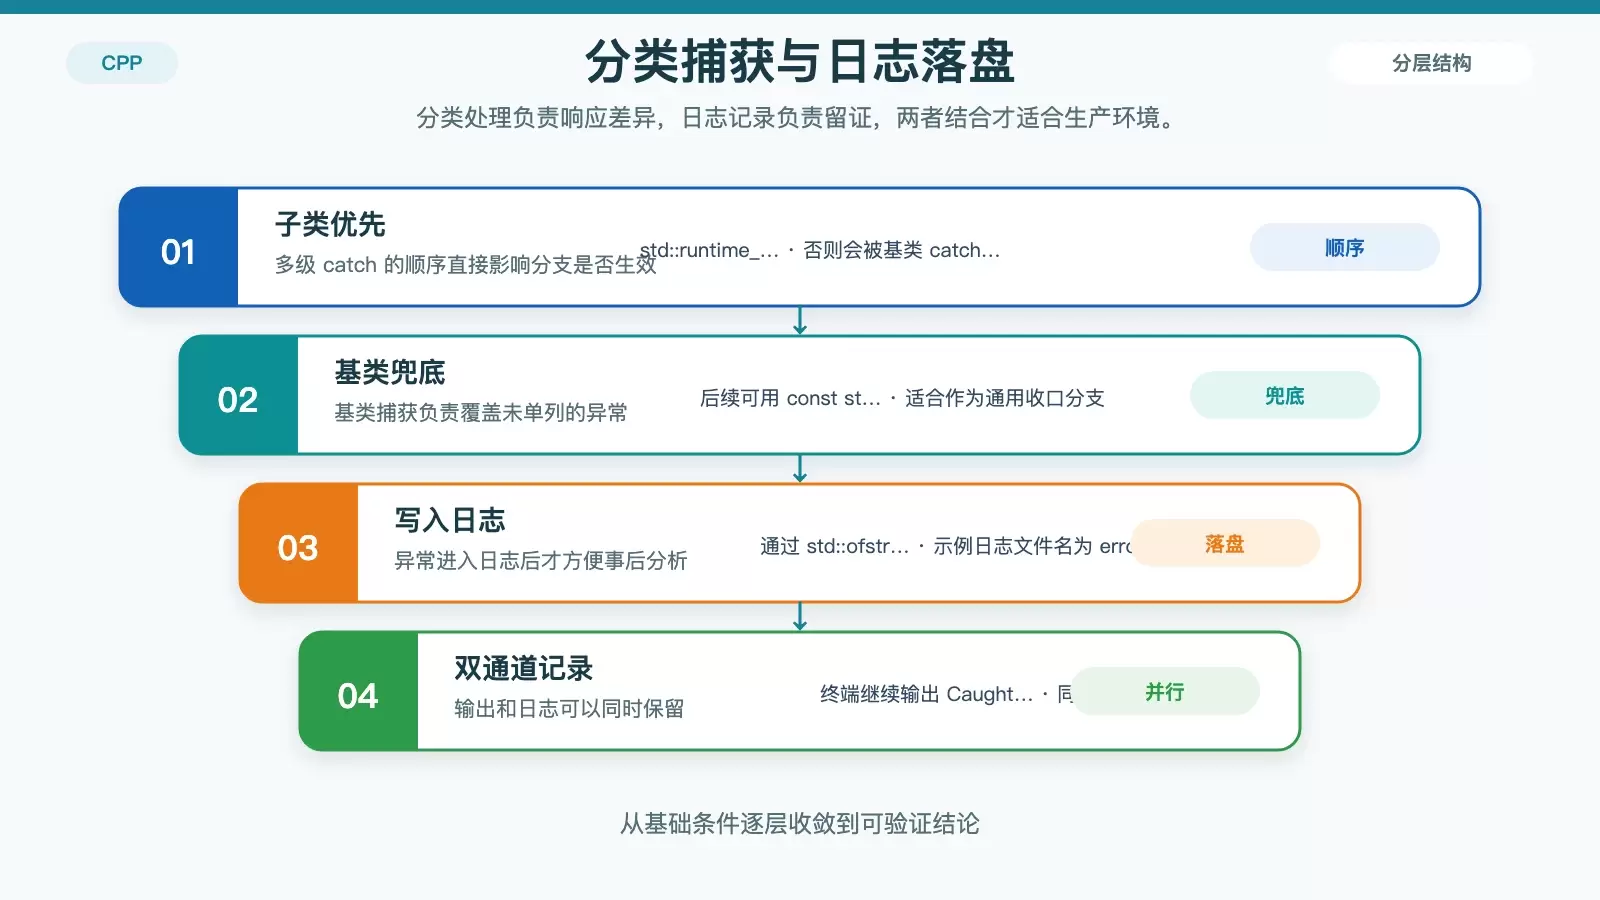
实际项目里,异常往往不能一把抓。比如 std::runtime_error 可能需要单独记录,其他标准异常则统一兜底处理。这时就要按类型拆分 catch 分支。
try {
    riskyFunction();
} catch (const std::runtime_error& e) {
    std::cerr << "Caught runtime_error: " << e.what() << std::endl;
} catch (const std::exception& e) {
    std::cerr << "Caught other exception: " << e.what() << std::endl;
}
这里最容易出错的地方不是语法,而是顺序。更具体的子类异常必须写在前面,基类异常写在后面。否则基类会先把子类异常接走,后面的精确处理分支根本不会执行。
如果你发现某个特定异常分支始终进不去,优先检查的就是这一点。
生产环境里,异常信息最好落到日志
开发阶段把异常打印到终端通常够用,但到了生产环境,仅靠标准输出很难做事后分析。更常见的做法是,在捕获异常后同步写入日志文件,至少保留最基本的错误信息。
下面是一个简单示例:
#include <fstream>

void logException(const std::exception& e) {
    std::ofstream logFile("error.log", std::ios::app);
    if (logFile.is_open()) {
        logFile << "Exception: " << e.what() << std::endl;
        logFile.close();
    }
}

int main() {
    try {
        riskyFunction();
    } catch (const std::exception& e) {
        std::cerr << "Caught exception: " << e.what() << std::endl;
        logException(e);
    }
    return 0;
}
这段代码通过 std::ofstream 以追加模式写入 error.log,每次捕获到异常时都会留下记录。对于小程序或排障脚本,这已经能解决不少问题。
如果项目规模更大,可以再考虑接入像 spdlog、log4cpp 这样的日志库,但思路没有变化:捕获异常、保留上下文、方便回查。
一套更实用的处理顺序
如果你是在 CentOS 上排查 C++ 异常,比较实用的顺序通常是这样的:先确认代码里已经正确使用 throw 和 catch,再检查 g++ 编译参数是否正常,随后通过程序输出验证异常链路,最后再用 gdb 和日志把问题定位到具体调用点。
异常处理的重点不是把错误“吞掉”,而是让程序在出错时还能给出清晰反馈:能区分异常类型,能看到调用路径,也能留下可追溯的记录。做到这几点,程序在 CentOS 环境里的可维护性会稳定很多。















