



很多人提到 Nginx 调优,第一反应就是改 worker_processes、开 gzip,但线上瓶颈往往并不只在配置文件里。更实际的做法,是把配置、系统参数、硬件资源、缓存链路和监控方式放到同一张清单里逐项判断,这样才能知道性能到底卡在连接、I/O、TLS,还是后端压力上。
配置层先做哪些优化
配置文件是最容易下手、也最容易看到效果的一层,但参数之间是联动的,不能只盯着单项数值。
工作进程与连接数要一起看
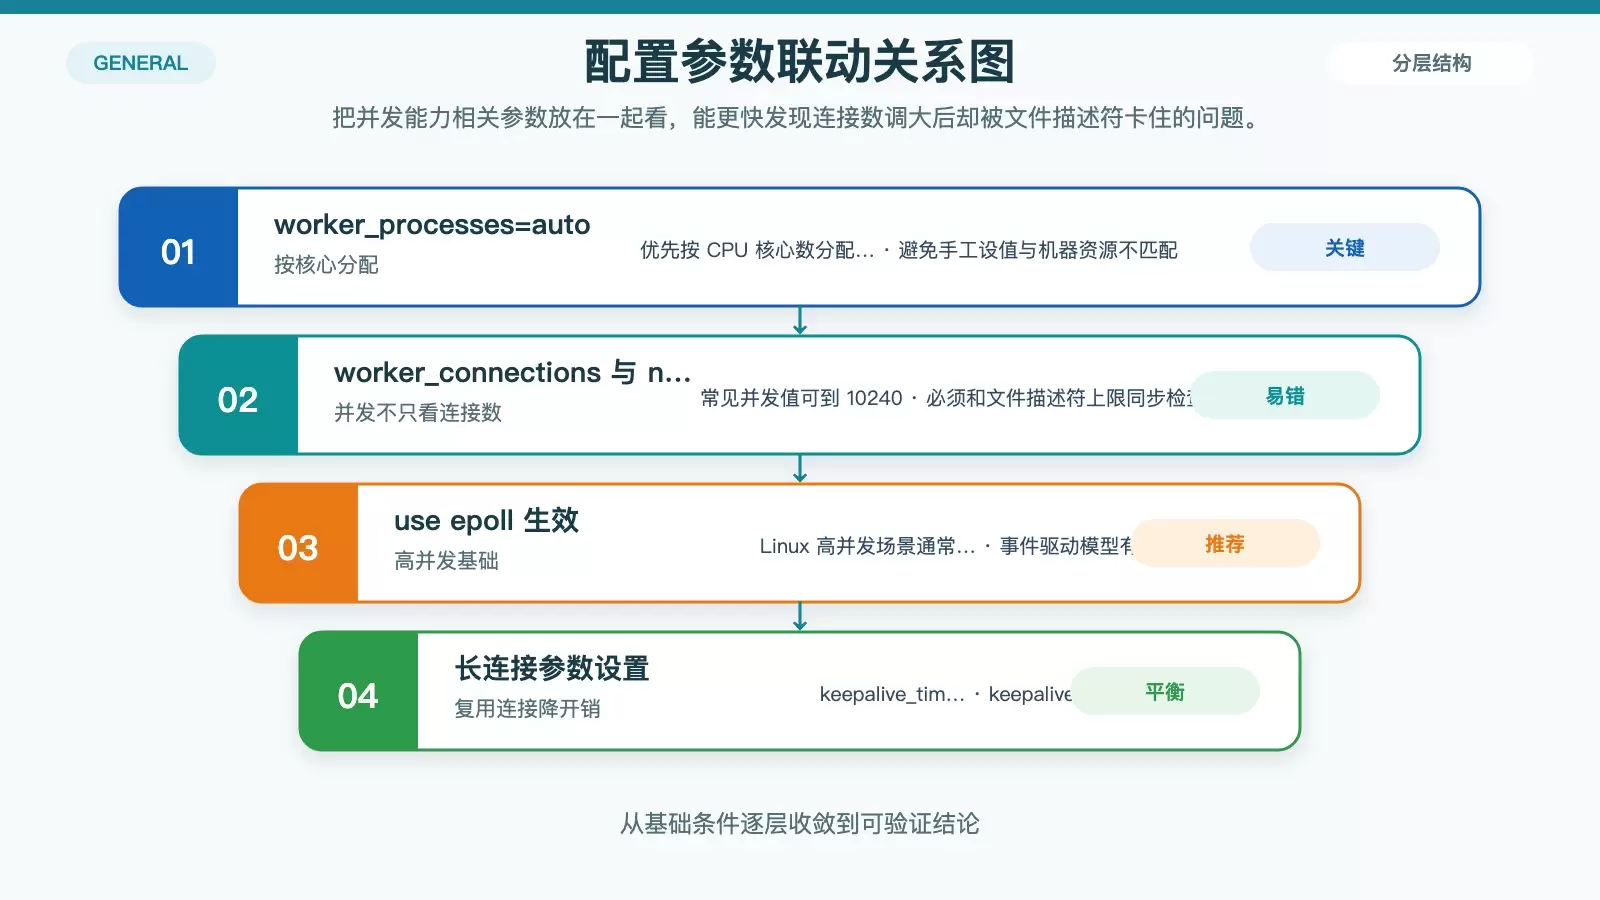
worker_processes优先设为auto,让 Nginx 按 CPU 核心数分配工作进程。并发能力则主要受worker_connections影响,像10240这类数值在高并发场景里比较常见。
不过,连接数调大以后,还要同步检查worker_rlimit_nofile。如果文件描述符上限没有跟上,即使并发参数写得再高,也可能直接撞上“Too many open files”这一类硬瓶颈。
高并发场景要启用合适的 I/O 与长连接参数
Linux 环境下通常要启用:
use epoll;epoll是 Nginx 在高并发下保持事件驱动效率的基础。对于连接复用,keepalive_timeout可设为65秒,keepalive_requests建议在100以上,这样能减少 TCP 握手和挥手带来的额外开销。
压缩与缓冲区设置决定带宽和内存开销
压缩方面,常见做法是开启:
gzip on;同时让gzip_types覆盖文本、JSON、JS 等常见类型。gzip_comp_level一般建议设为5,在压缩率和 CPU 消耗之间更容易取得平衡。
请求缓冲区同样不能忽略,文中给出的典型值包括:
client_body_buffer_size 128k;
client_header_buffer_size 1k;
large_client_header_buffers 4 8k;
这组参数直接影响大请求的处理方式。设得过小,可能导致频繁磁盘 I/O;设得不合理,也会带来额外内存压力。
系统参数为什么常常是真正瓶颈
如果配置层已经做过调整,吞吐量还是上不去,就要把视线移到操作系统。很多线上问题并不是 Nginx 本身处理不过来,而是内核队列、端口范围或文件描述符限制先满了。
内核参数要覆盖连接队列和端口范围
可以在/etc/sysctl.conf里重点检查这些参数:
net.core.somaxconn = 65535
net.ipv4.tcp_max_syn_backlog = 65535
net.ipv4.tcp_tw_reuse = 1
net.ipv4.tcp_tw_recycle = 1
net.ipv4.ip_local_port_range = 1024 65535net.core.somaxconn和net.ipv4.tcp_max_syn_backlog决定了高并发请求下的排队能力;扩大net.ipv4.ip_local_port_range,则是为了给更多并发连接预留端口空间。
文件描述符限制要和连接规模匹配
在/etc/security/limits.conf里,nofile通常要设到65535以上,例如:
* soft nofile 65535
* hard nofile 65535这一项如果偏低,连接会在高峰期被直接拒绝,前面针对worker_connections做的调优也就失去了意义。
静态文件场景可考虑异步 I/O
对于大文件或较多静态资源读取场景,可以启用:
aio on;这样内核在处理文件读取时,可以并行处理其他 I/O 请求,避免工作进程被单次磁盘读取长时间拖住。
硬件、缓存和后端压力怎么一起降
软件参数调到一定程度后,瓶颈很可能会落到磁盘延迟、CPU 切换或后端压力上。这时要把硬件与缓存策略结合起来看,而不是只追加机器配置。
SSD、CPU 绑定和内存都会影响稳定吞吐
把 HDD 换成 SSD,最直接受益的是静态资源读取延迟,图片、CSS、JS 这类文件通常能明显缩短响应时间。
如果服务器核数明确,还可以通过worker_cpu_affinity绑定工作进程,例如 4 核场景下:
worker_cpu_affinity 0001 0010 0100 1000;这样做的目的,是减少进程在不同核心之间频繁切换,让 CPU 利用率更稳定。内存扩容则主要影响缓存命中率,并减少 swap 使用概率。
浏览器缓存和文件缓存先减掉重复请求
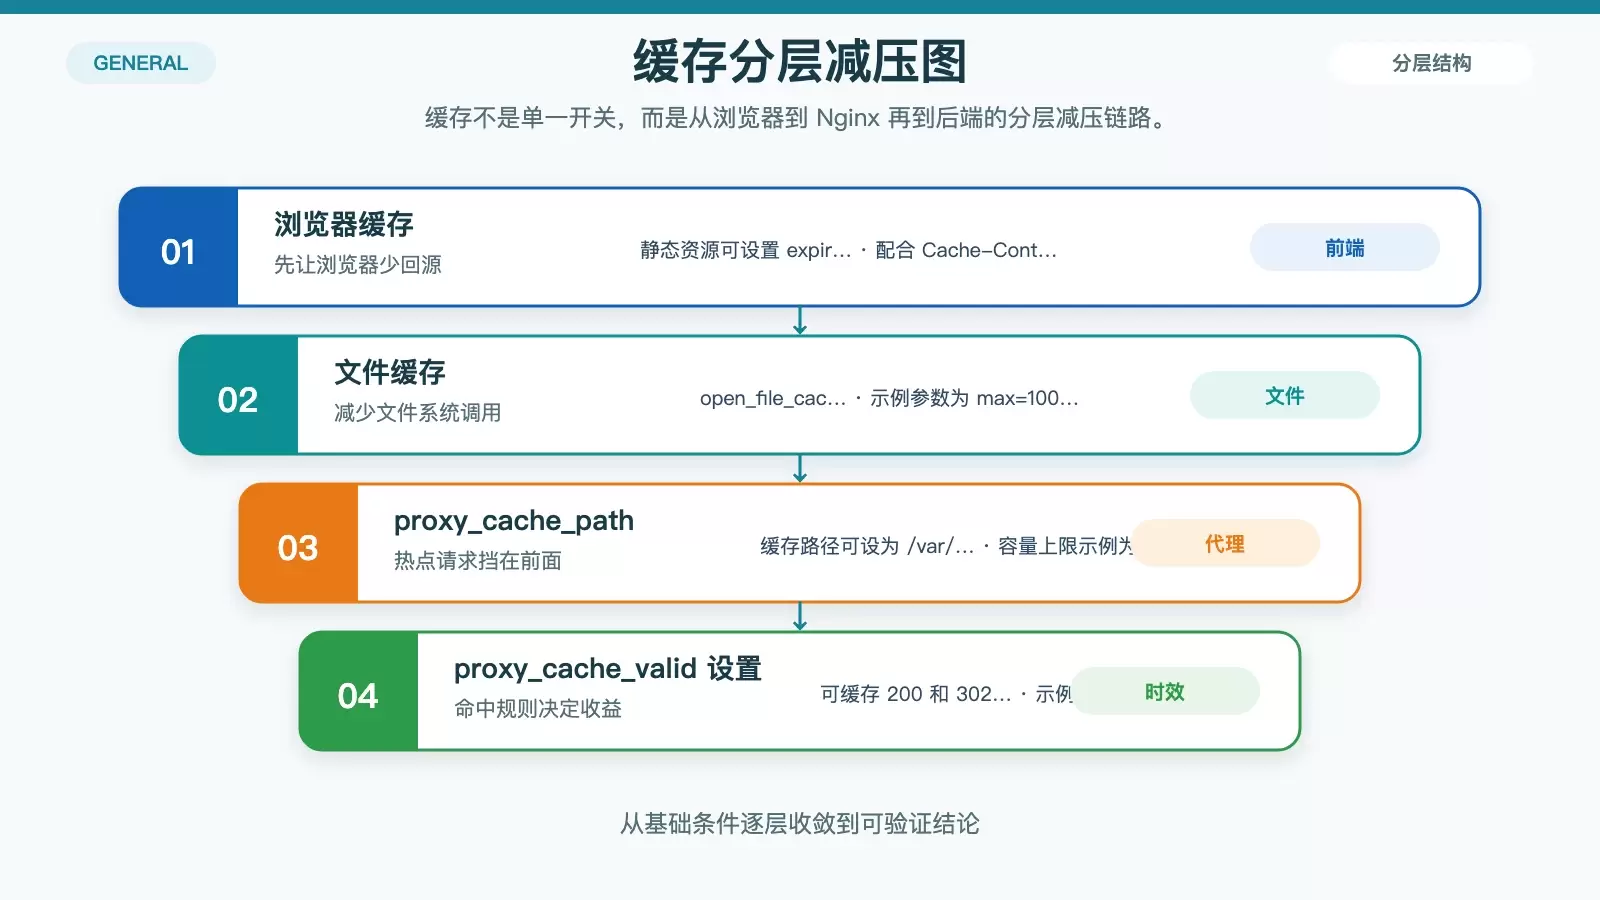
静态资源可以直接利用浏览器缓存:
expires 30d;
add_header Cache-Control "public";如果文件访问较频繁,还可以启用open_file_cache,例如:
open_file_cache max=1000 inactive=20s;它能缓存已打开的文件描述符,减少文件系统调用次数。
代理缓存适合先挡住后端热点流量
如果 Nginx 前面承担反向代理角色,可以配置代理缓存,把可缓存请求直接拦在前面:
proxy_cache_path /var/cache/nginx max_size=1g;
proxy_cache ...
proxy_cache_valid 200 302 10m;这里的重点是三件事:缓存路径如/var/cache/nginx、容量上限如max_size=1g、以及命中状态码与有效期,如200 302 10m。配置合理时,后端服务压力会明显下降。
负载均衡与 TLS 如何减少额外开销
Nginx 不只是 Web 服务器,也是常见的入口代理。请求如何分发、HTTPS 握手是否能复用,都会直接影响吞吐和延迟。
负载均衡算法要按业务特征选
round-robin适合大多数通用场景;least_conn更适合长连接较多的业务;ip_hash则适合需要会话一致性的场景。算法没有绝对优劣,关键是是否匹配请求模型。
后端长连接复用可以减少反复建连
在upstream中可以设置:
keepalive 32;同时在代理配置里配合:
proxy_http_version 1.1;
proxy_set_header Connection "";
这样可以启用到后端的 HTTP/1.1 长连接,减少 TCP 连接建立次数,对吞吐量和响应延迟都有帮助。
TLS 重点看协议版本、套件和会话复用
HTTPS 场景下,建议ssl_protocols只启用 TLSv1.2 和 TLSv1.3,禁用过时的 SSLv3 和 TLSv1.1。加密套件可选择如TLS_AES_128_GCM_SHA256这样的高性能方案。
为了减少重复握手,还可以开启:
ssl_session_cache shared:SSL:10m;
ssl_session_timeout 10m;
会话复用在高并发 HTTPS 场景下尤其有价值,能直接降低握手带来的额外时延。
最后一环是日志和监控
真正有用的调优,不是“改完就结束”,而是改完后能持续看到效果、发现回退并定位新瓶颈。日志和监控就是这一步的基础设施。
日志不要放大无效磁盘 I/O
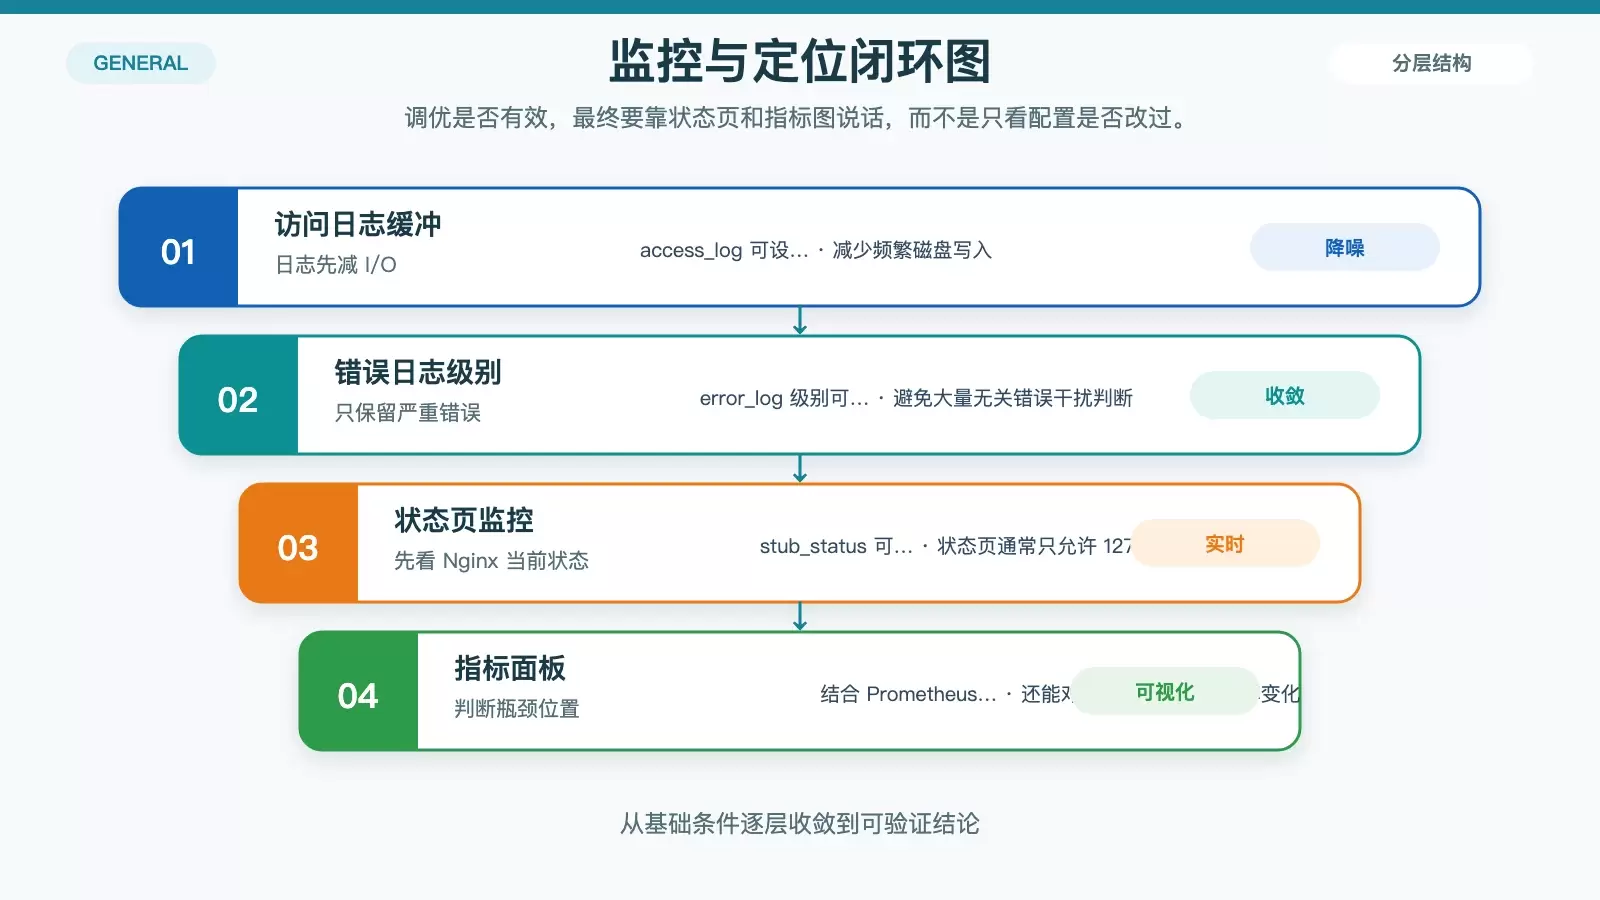
access_log可以设置缓冲参数,例如buffer=32k flush=300s,以减少频繁写盘。error_log则可根据需要收紧到crit级别,只记录严重错误,避免无关日志淹没有效信号。
状态页和指标系统决定你能不能找到瓶颈
通过stub_status模块,可以暴露一个只允许本机访问的状态页:
location /nginx_status {
    stub_status on;
    allow 127.0.0.1;
    deny all;
}
这样可以实时查看活跃连接数、请求总数等指标。进一步结合 Prometheus + Grafana,把 QPS、响应时间、错误率可视化,才更容易判断问题到底出在连接数、后端处理能力,还是缓存命中率上。
归纳来看,Nginx 性能调优最容易出错的地方,不是某个参数没抄全,而是只改单点、不看链路。更稳妥的顺序通常是:先核对配置与系统上限,再处理缓存与建连开销,最后用监控验证每一步是否真的带来了收益。















