


pandas使用get_dummies进行one-hot编码的方法

发布时间:2026-10-13 |
4人浏览过
本文介绍在pandas中利用get_dummies函数对离散特征进行one-hot编码的方法。针对无序分类特征如颜色,可直接使用get_dummies生成独热向量;针对有序特征如尺码,则建议先通过字典映射转换为数值。文章提供了具体的DataFrame构建、映射及编码代码示例,帮助开发者高效完成数据预处理。
离散型特征的编码方式主要依据特征取值间的逻辑关系,通常分为两种情况:
第一种情况是离散特征的取值之间不存在大小或顺序关系,例如颜色特征包含[red, blue]。对于此类无序分类变量,应当采用one-hot编码(独热编码)进行处理。
第二种情况是离散特征的取值具有明确的大小或顺序意义,例如尺码特征包含[X, XL, XXL]。对于此类有序分类变量,更合适的做法是使用数值映射,例如将X映射为1,XL映射为2,XXL映射为3。
在Python的数据处理库pandas中,可以非常方便地对离散型特征执行one-hot编码操作。
import pandas as pd
df = pd.DataFrame([
   ['green', 'M', 10.1, 'class1'],
   ['red', 'L', 13.5, 'class2'],
   ['blue', 'XL', 15.3, 'class1']])

df.columns = ['color', 'size', 'prize', 'class label']

size_mapping = {
   'XL': 3,
   'L': 2,
   'M': 1}
df['size'] = df['size'].map(size_mapping)

class_mapping = {label:idx for idx,label in enumerate(set(df['class label']))}
df['class label'] = df['class label'].map(class_mapping)
需要说明的是,对于具备大小意义的离散特征,直接使用字典映射即可满足需求,无需进行one-hot编码。例如,可以定义映射关系{'XL': 3, 'L': 2, 'M': 1},将文本标签直接转换为对应的数值。
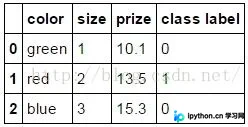
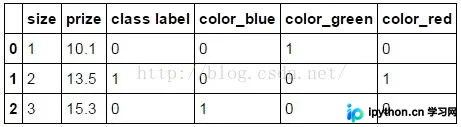
Using the get_dummies will create a new column for every unique string in a certain column:使用get_dummies进行one-hot编码
pd.get_dummies(df)
以上关于在pandas中使用get_dummies进行one-hot编码的方法即为全部内容,希望能为读者提供参考,并欢迎大家继续支持本站获取更多技术资讯。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















