


使用pandas高效读取含中文数据的CSV文件

发布时间:2026-10-13 |
6人浏览过
本文介绍如何利用pandas库直接读取包含中文字符的CSV数据集,避免手动批量替换清理数据的繁琐过程。通过示例演示如何加载数据、按行号选取数据、提取指定列以及获取特定单元格值,为处理类似西瓜书等包含中文标签的数据集提供简洁方案。
在使用numpy读取非数值型数据时,通常需要进行额外的格式转换,而在Python 3环境下处理中文数据曾较为棘手。近期学习周志华教授的《机器学习》(俗称西瓜书)时,需要反复处理包含中文标签的数据集。以往的做法是通过批量替换来预先清理数据,但这种方法过于繁琐。近日发现,利用pandas库可以直接读取包含中文的CSV数据集,从而简化操作流程。
首先展示所使用的数据集内容:
编号,色泽,根蒂,敲声,纹理,脐部,触感,密度,含糖率,好瓜
1,青绿,蜷缩,浊响,清晰,凹陷,硬滑,0.697,0.46,是
2,乌黑,蜷缩,沉闷,清晰,凹陷,硬滑,0.774,0.376,是
3,乌黑,蜷缩,浊响,清晰,凹陷,硬滑,0.634,0.264,是
4,青绿,蜷缩,沉闷,清晰,凹陷,硬滑,0.608,0.318,是
5,浅白,蜷缩,浊响,清晰,凹陷,硬滑,0.556,0.215,是
6,青绿,稍蜷,浊响,清晰,稍凹,软粘,0.403,0.237,是
7,乌黑,稍蜷,浊响,稍糊,稍凹,软粘,0.481,0.149,是
8,乌黑,稍蜷,浊响,清晰,稍凹,硬滑,0.437,0.211,是
9,乌黑,稍蜷,沉闷,稍糊,稍凹,硬滑,0.666,0.091,否
10,青绿,硬挺,清脆,清晰,平坦,软粘,0.243,0.267,否
11,浅白,硬挺,清脆,模糊,平坦,硬滑,0.245,0.057,否
12,浅白,蜷缩,浊响,模糊,平坦,软粘,0.343,0.099,否
13,青绿,稍蜷,浊响,稍糊,凹陷,硬滑,0.639,0.161,否
14,浅白,稍蜷,沉闷,稍糊,凹陷,硬滑,0.657,0.198,否
15,乌黑,稍蜷,浊响,清晰,稍凹,软粘,0.36,0.37,否
16,浅白,蜷缩,浊响,模糊,平坦,硬滑,0.593,0.042,否
17,青绿,蜷缩,沉闷,稍糊,稍凹,硬滑,0.719,0.103,否
接下来,使用pandas将该数据集读取到程序中:
import pandas
d = pandas.read_csv(r"d:\data.csv",sep=",")
print(d)
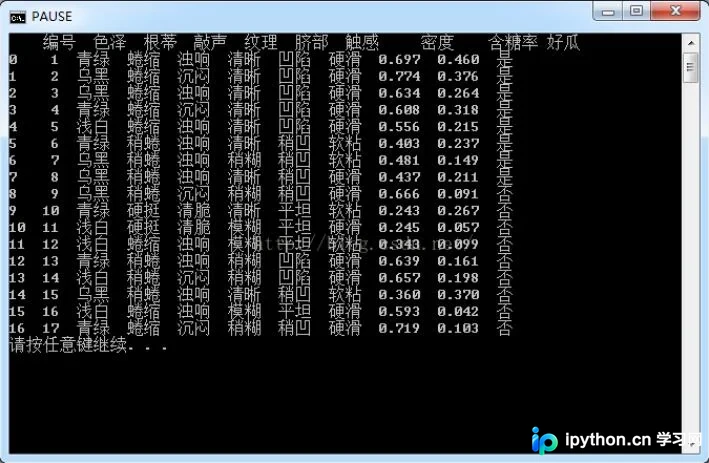
若需选取数据集中的某一行,可以使用head()方法:
d.head(1)
该方法的参数指定了要选取的行号。
此外,也可以直接提取某一列的数据,例如:
d['色泽']
若需获取某个具体数据点,可结合上述两种方法实现:
d.head(1)['色泽']
以上即为利用pandas读取中文数据集的具体方法,希望能为读者提供参考,并欢迎大家支持相关技术社区。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















