


Python使用Pandas高效处理百万行CSV数据实战

本文介绍如何利用Python的Pandas库高效处理超过140MB、170万行的CSV文件。对比MySQL导入卡顿和R语言加载缓慢的问题,展示Pandas在快速读取、列操作、分组聚合及生成透视表方面的优势,并提供完整的代码示例与处理流程。
背景与工具选择:为何选用Pandas
近日接到一项任务,需处理一个容量超过140MB的CSV文件,数据量高达170多万行。起初尝试将数据导入本地MySQL数据库进行查询,但使用Navicat导入时直接导致软件卡死。推测原因是XAMPP套件中MySQL的默认配置性能不足。随后尝试使用R语言处理,发现仅加载该CSV文件就耗时约3分钟,效率极低。经过查阅资料,发现Python中的Pandas库是处理此类数据的利器。使用该库加载这140多MB的CSV文件仅需两秒,后续的分类汇总等操作也均能瞬间完成,性能表现卓越。以下记录本次数据处理的具体流程。
环境配置与安装
环境要求:使用Python 3.6.4版本(该版本对中文支持较好),并安装Pandas库。
pip install pandas
数据预处理与分组聚合
基本操作步骤如下:
import pandas as pd
import numpy as np #进行具体的sum,count等计算时候要用到的
df=pd.read_csv('d:/snp/nh23.csv') #这里绝对路径一定要用/,windows下也是如此,不加参数默认csv文件首行为标题行
df.head() #查看引入的csv文件前5行数据
df[“播种面积”] #查看指定列,后面跟[:5]查看前5行数据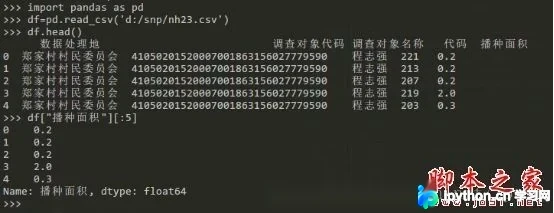
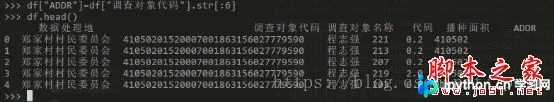
df["调查对象代码"].str[:6] # 获取指定列前6位字符串
df["ADDR"] = df["调查对象代码"].str[:6] # 将上一行处理后的6位地址码作为新列ADDR插入
gp = df.groupby(["ADDR", "代码"])["播种面积"].sum() # 根据ADDR和代码进行分组后对播种面积列进行sum求和计算
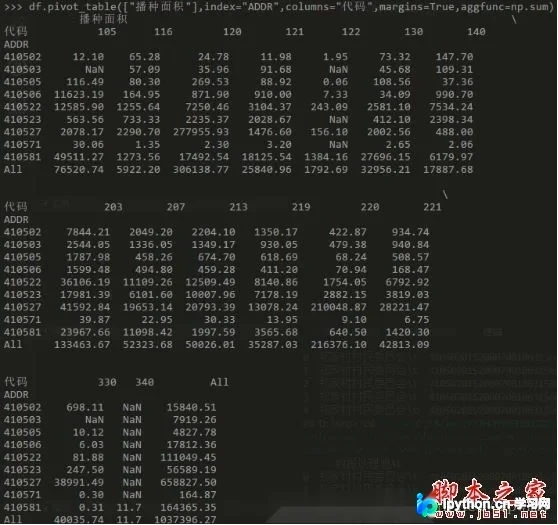
pv=df.pivot_table(["播种面积"],index="ADDR",columns="代码",margins=True,aggfunc=np.sum,fill_value=0) #数据透视图,对播种面积列进行汇总计算,index为行,columns为列,margins=True增加一个全部行汇总,aggfunc=np.sum透视图中对播种面积值进行sum计算,这里np是开头import的numpy as np,fill_value=0对空值进行0替换,否则没有数据会显示NaN
pv.to_csv("d:/snp/test.csv") #写入csv文件总结与致谢
总结
以上介绍了使用Python Pandas处理CSV文件的方法,希望能为读者提供帮助。如有任何疑问,欢迎留言,小编会及时回复。感谢大家对本站的支持! 如果您觉得本文对您有帮助,欢迎转载,请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















