



后台系统里常见的 JSON 数据,平时看起来只是“一个文件”,一旦体积涨到 GB 级,处理方式就会直接决定程序能不能活下来。本文不讨论复杂框架,而是回到 Go 标准库本身,拆开 `json.Unmarshal` 为什么容易把内存顶满,再用 `json.Decoder` 的流式解析方式,说明超大 JSON 数组该怎样稳定读取、逐条处理,以及什么情况下它才真正能把内存控制住。
为什么 `json.Unmarshal` 容易把内存打满
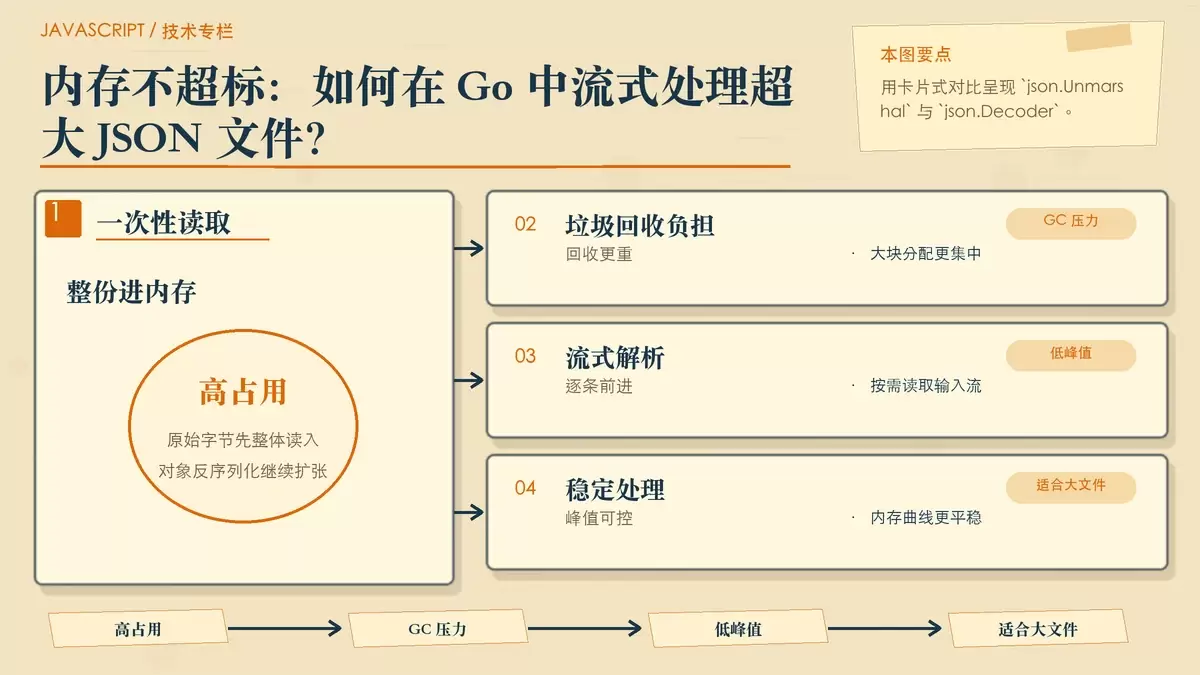
在小文件场景下,先读完整个文件,再一次性反序列化,写法直接也容易理解。但当 JSON 文件达到数 GB,这种方式的问题就会立刻暴露出来:程序不仅要拿出足够大的内存保存原始字节,还要为反序列化后的对象分配额外空间。
// 坏味道:一次性读取大文件解析
data, _ := os.ReadFile("large_data.json")
var records []Record
_ = json.Unmarshal(data, &records)
这段代码的风险不在于语法,而在于资源模型。`os.ReadFile("large_data.json")` 先把整份文件放进 `data`,随后 `json.Unmarshal(data, &records)` 又会继续生成一整批结构体对象。文件越大,内存峰值越高,而且这类大块分配会让 Go 的垃圾回收器承担更重的扫描压力。
结果通常有两个:一种是进程内存迅速膨胀,逼近机器上限;另一种是即便还没 OOM,GC 也可能因为要处理大量对象而带来明显停顿。对数据库备份、导出归档、海量日志这类任务来说,这种“整读再整解”的方式通常不适合作为默认方案。
`json.Decoder` 为什么更适合超大文件
真正有效的思路,是把“整读”换成“渐读”。Go 标准库里的 json.Decoder 基于 io.Reader 工作,可以一边从底层输入流读取字节,一边完成解析,而不是要求先把全部内容放进内存。
这种模式尤其适合处理“一个超大 JSON 数组里装了很多元素”的场景。原因很简单:程序不需要同时持有整个数组里的全部记录,而是可以读取一条、解析一条、处理一条,随后让已经用完的对象尽快被回收。
也就是说,内存消耗不再随文件体积线性上涨,而更多取决于当前正在处理的那一小部分数据。如果处理逻辑本身不额外囤积对象,内存曲线通常会稳定得多。
如何流式解析超大的 JSON 数组
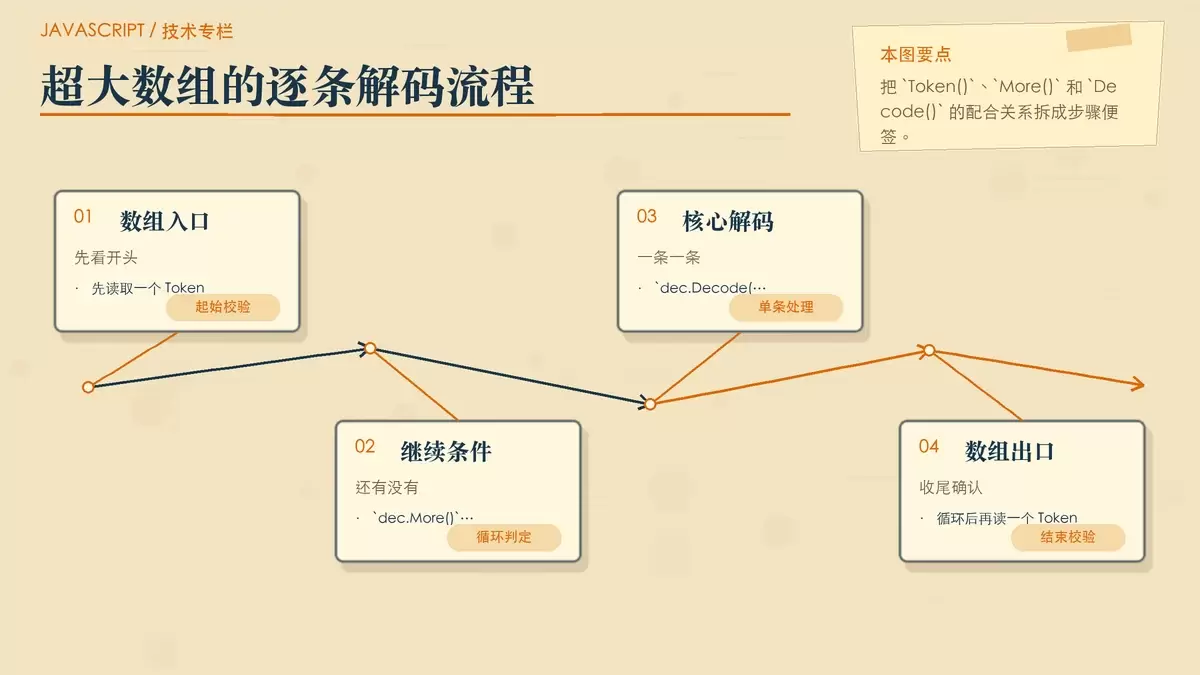
处理大数组时,常见做法是配合 json.Decoder.Token()、More() 和 Decode() 来完成逐步读取。先创建解码器,并确认输入流开头确实是数组起始符号 [:
dec := json.NewDecoder(file)
t, err := dec.Token()
if err != nil || t != json.Delim('[') {
    log.Fatal("expected array start delimiter")
}
dec.Token() 会返回 JSON 流中的下一个标记。对于一个标准 JSON 数组来说,最先读到的就应该是 [。这一步的意义不只是“取一个符号”,更是在正式进入循环前先校验输入格式是否符合预期。
确认起始符正确后,就可以进入主循环,按元素逐条解码:
for dec.More() {
    var r Record
    if err := dec.Decode(&r); err != nil {
        log.Fatal(err)
    }
    process(r) // 处理解析完成的单条记录
}
这里的关键点有两个。
用 `dec.More()` 判断数组里是否还有元素
dec.More() 会检查当前数组上下文中是否还存在未读取的内容。只要还有元素,循环就继续;当数组读完时,循环自然结束。
用 `dec.Decode(&r)` 只解析当前这一条
每次调用 dec.Decode(&r),解码器只会消费当前元素对应的那部分字节,并把结果写入 `Record`。这意味着程序不需要等待整个数组全部解析完成,拿到一条记录后就能立刻执行 `process(r)`。
如果 `process(r)` 是过滤、写库、聚合计数或投递消息,那么这类任务都可以边读边做。只要不把所有 `r` 再次塞回一个切片中,整体内存占用通常能被压在很低的范围内,文中给出的量级是例如 10 MB 以内。
循环结束后,还要把数组结束符号 ] 读出来并做一次校验:
t, err = dec.Token()
if err != nil || t != json.Delim(']') {
    log.Fatal("expected array end delimiter")
}
这样,一个超大 JSON 数组就能在持续、低峰值内存的状态下被完整处理。无论数据是 1 GB 还是 10 GB,只要底层读取和单条处理逻辑可控,这种写法都比一次性反序列化更稳。
哪些场景最适合用流式解析
`json.Decoder` 的价值,主要体现在“数据量大、不能整批压进内存、而且可以逐条处理”的任务里。常见场景包括下面几类:
- 海量日志与审计数据分析:服务器日志、安全审计轨迹往往会被归档成很大的 JSON 数组,逐条读取后即可完成过滤、聚合或告警提取。
- 数据库备份与数据导入导出:例如 NoSQL 数据库导出的 GB 级 JSON 备份,适合边解析边写入目标库,减少导入任务对机器内存的冲击。
- 第三方大文件 API 对接:某些开放平台一次返回数十万条记录,若直接整批读入,很容易让业务进程因瞬时内存暴涨而不稳定。
- 实时监控与事件流订阅:面对 HTTP Chunked 响应或 WebSocket 持续到来的 JSON 事件流,流式解码比先缓存后解析更贴近真实的数据形态。
- 边缘设备与嵌入式环境:当运行环境只有数十兆内存时,流式处理通常不是“优化项”,而是系统能否正常工作的前提。
- 大模型流式输出解析:在接收大模型 Stream 返回的结构化 JSON 内容,比如 Tool Calls 时,按流逐步恢复结构,比等待完整内容落地后再统一解析更实用。
工程落地时还要注意什么
流式解析并不等于只要换成 `json.Decoder` 就万事大吉,实际项目里至少要盯住两个问题。
底层 `Reader` 必须真的是流式来源
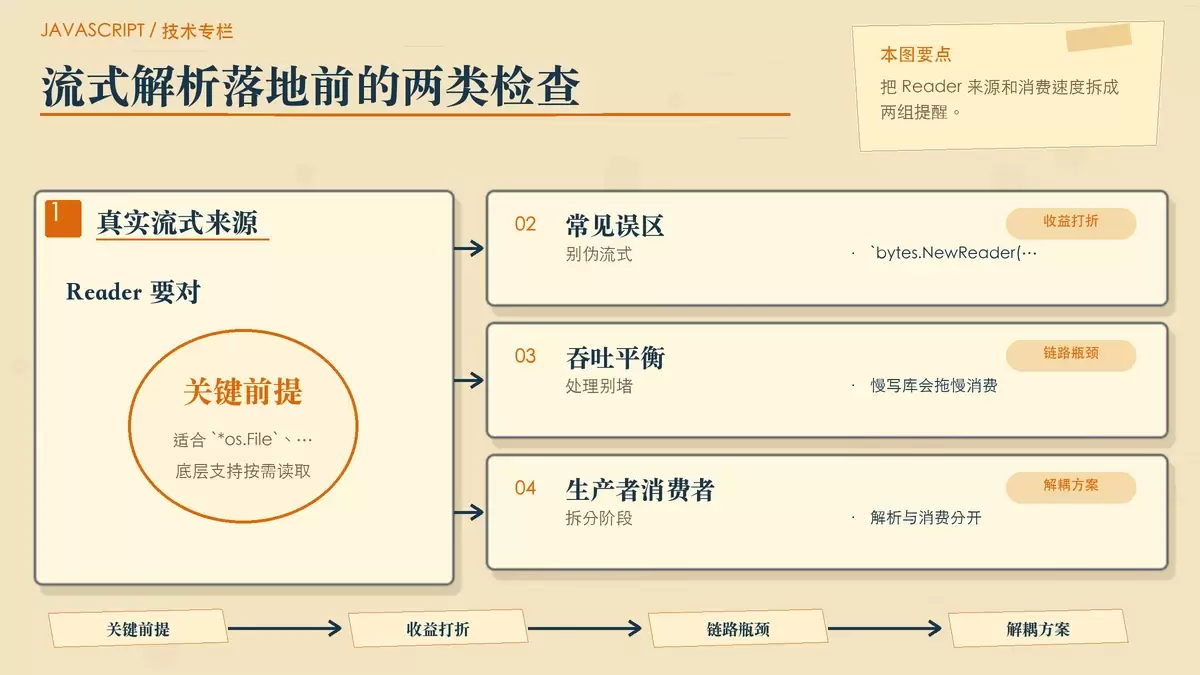
如果传给 json.NewDecoder 的是 *os.File、net.Conn 这类本身就支持按需读取的对象,那么流式解析才有意义。相反,如果数据已经通过别的方式一次性读进内存,再用 bytes.NewReader(data) 包一层,解析过程虽然写法上仍是“流式”,但内存优化收益会明显打折。
解析速度和消费速度要匹配
逐条解码只是第一步,真正的瓶颈常常出现在后面的处理逻辑里。比如单条记录要写数据库、调外部 HTTP 接口,或者执行比较重的计算,那么消费速度一旦跟不上输入速度,底层缓冲区就可能持续堆积。
在高并发或高吞吐场景下,更稳妥的做法通常是把“解析”和“处理”拆开:前面负责持续从流里读数据,后面通过带缓冲的 channel 按生产者-消费者模式异步消费。这样可以避免让单条慢操作直接拖住整个输入链路。
总结来看,处理超大 JSON 时,重点不是“能不能解析”,而是“能不能以稳定资源占用持续解析”。如果数据可以按条处理,Go 标准库提供的 `json.Decoder` 基本就是这类任务的首选工具。















