



Go 项目里,Benchmark 一直是性能判断的基础工具,但很多团队写久了都会碰到同样的问题:代码明明能跑,结果却未必可信。`testing.B.Loop()` 在 Go 1.24 中出现后,解决的正是这些长期存在的细节坑。下面就从传统写法的问题、`b.Loop()` 的改进点、版本注意事项和使用边界几部分来看,什么时候该切、切过去能得到什么。
传统 Benchmark 为什么容易写得别扭
在 Go 里,最常见的基准测试写法是围绕 b.N 做循环。这种方式并非不能用,但有两个问题几乎每个写过微基准测试的人都遇到过。
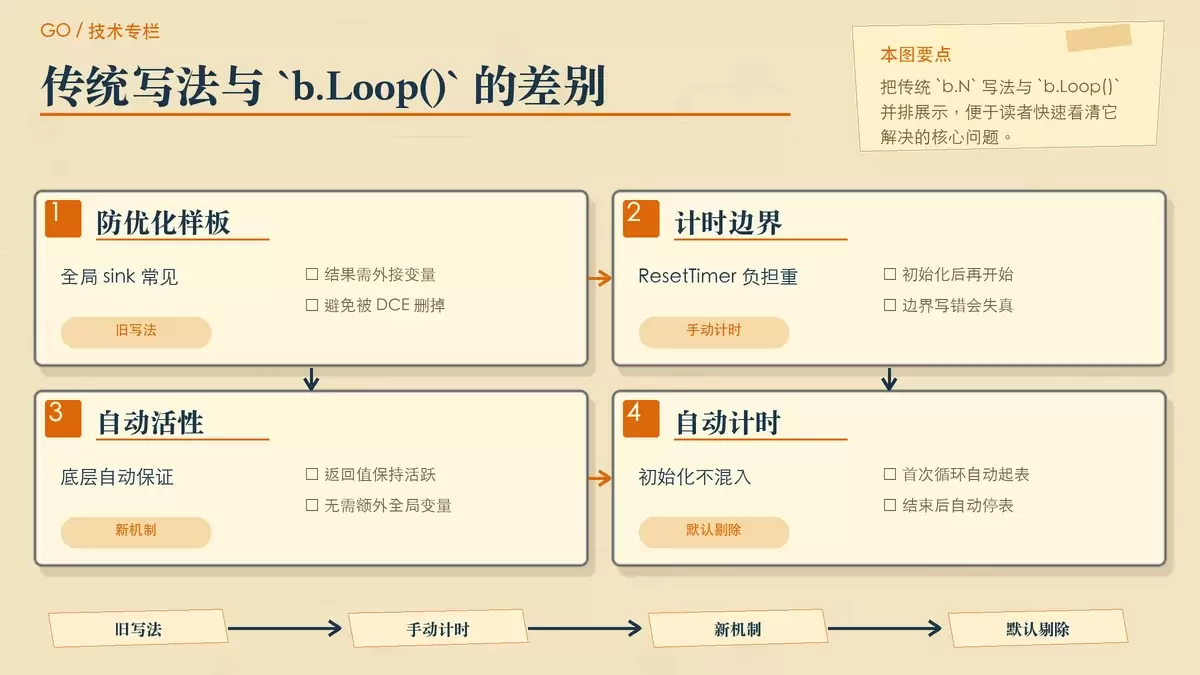
问题一:结果没被使用,可能被编译器直接优化掉
如果循环里的函数调用结果没有被后续代码消费,编译器可能会把这段逻辑当作无效代码消掉。这样一来,测试表面上正常执行,实际测到的却不是目标函数的真实成本。
传统写法因此经常要额外引入一个全局变量,把结果“接住”,只为了阻止死代码消除。
var sink int

func BenchmarkClassic(b *testing.B) {
    setupExpensiveData()
    b.ResetTimer()
    for i := 0; i < b.N; i++ {
        sink = processString("42")
    }
}
这段代码里的 sink 并不是业务需要,而是一种防御性写法。Benchmark 一多,这类样板代码会迅速扩散,影响可读性,也让新人很难判断哪些语句是在测性能,哪些只是为了对抗编译器优化。
问题二:初始化、清理和计时边界要手动维护
另一个高频痛点是计时器管理。像 setupExpensiveData() 这样的准备工作通常不应算进最终耗时,因此开发者需要在恰当时机调用 b.ResetTimer(),有时还会配合 b.StopTimer()、b.StartTimer()。
问题不在于这些 API 难用,而在于它们要求你始终清楚“哪一段算测试主体,哪一段不算”。一旦边界放错,Benchmark 数字看起来很整齐,结论却可能已经偏了。
`b.Loop()` 到底解决了什么
Go 1.24 引入的 testing.B.Loop(),本质上是把“循环执行多少次”和“哪些代码应该被计时”交回给测试框架处理。开发者需要做的,只是把基准测试主体放进 for b.Loop() 里。
func BenchmarkLoop(b *testing.B) {
    setupExpensiveData()
    for b.Loop() {
        processString("42")
    }
}
这个写法看起来只是少了 b.N 和 sink,但背后的意义更大,主要体现在三个方面。
自动保证活性,少写一层“防优化”代码
使用 b.Loop() 后,编译器和测试框架会协同保证循环体内相关变量与返回值保持活跃状态。换句话说,很多过去必须依赖全局 sink 才能避免的优化,现在由底层机制接管了。
这让 Benchmark 更接近“我想测什么,就直接写什么”,减少了与业务无关的陪衬代码。
自动处理计时起止,初始化不会被误算
在第一次调用 b.Loop() 时,计时器会自动重置;循环结束后,计时也会自动停止。这样像初始化、尾部清理这样的非核心开销,默认就不会混进结果里。
对日常维护来说,这个变化非常实际。它不只是少写一行 b.ResetTimer(),而是降低了计时边界写错的概率。
运行模型更直接,减少围绕 `b.N` 的心智负担
传统 Benchmark 需要围绕 b.N 的校准方式来理解测试如何收敛,开发者也常常会下意识去关注“循环次数是不是合适”。而 b.Loop() 把这部分机制封装得更完整,使用时只需专注被测代码本身。
因此它带来的收益不只是简洁,更是把 Benchmark 的关注点重新拉回到“结果是否可信”。
使用前要注意的版本问题
b.Loop() 并不是一上线就毫无边角。在 Go 1.24 早期版本里,曾出现过一个与编译器实现相关的缺陷,即 Go Issue #73137。
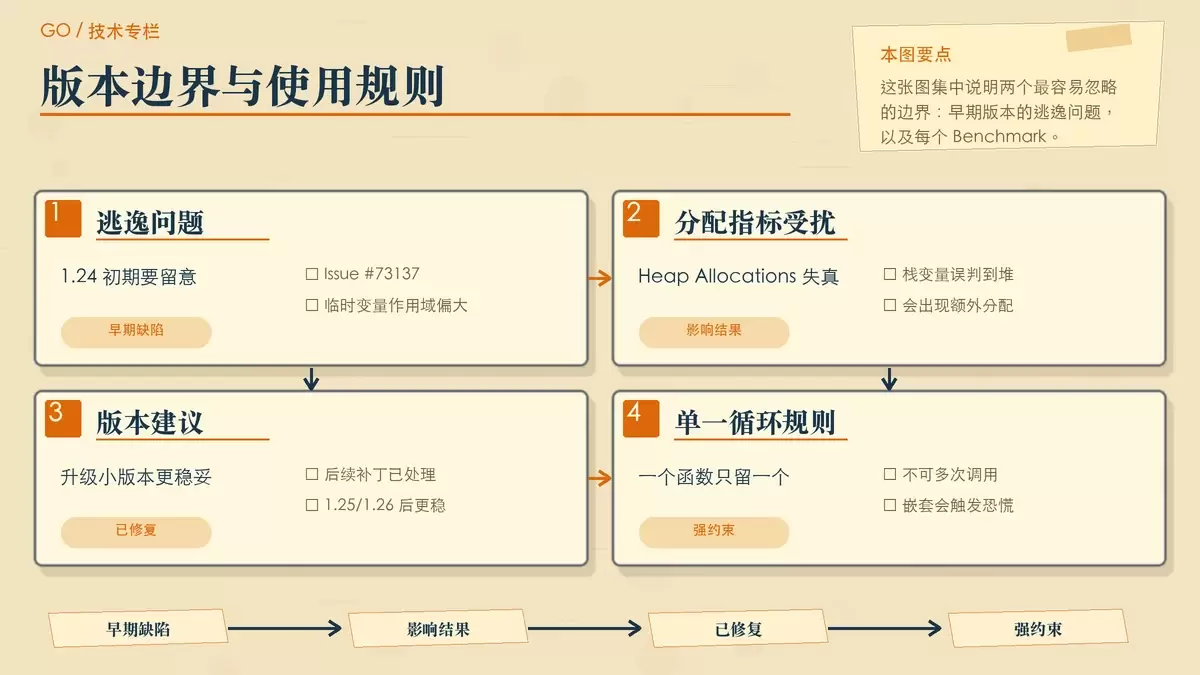
问题出在底层为了维持变量活跃性而生成的临时变量作用域偏大,导致一部分原本应留在栈上的局部变量,被错误判断为逃逸到堆上。放到 Benchmark 场景里,结果就是出现了意外的堆分配,也就是 Heap Allocations,进而干扰对微观分配行为的判断。
这个缺陷已经在后续补丁版本,以及 1.25、1.26 之后的版本中得到修复。实际使用时可以这样判断:
- 如果你主要关心吞吐、耗时,且已在较新的 Go 版本上运行,
b.Loop()可以直接采用。 - 如果你正在写对分配次数、逃逸行为非常敏感的微基准测试,最好确认 Go 小版本已经包含相关修复。
也就是说,b.Loop() 的方向没有问题,但对依赖分配指标做精细判断的场景,版本足够新这件事仍然重要。
进阶用法和一个必须守的规则
虽然 b.Loop() 简化了常规写法,但它也有明确边界,不能把它当成普通循环随意嵌套。
一个 Benchmark 里只能有一个 `for b.Loop()`
每个 Benchmark 函数内部只能存在一个 for b.Loop()。如果在同一个函数中多次调用,或者写成嵌套形式,运行时会直接触发恐慌。
这条规则意味着,基准测试的结构应该尽量围绕“单一核心路径”来组织。若要比较多种分支,更适合拆成不同的 Benchmark,或通过子基准测试分别覆盖,而不是在一个函数里堆多个 b.Loop()。
迭代内仍可手动排除局部开销
自动计时并不等于完全不能手动干预。如果某些准备动作发生在每次迭代内部,但你仍不希望把它们计入结果,可以继续使用 b.StopTimer() 和 b.StartTimer() 控制局部区间。
func BenchmarkIterControl(b *testing.B) {
    for b.Loop() {
        b.StopTimer()
        temp := getIterData()
        b.StartTimer()
        processString(temp)
    }
}
这里的思路很明确:每轮都需要调用 getIterData() 准备数据,但最终只统计 processString(temp) 的执行成本。也就是说,b.Loop() 负责收拾大部分通用问题,而更细粒度的计时边界,你仍然可以自己定义。
什么时候值得把老 Benchmark 迁到 `b.Loop()`
如果项目已经全面使用 Go 1.24 或更高版本,迁移到 b.Loop() 基本是顺势而为,尤其适合下面几类 Benchmark:
- 当前依赖全局
sink变量来防止优化的测试。 - 测试前后存在初始化、清理逻辑,且经常需要手动调用
b.ResetTimer()的代码。 - 团队成员较多,Benchmark 风格不统一,结果边界容易写乱的项目。
相反,如果你维护的是一批对历史结果强依赖的性能基线,且其中包含大量对分配行为极敏感的微基准,那么迁移时最好结合 Go 版本、分配统计和回归数据一起验证,而不是只看代码写法是否更简洁。
从整体看,b.Loop() 的价值不在“换一种更潮的语法”,而在于它把 Benchmark 里最常见、也最容易出错的两件事标准化了:防止无意义优化,以及划清计时边界。对需要长期维护性能测试的人来说,这比少写几行代码更重要。















