



接口明明只返回前 100 条记录,进程内存却一直居高不下;日志解析只保留几 KB 头部,几十 MiB 的缓冲区却迟迟没有释放。很多人第一反应是 GC 不够积极,但这类现象在 Go 里更常见的根因,其实是小切片仍然挂着大数组的引用。本文会从切片和底层数组的关系讲起,再说明哪些场景必须复制、哪些场景可以直接截取,以及线上排查时该重点看什么。
切片变小了,底层数组并没有变小
Go 的切片不是数组本身,更准确地说,它是一个描述底层数组的“窗口”。这个窗口里记录了三件事:指向底层数组的指针、当前长度和容量。截取切片时,变的是窗口看到的范围,不是背后的数组内容。
例如下面这段代码,只拿了前 10 个字节:
big := make([]byte, 100<<20)
small := big[:10]
fmt.Println(len(small), cap(small))
small 的长度确实只有 10,但它仍然指向 big 对应的 100 MiB 底层数组。也就是说,业务上你可能只需要 10 个字节,运行时看到的却是“这 10 个字节所在的大数组仍然有人在用”。
这正是很多内存问题不容易一眼看出的原因:代码里留下的是一个很小的切片变量,真正被拖住的却是一整块大缓冲区。
为什么 GC 不会替你回收这块大内存
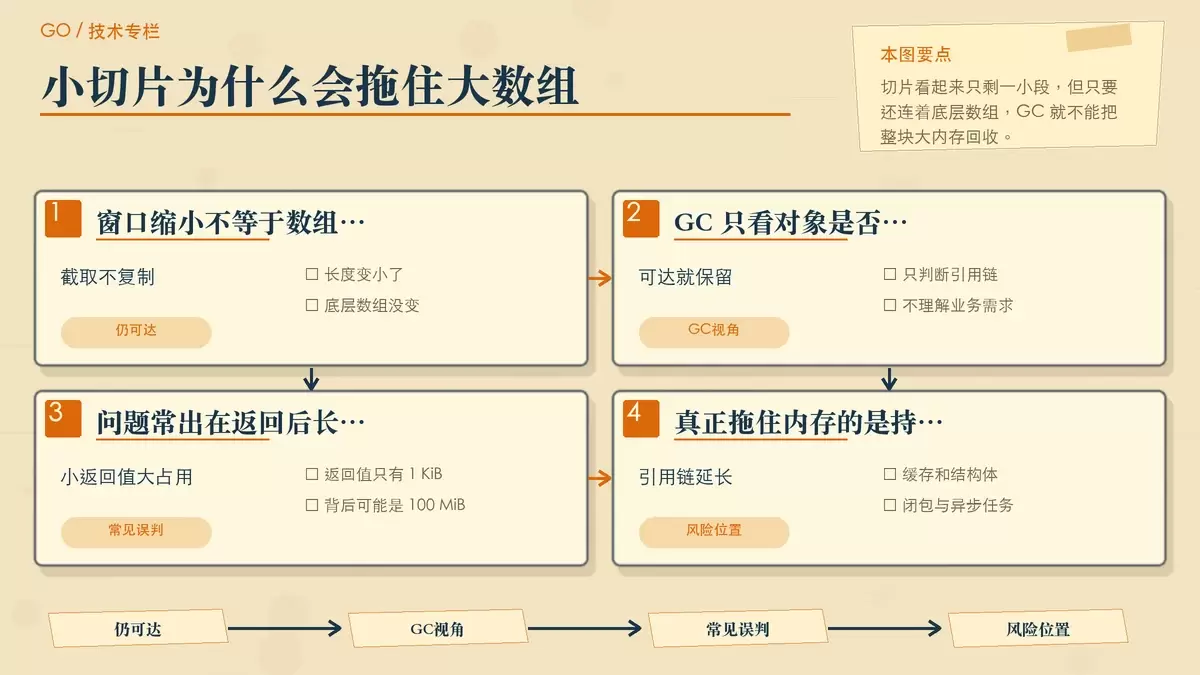
GC 判断对象是否回收,核心标准不是“你现在业务上还需不需要它”,而是“它是否仍然可达”。只要引用链还在,GC 就必须把那块对象当成存活数据处理。
下面这种函数在业务代码里非常常见:
func readPrefix() []byte {
    data := make([]byte, 100<<20)
    // 省略:读取文件或网络响应
    return data[:1024]
}
函数表面上只返回 1 KiB 数据,但返回值仍然连着那块 100 MiB 的底层数组。只要调用方继续持有这个返回值,GC 就不能释放那 100 MiB。
问题通常不是出在函数返回这一刻,而是出在返回后的去向。如果这 1 KiB 数据被放进缓存、保存到结构体字段、丢进异步任务闭包,或者进入消息队列等待后续处理,那么原本只想“留一点点”的场景,就会演变成大数组长期驻留。
这不是传统意义上“永远丢失引用”的内存泄漏,而是另一类更常见的内存保留问题:对象仍然可达,但业务上早就不值得继续保留。GC 的行为没有错,真正需要调整的是代码中的引用关系。
长期保存小片段时,要主动复制切断引用
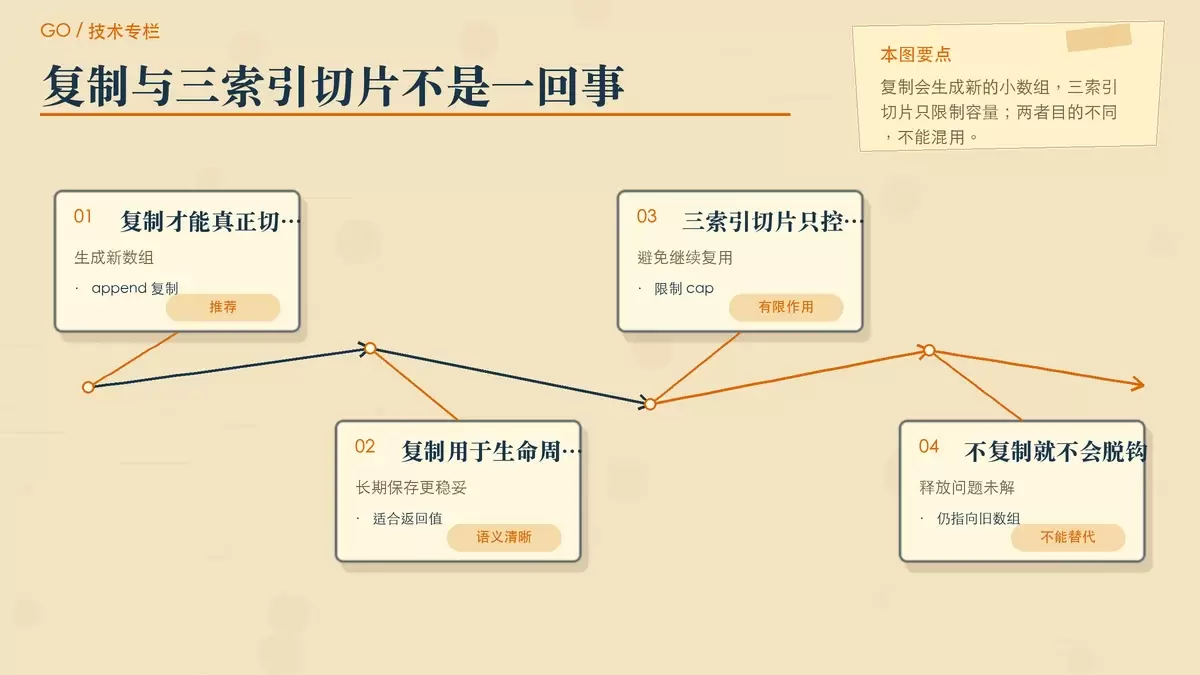
如果截取出的结果会比原始大缓冲区活得更久,就不该只做裸截取,而应该复制出一份新的小切片。这样返回值或缓存值持有的是新的小数组,不再依赖原来的大数组。
最常见的写法是用 append 复制:
func readPrefix() []byte {
    data := make([]byte, 100<<20)
    prefix := data[:1024]
    return append([]byte(nil), prefix...)
}
append([]byte(nil), prefix...) 会创建新的底层数组,再把 prefix 的内容拷贝进去。这样最终返回的切片只持有约 1 KiB 的新内存;原来的 100 MiB 数组如果没有其他引用,就可以在后续 GC 中被回收。
如果你希望语义更直接,也可以使用标准库里的 slices.Clone:
func readPrefix() []byte {
    data := make([]byte, 100<<20)
    return slices.Clone(data[:1024])
}
slices.Clone 的含义非常明确,就是复制切片本身。用于函数返回值、缓存内容、跨 goroutine 传递的数据时,代码意图通常也更清晰:这里不是简单地“取一段”,而是“留下这一段,并与原始缓冲区脱钩”。
一个简单判断标准是:如果截取结果的生命周期明显长于原始数据,而且原始数据又明显更大,那么复制通常就是应该付出的那点成本。
三索引切片能限制容量,但不能解决释放问题
不少人知道 Go 支持三索引切片,于是会尝试用它解决内存不释放的问题。这个思路只解决了一半,而且解决的不是“释放”,而是“后续追加会不会继续污染原数组”。
例如:
big := make([]byte, 100<<20)
small := big[:1024:1024]
fmt.Println(len(small), cap(small))
这里 small 的长度和容量都被限制为 1024。这样做的好处是,后面如果你对 small 执行 append,由于容量已经用满,运行时会触发新的分配,而不是继续向原来的大数组后面追加。
但这并不意味着原数组已经可以释放。因为三索引切片依然共享同一块底层数组:
big := make([]byte, 100<<20)
small := big[:1024:1024]
runtime.KeepAlive(small)
只要 small 活着,这块旧数组就仍然处在可达链上。换句话说,三索引切片只能控制容量边界,避免后续 append 继续使用原数组,但它本身不能切断引用,更不能替代复制。
所以在“要不要释放大数组”这个问题上,关键判断仍然没变:你是否创建了一份新的底层存储。如果没有,原数组就还在。
哪些场景必须复制,哪些场景可以直接截取
并不是所有切片截取都需要复制。函数内部的临时读取、临时校验、临时解析,很多时候直接截取完全没问题。只要这个小切片不会逃出当前生命周期,等外层对象整体不可达之后,大数组自然也会被回收。
更需要警惕的,是下面这些典型场景:
- 小切片会作为函数返回值返回给外部。
- 小切片会进入缓存、队列或全局状态。
- 小切片会保存到结构体字段中,跟随对象长期存在。
- 原始数据来自大文件、网络响应或对象池缓冲区。
- 原始数据是几十 MiB,而最终只想保留几 KB。
这些场景有一个共性:截取结果虽然小,但活得更久;原始数据虽然大,但其实只是一次性载体。只要两者生命周期不匹配,就很容易出现“小对象拖住大对象”的现象。
因此实战里可以记住一句更容易落地的话:如果保留下来的只是片段,而原始缓冲区又明显偏大,那么默认先考虑复制;只有在确认生命周期一致、且不会长期持有时,再选择直接截取。
线上排查时,重点看是谁持有了那个小切片
遇到这类问题时,不要只盯着 GC 次数、GC 耗时或者“为什么已经触发回收了内存还不降”。切片引用底层数组属于典型的可达对象问题,GC 再勤快,也不会释放仍在引用链上的数据。
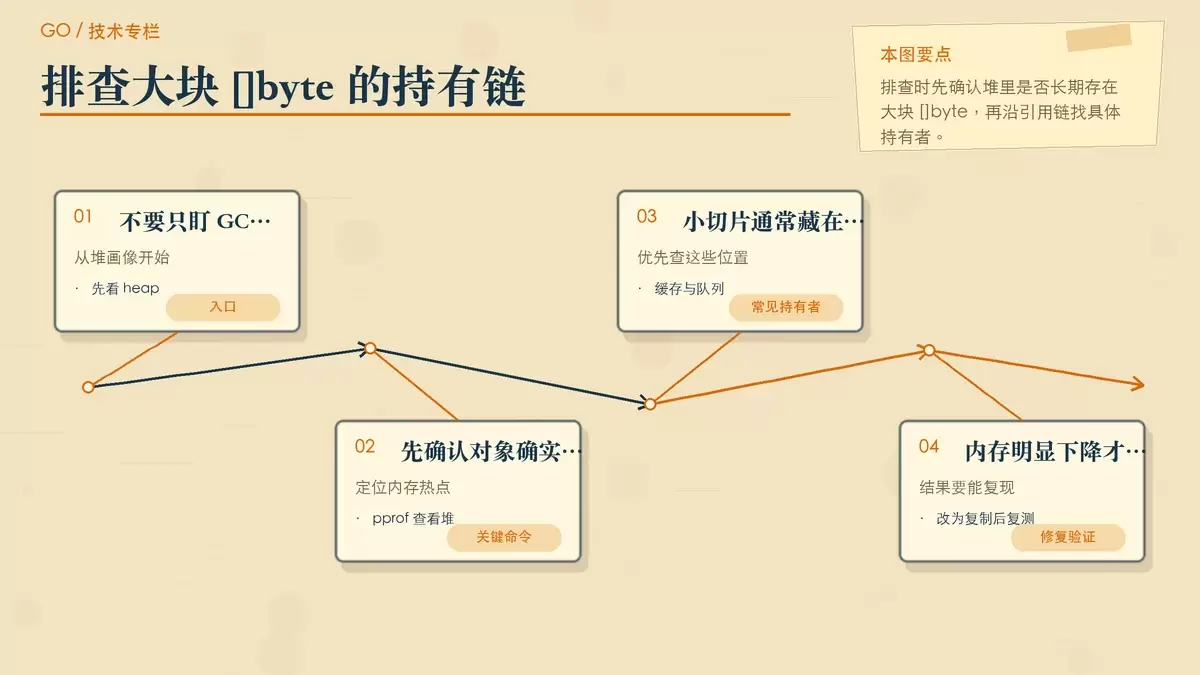
可以先通过堆分析确认是否存在长期驻留的大块 []byte:
go tool pprof http://localhost:6060/debug/pprof/heap如果你在堆画像里持续看到大块 []byte,下一步就不是继续猜 GC,而是沿着引用关系往上找:到底是谁握着那段只占几百字节或几 KB 的小切片。
常见持有位置包括缓存 map、解析结果结构体、消息队列、日志上下文字段,以及异步任务闭包。这些地方往往最容易出现“只存了一个小字段,结果拖住整块响应体”的情况。
修复后,再通过压测或复现脚本观察堆占用是否明显回落。如果在改成复制之后,堆内大块缓冲区明显减少,通常就可以基本确认:问题不在 GC 策略,而在切片共享底层数组导致的大对象被意外保留。
最后记住三条判断规则
Go 切片截取后大数组迟迟无法释放,本质上不是 GC 失效,而是小切片让底层数组一直保持可达。切片共享底层数组带来了高效,也顺带引入了很隐蔽的内存保留风险。
实际开发里,记住这三条规则通常就够用了:短期使用可以直接截取;长期保存小片段时要复制;三索引切片只能限制容量,不能替代复制。把这三点理顺,很多“内存怎么一直降不下来”的问题都会更容易定位,也更容易一次修对。















