



Go 标准库里的 I/O 设计,经常给人一种“接口小得过分”的第一印象。可一旦把它放进文件读写、HTTP、压缩流、内存缓冲区这些真实场景里,就会发现这套抽象之所以经久不衰,不是因为功能多,而是因为它把稳定边界和性能扩展分得很清楚。
这篇文章就从 io.Reader、io.Copy 和 io.WriterTo 三个层次往下拆:先看最小接口为什么能撑起这么多场景,再看标准库如何自动选择更高效的复制路径,最后梳理自定义类型实现这些接口时最容易踩到的语义边界。
小接口为什么更稳定
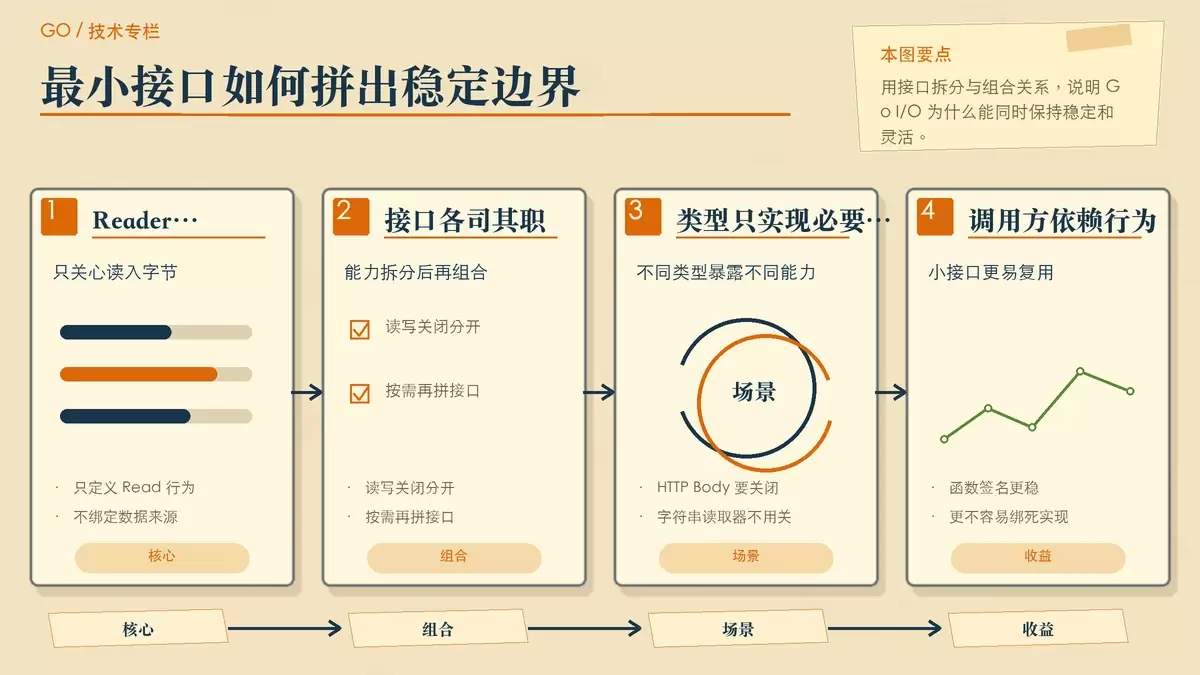
io.Reader 是 Go I/O 体系里最典型的“最小接口”。它的定义非常克制,只描述一件事:把数据读进调用方给出的缓冲区。
type Reader interface {
    Read(p []byte) (n int, err error)
}
对调用方来说,真正重要的是“能不能读到字节流”,而不是这些字节来自哪里。它可能来自文件、TCP 连接、字符串、压缩流,甚至对象存储 SDK;只要实现了 Read,上层代码就能工作。
这也是小接口耐用的原因。函数一旦依赖具体类型,就容易被文件路径、网络连接、特定库的对象绑定住;而当它只依赖一个 Read 行为时,可替换空间会大很多。接口越小,调用方被实现细节牵制的概率越低。
Go 标准库也没有把所有能力硬塞进一个“大接口”里,而是按行为拆分。负责读的是 io.Reader,负责写的是 io.Writer,负责释放资源的是 io.Closer。需要多个能力时,再做组合:
type ReadCloser interface {
    Reader
    Closer
}
这种设计的好处很直接。HTTP 请求体的类型是 io.ReadCloser,因为它既要被读取,也要在用完后关闭;字符串读取器只需要读,不需要关闭;网络连接既可能读也可能写。每种类型只暴露自己真实拥有的能力,业务函数则只声明当前场景最低限度的需求。
换句话说,Go I/O 的核心不是“接口很多”,而是“接口拆得足够细,组合也足够自然”。这让代码在长期演进时不容易因为需求变化而反复改签名。
`io.Copy` 真正做了什么
很多人会把 io.Copy 理解成“申请一个缓冲区,然后循环读写直到结束”。这个理解不算错,但它只覆盖了最基础的一层。
如果只看模型,逻辑大致确实是这样:
for {
    n, readErr := src.Read(buf)
    if n > 0 {
        if _, err := dst.Write(buf[:n]); err != nil { return err }
    }
    if readErr == io.EOF { break }
    if readErr != nil { return readErr }
}
这段思路说明了 io.Copy 的基本职责:从源读取,写到目标,处理结束和错误条件。真实实现里还会处理短写等边界,避免“看起来复制成功,实际只写出一部分数据”的问题。
但标准库并不满足于通用循环。真正关键的一步是,io.Copy 在进入普通读写流程前,会先检查有没有更高效的专用路径可走:
如果源对象实现了 WriterTo,优先调用 src.WriteTo(dst);如果源对象没有这个能力,再检查目标对象是否实现了 ReaderFrom,也就是调用 dst.ReadFrom(src)。
WriterTo 的定义同样很小:
type WriterTo interface {
    WriteTo(w Writer) (n int64, err error)
}
这个接口表达的意思不是“又多了一种复制方式”,而是“源对象自己知道怎样把剩余内容更高效地写出去”。对某些内存型数据源来说,这一点尤其重要,因为它们本来就知道内部数据布局,不一定非要走一遍最通用的缓冲区搬运逻辑。
像 bytes.Buffer、bytes.Reader、strings.Reader 这类类型,就可能通过这条路径减少额外开销。调用方并不需要在业务代码里手动分支判断,标准库会帮你完成选择。
`WriterTo` 和 `ReaderFrom` 如何让性能自然升级
Go I/O 抽象最耐用的一点,在于它没有把优化能力做成强制要求。普通类型只要实现 Read 或 Write,就能接入整个生态;只有在性能敏感、实现上也确实有更优路径时,才额外补充 WriterTo 或 ReaderFrom。
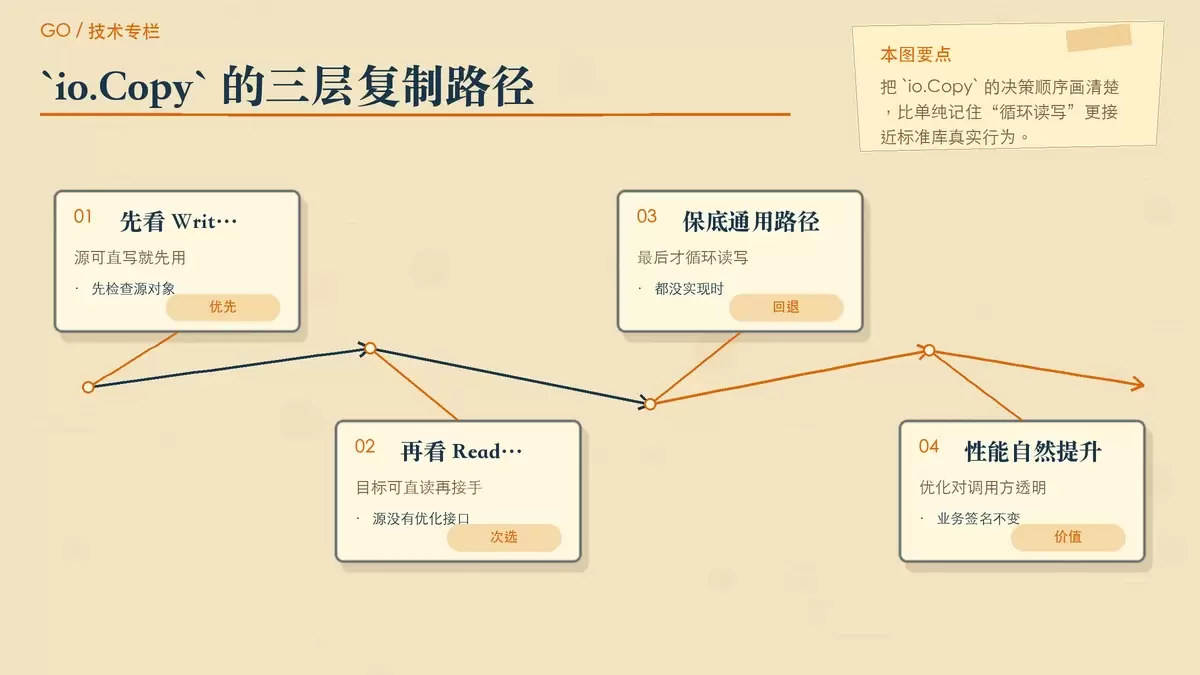
这让“先可用,再优化”变成一种天然的工程路径。业务函数不需要因为将来可能出现的性能需求,提前绑上更复杂的接口约束。标准库保留了最稳的基础面,同时给高性能类型留下升级通道。
可以用一个很小的实验观察 io.Copy 的选择顺序:
type src struct{ *strings.Reader }

func (s src) WriteTo(w io.Writer) (int64, error) {
    fmt.Println("src.WriteTo")
    return s.Reader.WriteTo(w)
}
当这个 src 实现了 WriteTo 之后,执行 io.Copy(dst, src) 时,会优先进入 src.WriteTo。只有源对象没有提供这条优化路径,io.Copy 才会继续检查目标对象是否实现了 ReadFrom。
这套机制带来的价值不只是“快一点”。它真正重要的地方在于:调用方代码完全不用改。函数签名还是接收 io.Reader 和 io.Writer,但底层类型一旦补上可选接口,复制路径就会自动升级。
这也是为什么很多业务代码可以长时间保持稳定。比如下面这个函数,抽象层次就刚刚好:
func save(dst io.Writer, src io.Reader) error {
    _, err := io.Copy(dst, src)
    return err
}
save 既可以把 HTTP 请求体写入文件,也可以把内存数据写入响应,还能把压缩流写入对象存储。场景扩展了,函数签名却不需要变化。测试时你还可以直接传一个内存 Reader,避免在单元测试里依赖真实文件或网络资源。
同样的设计思路,在哈希、压缩、加密、上传和下载这些场景里都成立。只要依赖的是“读取行为”,而不是“数据究竟来自哪个具体类型”,复用性和可测试性就会同时变好。
真正容易出问题的是语义边界
理解了这些接口的组合方式后,很多人会马上想到一个问题:既然 WriterTo、ReaderFrom 有优化价值,是不是自定义类型一开始就该全都实现?通常并不建议这样做。
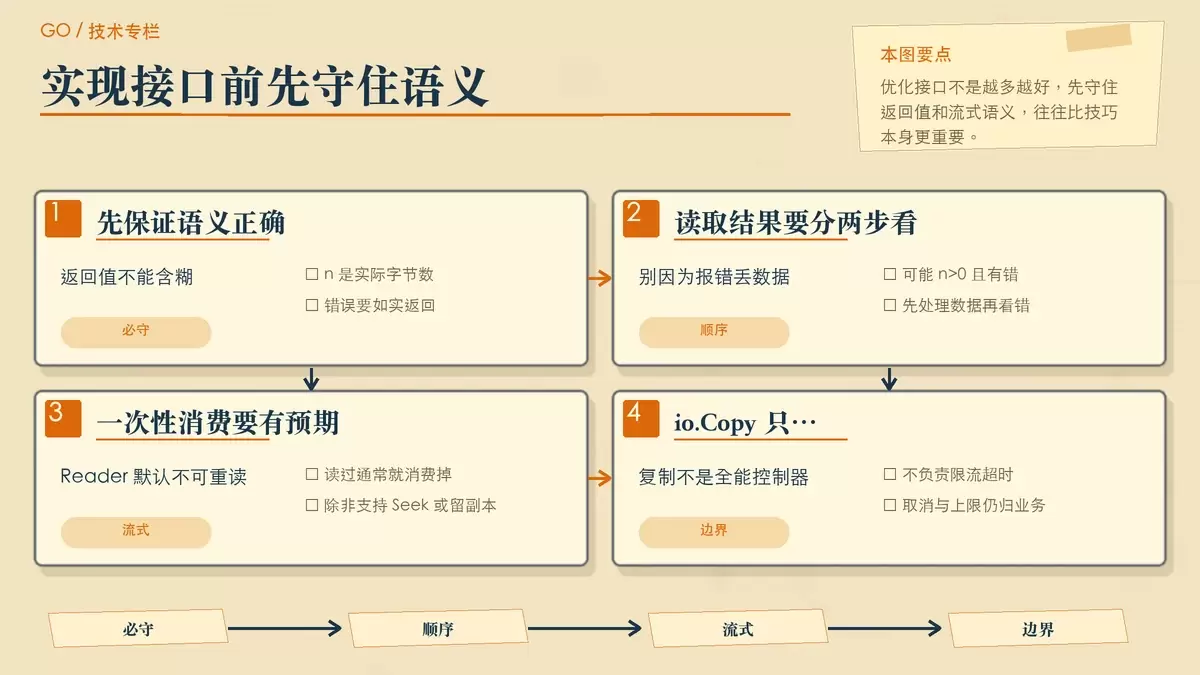
更稳妥的做法是,先把最基础的 Read 或 Write 实现正确,再根据性能分析结果决定是否补充可选接口。原因很简单:Go I/O 最重要的从来不是“技巧齐全”,而是“语义可靠”。
实现这些接口时,返回值语义必须非常严谨。n 表示的是已经实际传输的字节数,不能为了图省事随便填写;发生错误时,也要如实返回。为了优化而破坏这些约定,最后往往不是快,而是把问题埋进 io.Copy、压缩库或者 HTTP 处理链的边界里,排查起来会非常痛苦。
还有几个很常见的误区,也值得单独拎出来看:
`Reader` 是流,不默认支持重读
Reader 表达的是流式消费语义,不表示数据可以无限次重复读取。数据一旦读过,通常就被消费掉了。除非底层类型支持 Seek,或者业务自己保存了副本,否则不能假设“再读一次还能拿到相同内容”。HTTP Body 只能读取一次,就是最典型的例子。
先处理已读数据,再处理错误
Read 并不保证“有错误就一定没读到数据”。它完全可能在返回 n > 0 的同时,返回一个非空错误。调用方正确的处理方式,是先消费已经读到的数据,再根据错误决定是否结束或上抛。忽略这一点,往往会在边界条件下丢数据。
`io.Copy` 不会替业务兜底所有控制逻辑
即使走到了优化路径,io.Copy 也只是完成复制本身。限流、超时、取消、内存上限这些控制仍然是业务层自己的职责。不要因为标准库已经帮你处理了接口选择,就误以为所有传输问题都能自动解决。
这套抽象为什么能一直不过时
Go I/O 的耐用性,不在于它提供了多少接口,而在于这些接口足够克制。io.Reader 和 io.Writer 定义最稳定的公共语言,io.Closer、io.WriterTo、io.ReaderFrom 这些小接口则在需要的时候补充资源管理和性能能力。
结果就是:简单类型很容易接入,复杂类型也有明确的优化空间,而业务代码能长期停留在稳定的函数签名上。真正值得借鉴的,不只是某一个具体接口,而是这套工程方法本身:先用最小抽象表达行为,再用可选能力承载增强。
对日常开发来说,这也能转化成一个很实际的判断标准:当你在设计 API 时,先问自己“调用方到底需要哪一种行为”,而不是“我手头这个类型还能顺便暴露哪些能力”。很多可复用、可测试、也更不容易过时的代码,往往就是从这个取舍开始的。















