


Python3使用Requests和BeautifulSoup抓取赶集网列表数据教程

发布时间:2026-10-13 |
6人浏览过
本文详细介绍如何使用Python3结合Requests和BeautifulSoup模块爬取赶集网列表数据。文章涵盖环境配置、模块安装及核心代码实现,通过构造请求头模拟浏览器访问,解析HTML并提取标题信息,帮助开发者快速掌握基础爬虫技巧。
本文通过具体实例,展示如何利用Python3实现针对赶集网列表页面的数据抓取功能,供读者参考学习。
本文记录了使用Python3进行数据爬取的过程,重点演示如何抓取赶集网列表信息。相关代码逻辑清晰,易于上手实践。
执行前需确保已安装Python3环境。若尚未配置,请参考本站关于Python3安装与配置的相关指南。
项目运行前,需预先安装requests和BeautifulSoup这两个关键模块。
Requests是Python中用于HTTP网络请求的模块,借助该库可以便捷地实现浏览器所能执行的各种网络操作。
pip install requests
BeautifulSoup是一款由Python编写的HTML/XML解析工具,具备处理不规范标记的能力,并能生成结构化的解析树。
pip install beautifulsoup4
具体实现代码如下图所示:
from urllib import request
from bs4 import BeautifulSoup
#构造头文件,模拟浏览器访问
url="http://xa.ganji.com/meirdjm/o2/"
headers = {'User-Agent':'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.77 Safari/537.36'}
page = request.Request(url,headers=headers)
# 发送请求,获取内容
page_info = request.urlopen(page).read().decode('utf-8')
# 将获取到的内容转换成BeautifulSoup格式,并将html.parser作为解析器
soup = BeautifulSoup(page_info, 'html.parser')
# 查找所有a标签中class='list-info-title'
titles = soup.find_all('a',class_="list-info-title")
# 打印抓取到的title
for title in titles:
 print(title.string)
程序运行后的输出结果如下:
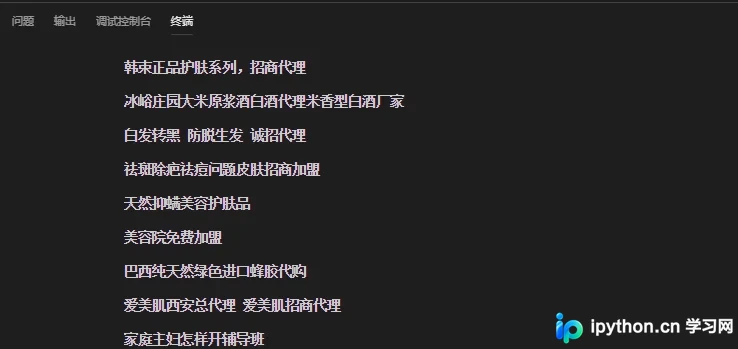
如需了解更多Python相关知识,可查阅本站系列教程,包括《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》以及《Python文件与目录操作技巧汇总》。
期望本文提供的方案能对各位的Python编程实践提供有益帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















