



在日志、订单、标签这类高重复数据场景里,真正吃内存的往往不是字段数量,而是大量内容相同却被重复分配的对象。Go 1.23 把这类“值规范化”能力正式放进标准库,本文就围绕 unique 包能解决什么问题、它相比手写全局 map 好在哪里,以及哪些场景该用、哪些场景别急着用,帮你建立清晰判断。
重复值为什么会把内存越吃越大
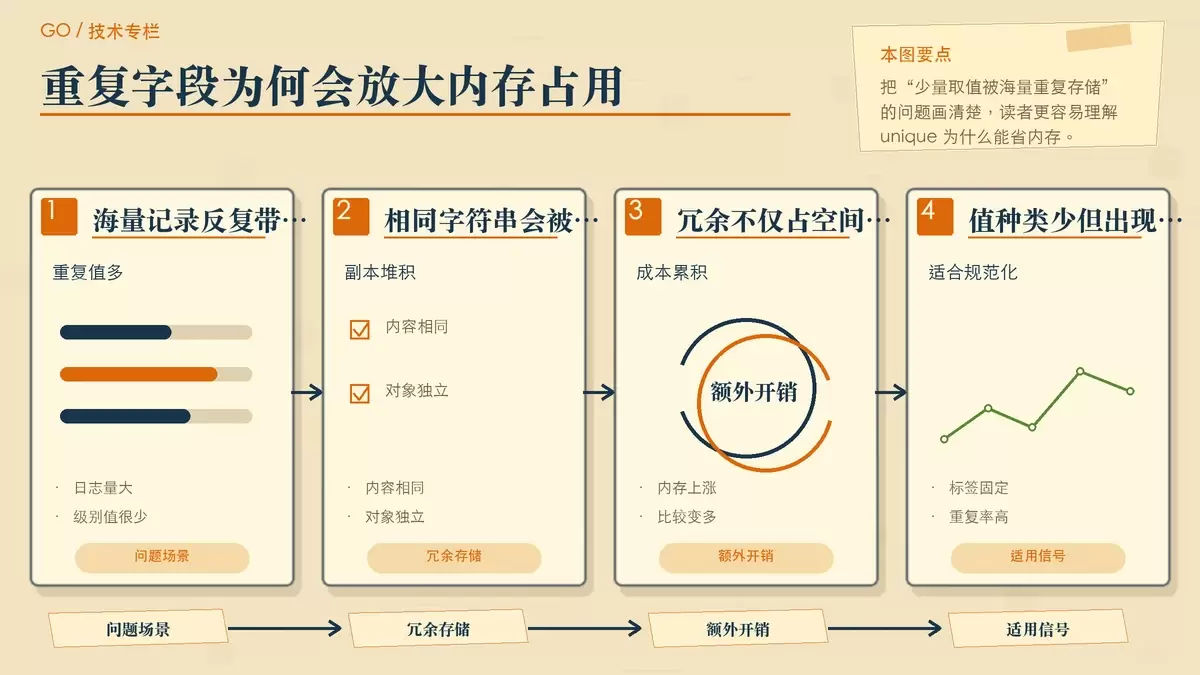
先看一个很常见的业务模型。假设你在做日志分析系统,每秒会写入数万条日志,每条日志都带一个级别字段,比如 INFO、ERROR、DEBUG。
type LogEntry struct {
    Timestamp int64
    Level     string // 这里会产生大量重复字符串
    Message   string
}
问题在于,哪怕日志级别只有少数几种,程序里依然可能存在成千上万个内容相同、但彼此独立的字符串对象。订单里的城市名、监控事件里的标签、请求里的租户标识,也都属于同一类问题:值的种类不多,但出现次数极高。
这会带来两层成本。第一层是内存冗余,同样的内容被反复分配;第二层是比较成本,比如筛选某一类日志时,字符串比较本身仍然需要逐字符检查。单次开销不夸张,但在海量数据下,累计代价会持续放大。
`unique` 包到底做了什么
Go 1.23 提供的 unique 标准库包,就是为这类高重复值场景准备的官方方案。它的核心很简单,主要围绕两个东西:Handle[T] 和 Make[T]。
可以把它理解成“规范化句柄”:如果你传入两个相等的值,unique 会返回两个相等的句柄,而且它们会对应到同一个底层 canonical 副本。对于业务代码来说,你不再直接反复持有原始值,而是持有更适合复用和比较的 Handle。
把前面的日志结构改成这样:
import "unique"

type LogEntry struct {
    Timestamp int64
    Level     unique.Handle[string] // 使用 Handle 代替原始字符串
    Message   string
}

func NewLogEntry(level string, msg string) LogEntry {
    return LogEntry{
        Timestamp: time.Now().Unix(),
        Level:     unique.Make(level), // 自动实现去重
        Message:   msg,
    }
}
当代码调用 unique.Make("INFO") 时,unique 会先检查这个值是否已经存在;如果已有,就复用已有结果;如果没有,就保存一份新的 canonical 值并返回对应句柄。对于大量重复字段,这种方式能明显减少重复存储。
为什么它还能让比较更快
很多人最先注意到的是内存节省,但 unique.Handle 的另一个实际价值,是把频繁的等值判断变得更轻量。
直接比较字符串时,复杂度通常是 O(n),因为需要按字符检查内容;而比较两个 unique.Handle 时,只需要 O(1)。原因很直接:unique 保证相同的值会得到同一个句柄,因此判断两个句柄是否相等,本质上就是判断它们是否指向同一个规范化结果。
// 字符串比较:慢
if entry1.Level == "INFO" { ... }

// Handle 比较:极快(本质是指针比较)
infoHandle := unique.Make("INFO")
if entry1.Level == infoHandle { ... }
这类收益在高频过滤、分组统计、哈希键比较等场景里会更明显。尤其当某个字段重复率高、查询又密集时,把原始值转换成句柄,往往比继续让系统反复做字符串比较更划算。
为什么不继续手写全局 `map` 去重
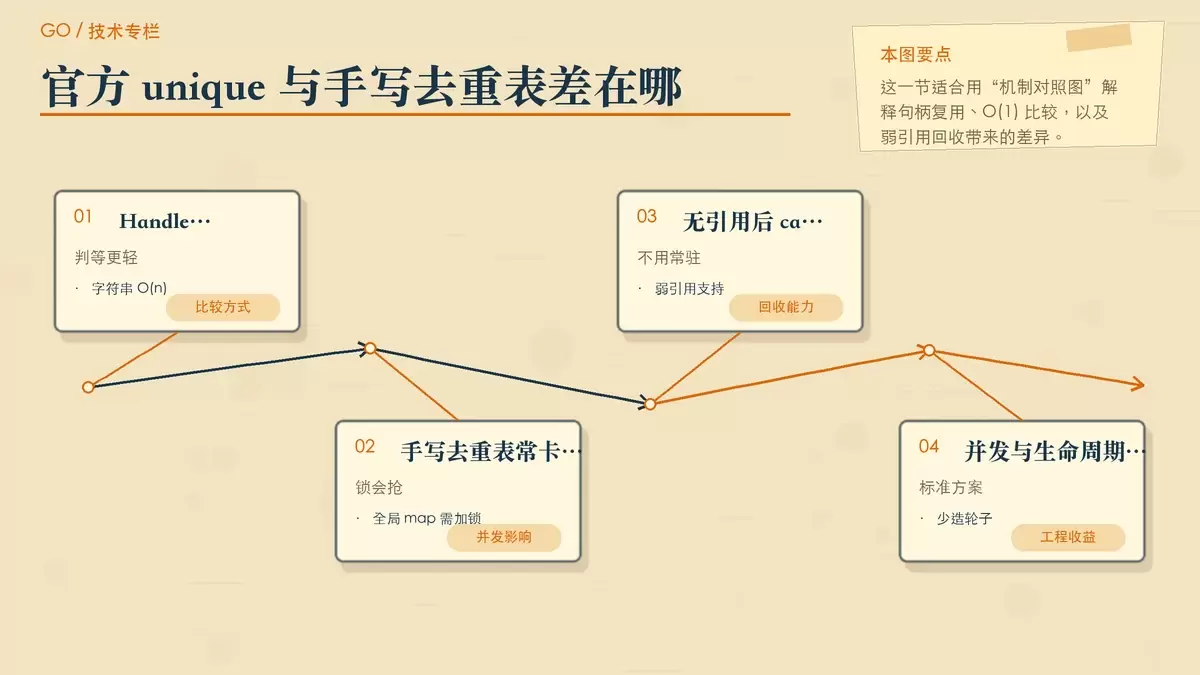
在 unique 出现之前,经验丰富的 Go 开发者常见做法是自己维护一个全局 map,把重复字符串做 Interning。思路不复杂,但一旦进入真实系统,很快就会碰到两个问题。
高并发下的锁竞争
全局 map 要安全使用,通常离不开锁。并发量一高,这个共享结构就可能成为热点,吞吐和延迟都会受影响。你当然可以继续细化分片、优化锁粒度,但复杂度也会跟着上升。
生命周期难管,容易越攒越大
更麻烦的是回收问题。手写去重表一旦把值塞进 map,这些值通常就会一直被引用住;如果没有额外的清理机制,map 只会越来越大。很多“节省内存”的优化,最后反而变成另一种形式的常驻占用。
unique 的关键优势在于,它底层利用了由 Go Runtime 支持的弱引用(Weak Reference)机制。只要某个 canonical 副本已经不再被任何 Handle 引用,垃圾回收器就能识别这一点,并把它从内部哈希表中回收掉。
这也是它比手搓 map[string]string 更像“标准解法”的地方:不仅解决复用问题,也把并发与回收这两个最难处理的部分交给运行时和标准库实现。
不只是字符串,结构体也能做规范化
unique 的类型约束是 comparable,因此它并不局限于字符串。只要类型可比较,就可以交给 unique.Make 做规范化,结构体也包括在内。
例如一套权限配置,很多用户虽然是不同对象,但权限内容完全一样:
type Permissions struct {
    Role    string
    CanRead  bool
    CanWrite bool
}

// 规范化权限对象
h1 := unique.Make(Permissions{"Admin", true, true})
h2 := unique.Make(Permissions{"Admin", true, true})

fmt.Println(h1 == h2) // 输出: true
如果系统里有成千上万个用户共享同一组权限,直接存原始结构体会产生大量重复副本;改成保存 Handle 后,内存里只需要保留一份规范化结果,其余对象都引用同一个句柄即可。
这类模式也适合区域配置、套餐规则、特征标签组合等“重复组合很多、变化种类有限”的业务数据。
哪些场景不适合上来就用 `unique`
unique 很实用,但它不是无条件收益。是否值得引入,关键看数据重复率、生命周期和访问方式。
重复率低时,创建成本可能盖过收益
unique.Make 本身要做哈希和内部查找。如果你处理的是短生命周期、重复率又很低的数据,那么额外这一步可能只会增加 CPU 负担,换不回足够的内存收益。
适合做标识和比较,不适合拿来频繁修改
Handle 更适合表示“同一个值”的身份,用在筛选、分组、判等、共享配置这类场景最顺手。它返回的是值的副本,需要通过 Value() 取出原值,因此并不适合那种高频修改内容、再写回的工作流。
简单说,unique 更像是重复值很多时的“规范化层”,而不是通用的数据容器。只有当重复对象已经成为内存或比较开销的主要来源时,它的价值才会真正显现。
怎么判断你的项目值不值得用
如果你的系统里存在大量重复字符串、重复配置对象或其他可比较值,并且这些值会被长期保存、频繁判等或作为键参与索引,那么 Go 1.23 的 unique 值得认真评估。它把过去需要自己造轮子的去重能力做进了标准库,同时补上了并发访问和自动回收这两个最容易失控的环节。
反过来,如果数据几乎不重复,或者对象存在时间极短,直接调用 unique.Make 未必能换来正收益。最稳妥的判断方式仍然是结合真实数据分布做压测:看重复率、看内存曲线、也看 CPU 是否因为规范化步骤出现额外代价。
对高重复数据来说,unique 确实可能让资源占用明显下降;但它真正有价值的地方,不只是“省内存”,而是把这件事变成了一个更可靠、可维护、也更贴近 Go 官方运行时能力的方案。















