



长上下文、RAG 和多轮对话普及之后,AI 应用的成本瓶颈越来越多地落在输入 Token 上。对 Go 后端来说,想把 Prompt Caching 真正用起来,关键不只是知道厂商支持缓存,而是要弄清触发条件、失效边界,以及代码里该怎样稳定地组织 Prompt 结构。本文从主流厂商机制出发,拆解几条在工程里最容易见效的策略,帮助你判断哪些做法能稳定命中缓存,哪些细节会让省钱手段直接失效。
先弄清厂商缓存是怎么工作的
要把缓存命中率做上去,第一步不是改代码,而是先理解不同模型厂商的触发方式。当前常见机制,大致可以分成两类。
隐式哈希匹配:前缀一致才有复用机会
以 OpenAI、DeepSeek 这类方案为代表,服务端通常会从 Prompt 的第一个字符开始计算哈希。只要请求前缀与之前处理过的内容完全一致,后端就有机会直接复用已有计算状态。
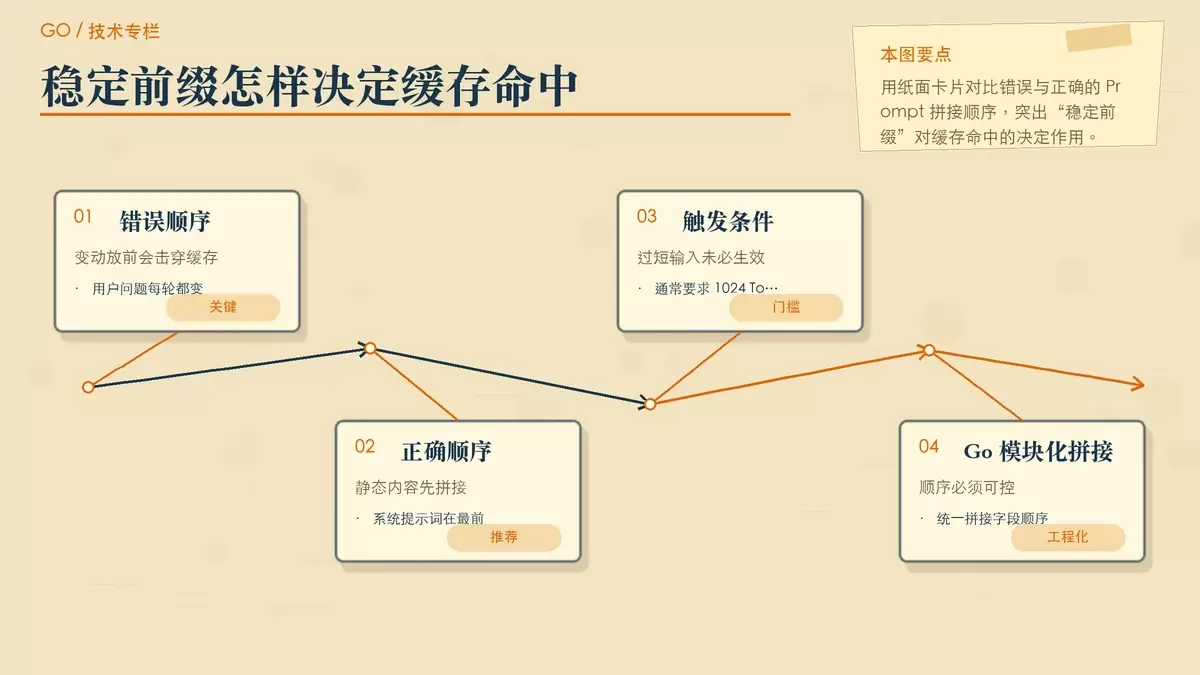
这种机制对工程实现提出了一个很硬的要求:不是“内容差不多”就行,而是前缀必须严格一致。顺序、空格、动态字段位置,都会直接影响命中。
- 通常有 1024 Tokens 的起步门槛,太短的输入往往触发不了缓存。
显式标记触发:需要主动声明缓存段
Anthropic、Gemini 则更偏向显式控制。比如 Anthropic 需要通过 cache_control 来标记可缓存内容,Gemini 还支持创建持久化 Context Cache,并返回一个 cache_id。
这类方式更适合需要明确管理缓存生命周期的场景,但也要同时考虑成本结构。
- Anthropic 的缓存“写入”成本通常比普通输入略高,但“读取”很便宜,因此更适合预计会被复用 2 次以上 的内容。
- Gemini 的
cache_id适合超大型固定知识库,例如 100k+ 规模的上下文材料。
第一步:把 Prompt 设计成可缓存的稳定前缀
Prompt Caching 的核心规律其实很简单:越稳定的内容,越要放前面;越容易变化的内容,越要放后面。 这也是最容易落地、收益最直接的一步。
为什么顺序会直接决定缓存命中率
很多团队初期会先拼接用户问题,再追加系统提示词和参考文档,逻辑上看似自然,但对缓存非常不友好。因为用户问题每轮都变,只要它出现在最前面,后面那一大段原本稳定的内容就失去了复用价值。
错误的顺序:[用户问题] + [系统提示词] + [参考文档]
正确的顺序:[系统提示词] + [参考文档] + [用户问题]
一旦把系统规则、产品约束、知识库片段这类低频变化内容固定在前缀位置,它们就更容易被服务端缓存下来,后续请求只需要为真正变化的部分付费。
Go 里更适合做模块化拼接
这类约束如果只靠人为约定,时间一长很容易失守。更稳妥的方式,是在 Go 后端里把 Prompt 拆成固定字段,并通过统一方法生成最终字符串,避免不同调用路径随意更改顺序。
这不是代码风格问题,而是缓存命中率问题。只要拼接顺序不统一,同样的业务请求也可能产生不同前缀,缓存效果就会明显波动。
第二步:把动态变量移到后面,避免缓存被秒级打碎
很多缓存命中率低,并不是模型能力不够,而是 Prompt 前缀里混入了不该出现的动态信息。对哈希型缓存来说,这种问题尤其致命。
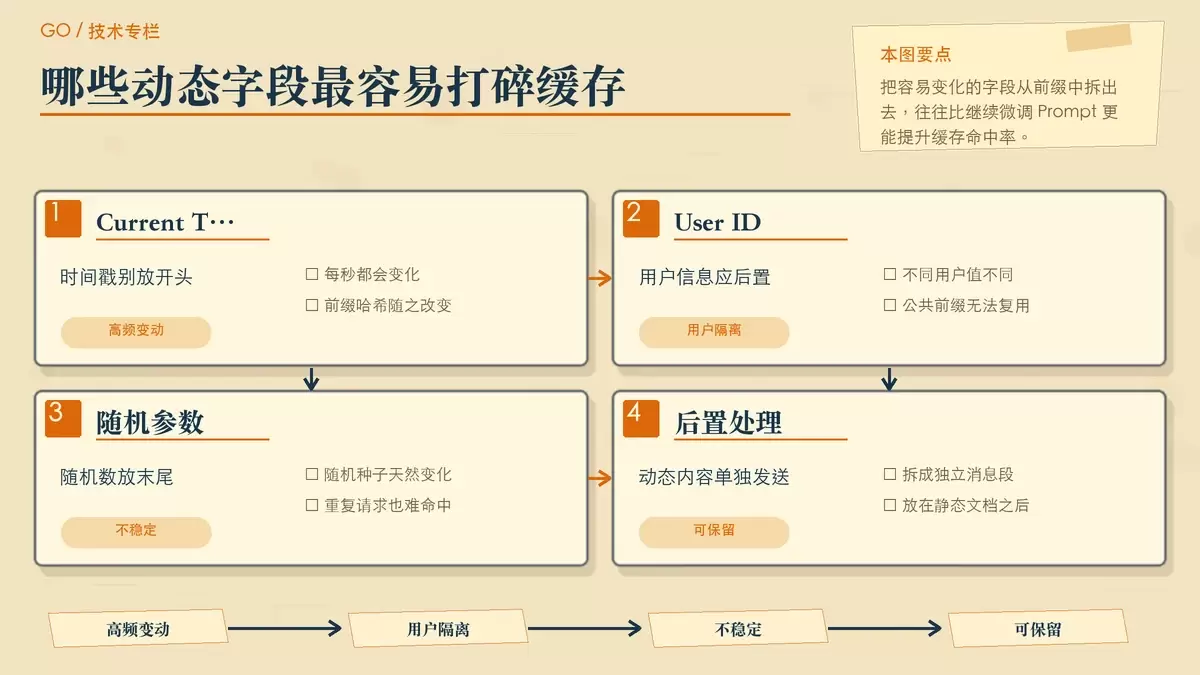
最常见的几个失效源
- 时间戳:例如
Current Time: 14:05:23,每秒都会改变前缀。 - 用户信息:例如
User ID: 12345,不同用户天然无法复用。 - 随机数:随机种子如果出现在前部,请求几乎不可能命中同一缓存。
这些字段并非不能用,而是不能放在缓存前缀里。否则你明明已经把系统 Prompt 和知识库做成了静态内容,结果还是会因为前面一个小变量,把整段缓存价值全部抵消。
更稳的做法:把动态内容独立成后置消息段
如果业务上必须使用时间、用户态或随机参数,建议把它们作为单独消息段,放在静态文档之后再发送。这样可以把缓存影响范围控制在变化部分,而不是把整条请求都拖下水。
从工程视角看,这一步的重点不是“有没有动态变量”,而是“动态变量是否污染了前缀”。只要前缀足够稳定,缓存命中率通常就能明显改善。
第三步:在 Go 和 RAG 流程里把缓存逻辑做成默认能力
当缓存策略进入生产环境后,单靠文档规范已经不够。更可靠的做法,是把缓存意识写进请求结构、检索流程和多轮会话管理中,让系统默认生成可复用的 Prompt。
用结构体约束拼接顺序
在 Go 后端里,可以把系统提示词、知识库内容和用户查询拆成明确字段,并通过统一方法输出 Prompt。这样做的价值,不只是代码整洁,更是为了保证每次请求都按同样顺序构建缓存前缀。
// 逻辑:如果是 Anthropic,在 KnowledgeBase 后注入 "cache_control": {"type": "ephemeral"}
// 利用 Go 的强类型特性,确保拼接顺序的绝对统一
func (r *AIChatRequest) BuildPrompt() string {
    return r.SystemPrompt + r.KnowledgeBase + r.Query
}
如果接入的是 Anthropic 这类显式缓存机制,还可以在构造请求时,把 cache_control 自动插入到知识库段之后,避免业务层重复处理细节。
RAG 要先解决“内容一样、顺序不同”的问题
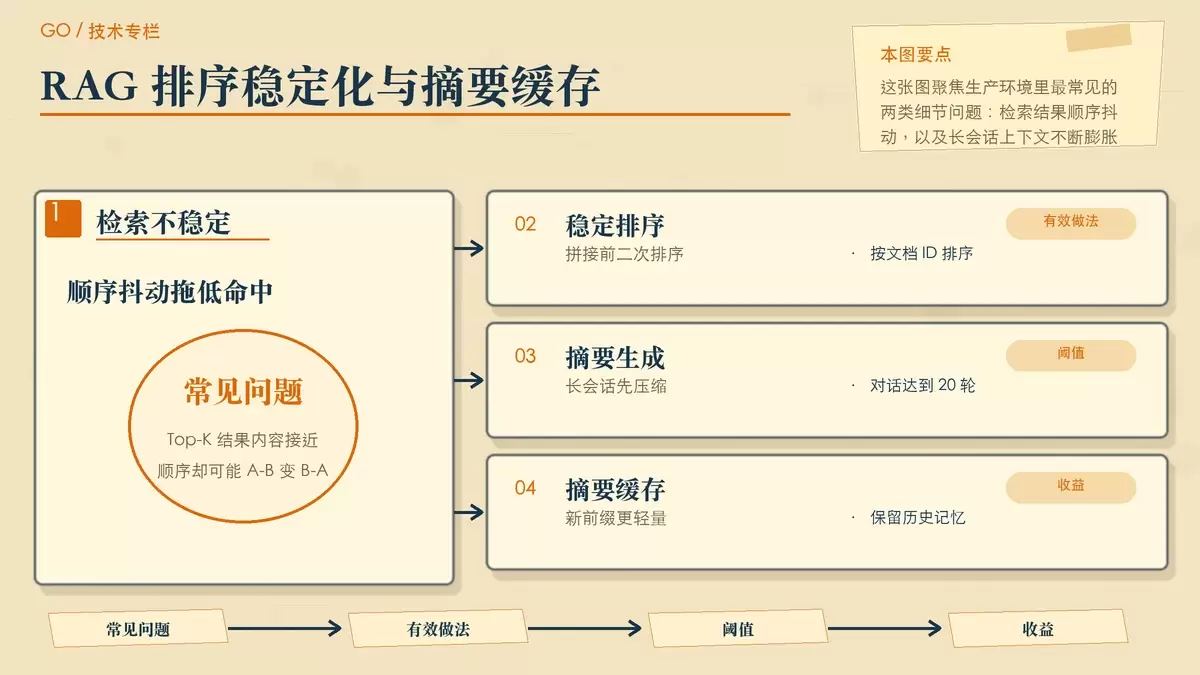
很多 RAG 系统明明检索出的文档差不多,缓存命中率却一直很低,原因常常不是内容变了,而是文档顺序变了。比如上一轮是 A-B,这一轮变成 B-A,最终拼出的字符串就完全不同。
比较稳妥的办法,是在拿到 Top-K 结果后,先按固定规则做一次二次排序,例如按文档 ID 或文件名排序。这样只要文档内容本身没变,最终生成的 Prompt 顺序就能保持一致。
这一步对缓存非常关键,因为向量检索的分数常常只差一点点,不做稳定排序,命中率会在看不见的地方被持续吞掉。
长对话不要只靠缓存,必要时做摘要缓存
即便缓存已经生效,多轮对话的上下文仍然会随着轮数增长而持续变长,基础 Token 成本也会越来越高。单纯依赖原始历史对话,并不能从根上解决问题。
更实际的做法是设定一个阈值,例如对话达到 20 轮 后,由 Go 后端异步启动总结任务,把旧对话压缩成一段摘要。之后的新请求改用 [系统提示词] + [摘要缓存] 作为前缀,再附加最新轮次的问题。
这样做有两个直接好处:一是保留对话记忆,二是显著降低后续每轮请求的固定输入成本。对于客服、Copilot、知识问答这类长会话业务,这通常比单纯堆上下文更可控。
结语:Prompt Caching 拼的不是技巧,而是工程纪律
在 AI 应用进入生产阶段后,Prompt Caching 已经不只是一个可选优化项,而是成本控制和响应性能的关键组成部分。会写复杂 Prompt 只是基础,真正拉开差距的,是能不能把前缀稳定性、动态字段管理、RAG 排序和会话压缩做成可持续的工程能力。
对 Go 开发者来说,最值得优先落实的通常不是更复杂的 Agent 逻辑,而是先把这些缓存规则固化进后端结构里。因为模型输出有概率性,但缓存命中这件事,应该尽量被写成确定性的系统行为。















