



很多人在排查 C++ 动态库多线程问题时,会把“状态串了”“锁异常”“重复初始化”统称为全局变量冲突,但这往往会把问题带偏。要判断该怎么修,先得分清三件事:动态库的全局变量默认是进程共享,thread_local 只能做到线程隔离,而“每次 dlopen 都拿到一份独立状态”并不是 POSIX 动态加载器默认支持的能力。本文按这三层关系展开,最后再落到调试中最常见的 std::mutex 异常场景,给出更稳妥的状态管理方式。
动态库全局变量为什么会被多个线程或实例看到同一份
这类现象通常不是“冲突”,而是动态库的默认行为。Linux 下通过 dlopen 加载同一路径的 .so 时,库通常只会在进程内映射一次;只要数据段只有这一份,那么其中的全局变量天然也是进程级单例。Windows 下的 LoadLibrary 也类似,DLL 内的全局变量默认同样是进程内共享。
因此,无论你在同一进程里调用多少次 dlopen,只要目标库路径相同,看到的往往仍是同一份全局状态。这里最容易出现的误判,是把初始化失败或竞态结果,当成“库被加载出多份后互相打架”。
常见表象包括:
std::shared_ptr初始化失败,看起来像状态被别处改坏std::mutex被重复构造,随后报错或死锁- 静态局部变量初始化竞态,例如
static T x = init();
这些现象表面上像“全局变量冲突”,实际更常见的原因是:没有按多线程场景设计初始化时机,或者错误依赖了单例式全局状态。
排查时建议先确认几个事实,而不是直接改代码结构:
- 确认是否真的发生了多次
dlopen,可以检查返回句柄是否重复 - 用
dladdr验证目标符号地址是否一致,判断是否仍指向同一份映射 - 尽量避免在全局或静态变量中直接放非 POD 类型,例如
std::string、std::vector
C++11 之后,静态初始化本身具备线程安全保证,但这并不意味着跨动态库边界就没有问题。析构顺序不可控、卸载时机复杂、不同 DSO 之间的依赖关系不透明,都会让这类全局对象变得难以维护。
thread_local 能解决什么,不能解决什么
thread_local 的作用边界需要说清楚:它能解决“每个线程一份状态”,但不能解决“每次 dlopen 一份状态”。如果问题本质是多个线程共享同一份可变全局数据,那么把它改成 thread_local 确实可能有效;但如果你期待同一个库被多次加载后,各次加载彼此独立,那它帮不上忙。
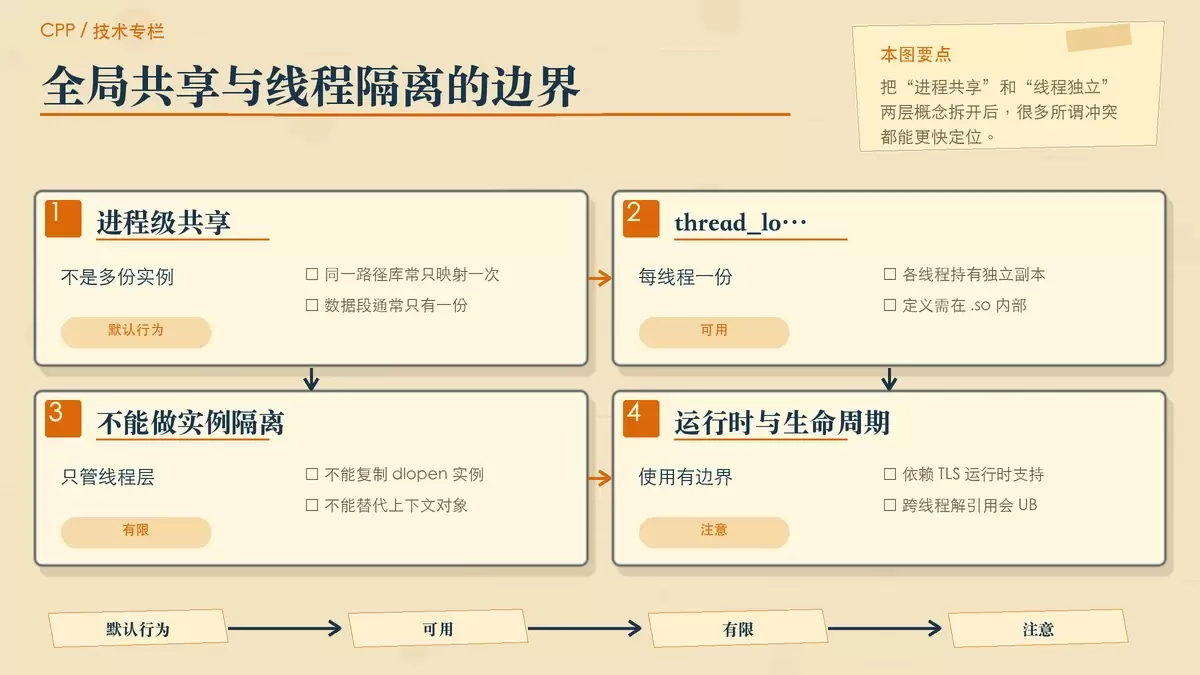
在动态库内部使用 thread_local 是可行的,各线程会拥有各自副本。前提是变量定义确实位于 .so 内部,并且链接阶段没有把相关符号优化掉。实践中通常要确保使用 -fPIC 编译,同时注意不要因为 visibility=hidden 配置让符号行为偏离预期。
这里还要注意运行时支持条件。GCC/Clang 在 dlopen 场景下使用 thread_local,依赖 TLS 运行时支持,常见要求是 glibc ≥ 2.12。另外,它不能直接用于模板静态数据成员,除非你做了显式实例化。
使用时有几条边界最好提前守住:
- 声明必须带
thread_local存储说明符,static thread_local与extern thread_local都可以,但定义只能有一处 - 不要在
thread_local对象构造函数里调用dlsym或其他可能引发重入的 API - 不要把
thread_local指针跨线程传递后再解引用,它的生命周期绑定在线程本身,这样做会触发 UB
如果你的目标只是让每个工作线程维护自己的缓存、错误上下文或临时状态,那么 thread_local 是合适工具;如果你想把它当成“动态库实例隔离”的替代方案,就会在设计层面走偏。
想让每次 dlopen 都有独立状态,真正可行的做法是什么
标准 POSIX 并不支持“同一路径动态库每次加载都复制出一份独立全局变量”。Linux 的 dlopen 默认会按库路径去重,相同路径通常只映射一次。即便使用 RTLD_NOW | RTLD_DEEPBIND,也无法把数据段复制成多份,所以它并不能实现真正的实例级隔离。
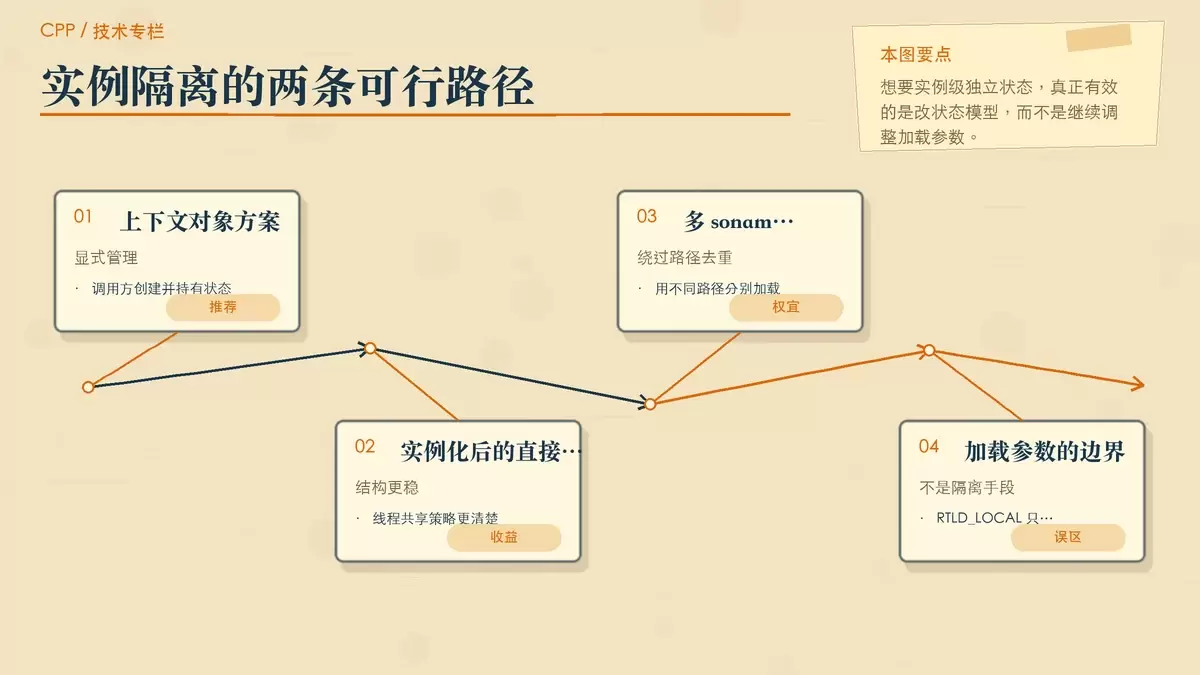
这也是很多调试工作反复打转的原因:试图靠加载参数、符号可见性或链接技巧,把共享全局变量变成独立实例状态,方向本身就是错的。
真正可落地的方案,通常只有两种。
方案一:把状态从全局变量改成显式上下文对象
这是最稳妥、也最符合库接口设计原则的方式。把所有可变状态封装到实例对象里,由调用方显式创建、持有和销毁,例如暴露类似下面的接口:
MyLibContext* create_context()之后所有需要状态的 API 都围绕这个上下文工作,而不是偷偷依赖库内部全局变量。这样做的直接收益是:
- 每个调用方都能拿到独立状态
- 线程间共享还是隔离,由上层显式决定
- 初始化、清理、复用和销毁路径更清晰
在这种模式下,库里的全局变量最多只保留给日志开关、只读配置缓存等弱状态场景,不再承载核心业务对象。
方案二:编译成多个不同 soname 的库变体
如果历史包袱太重,接口一时改不动,另一条能工作的路是生成多个不同 soname 的变体,例如 libfoo_v1.so、libfoo_v2.so,再通过不同路径分别加载。这样做本质上是绕过同一路径库的合并行为,让系统把它们当成不同对象处理。
但它的代价也很明显:
- 代码和构建产物会变多
- 升级、修复和发布成本上升
- 维护时容易出现版本漂移
相比之下,这更像权宜之计,而不是推荐的长期结构。
至于 RTLD_LOCAL,或者通过 __attribute__((visibility("hidden"))) 做符号隐藏,它们主要影响的是符号可见性,不会改变数据段共享这一事实。也就是说,它们可以“藏住符号”,但不能“复制状态”。
调试中遇到 std::mutex 报错,为什么常常不是锁本身的问题
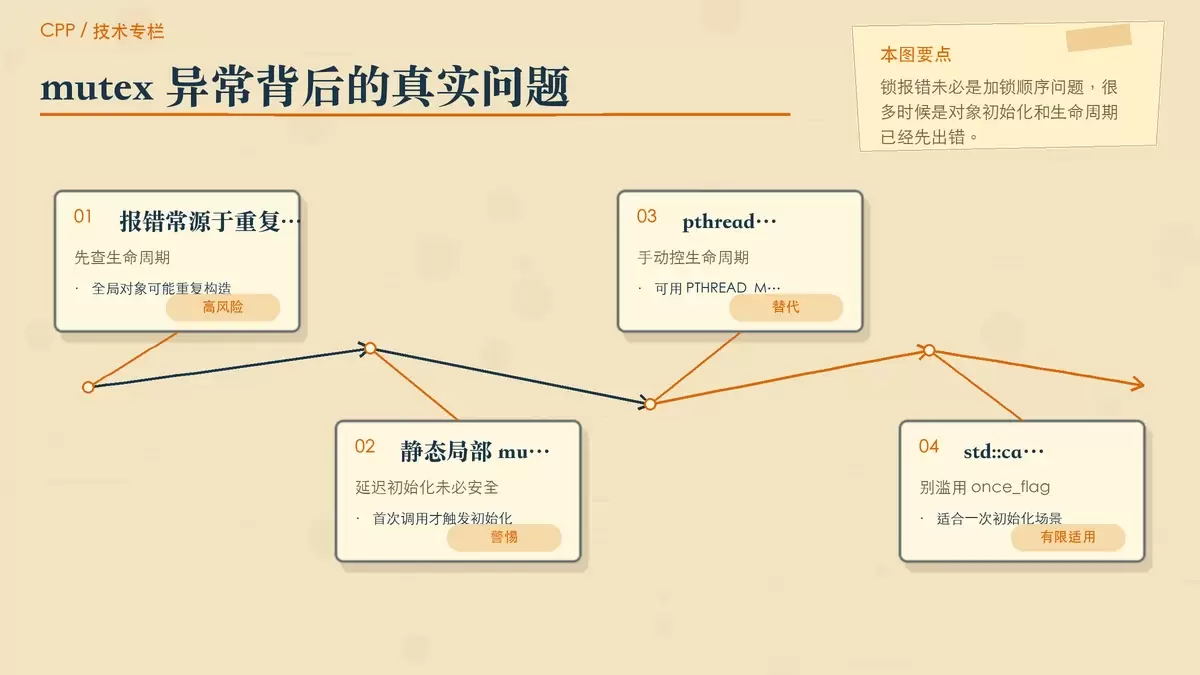
如果你在动态库调试时看到 Resource deadlock avoided,先别急着把重点放在加锁顺序上。对于库内全局或静态对象,这类报错很常见的根源其实是重复初始化,或者对象生命周期已经被破坏。
例如动态库里定义了全局互斥量:
std::mutex m;当库被多次 dlopen,而相关初始化与卸载路径又没处理干净时,std::mutex 这种带内部状态的 C++ 对象就可能出现重复构造、重复析构或状态损坏。更麻烦的是静态局部锁:
static std::mutex& get_mutex() { static std::mutex m; return m; }它看上去把初始化时机推迟到了首次调用,但在复杂并发和动态装载场景下,问题未必因此消失。如果首次进入时机、卸载顺序或重入路径没有设计清楚,仍可能踩到未定义行为。
这类对象最好不要直接放在动态库的全局作用域或静态局部作用域中,尤其是下面这些可变状态类型:
std::mutexstd::shared_ptrstd::ofstream
如果确实需要底层同步原语,更可控的做法通常是使用 pthread_mutex_t 并手动管理生命周期,例如配合 PTHREAD_MUTEX_INITIALIZER,或者用运行时 pthread_mutex_init 明确控制初始化与销毁时机。这样做的优势在于对象布局更直接,也更适合和动态库装载周期一起管理。
另一种常见补救方式是用 std::call_once 与 std::once_flag 保护初始化逻辑。这对于“一次初始化、长期使用”的场景是有效的,但它并不适合需要多次加载、卸载、重置状态的动态库。因为一旦你真正有实例化需求,once_flag 反而会把状态再次推回单例模型。
更稳妥的设计准则:把可变状态交给调用方
如果你希望动态库在多线程环境下更容易调试,也更不容易出现诡异故障,最稳妥的办法通常不是继续优化全局变量,而是减少甚至移除它们。把状态交给调用方管理,动态库只暴露纯函数接口,或者提供清晰的初始化/清理函数,往往比在库内部维护一套隐式共享状态更可靠。
实际判断时可以按下面这个顺序做:
- 如果只是线程之间不能共享状态,优先考虑
thread_local - 如果需要多个独立实例并存,优先改成显式上下文对象
- 如果历史原因无法改接口,再评估多 soname 变体方案
归根到底,动态库全局变量的问题,核心不在“怎么把单例修补得更复杂”,而在“是否应该继续依赖单例状态”。一旦你把线程隔离、实例隔离和加载行为这三层概念拆开,很多看似诡异的多线程 Bug,定位路径就会清楚得多。















