


Python结合Kafka实现跨平台数据实时传输方案

本文介绍如何在Python 3.5.x环境中利用Kafka 1.4.3构建跨平台数据中转站。通过配置KafkaProducer与KafkaConsumer,结合Pandas处理CSV数据,实现从数据源到目标端的实时传输。文中详细说明了环境准备、代码实现及关键注意事项,包括服务器地址配置、JSON序列化转换及编码处理,旨在为开发者提供一套完整的实时数据同步解决方案。
背景:
为实现多平台间的数据高效互通,并确保数据的时效性与历史追溯能力,本文选取Kafka作为跨平台数据传输的核心枢纽,以满足不同系统间数据发送与接收的需求。
Kafka简介:
Kafka被定义为一个分布式、分区且具备复制功能的提交日志服务。它提供了类似JMS(Java Message Service)的功能特性,但在设计架构上与之截然不同,并非JMS规范的直接实现。在Kafka中,消息依据Topic进行分类存储;负责发送消息的实体称为Producer(生产者),接收消息的实体称为Consumer(消费者)。Kafka集群由多个Kafka实例(即Broker)组成,而无论是集群本身、生产者还是消费者,均依赖Zookeeper来维持系统的可用性及存储元数据信息。
综上所述,Kafka作为数据中转枢纽,主要承担以下功能:
1. 生产者角色:负责生成数据或从外部系统接收数据。
2. 消费者角色:负责接收数据,并将其转换为目标系统所需的格式。
运行环境:
1. Python 3.5.x版本
2. Kafka 1.4.3版本
3. Pandas库
实施步骤:
1. 安装Kafka
pip install kafka-python
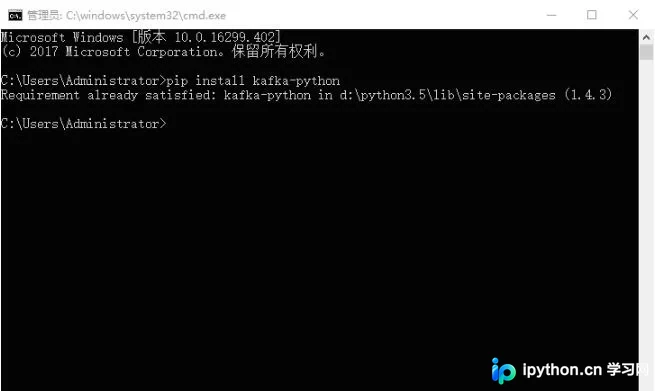
2. 验证Kafka安装状态
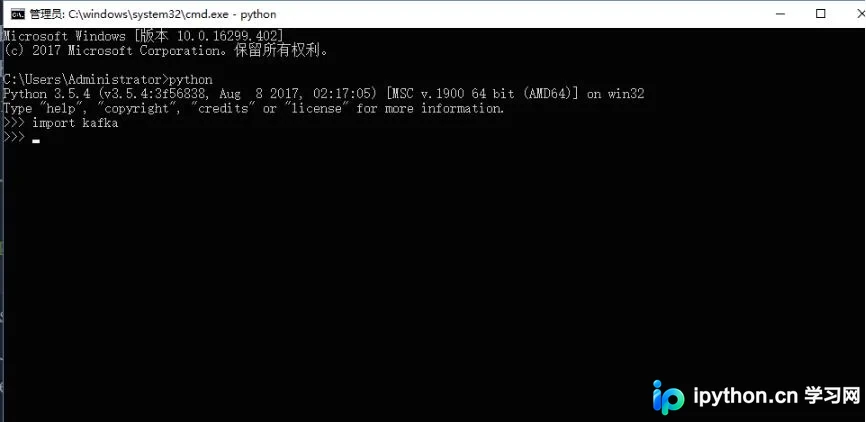
3. 安装Pandas库
pip install pandas
4. 执行Kafka数据传输流程
具体代码实现如下:
# -*- coding: utf-8 -*-
'''
@author: 真梦行路
@file: kafka.py
@time: 2018/9/3 10:20
'''
import sys
import json
import pandas as pd
import os
from kafka import KafkaProducer
from kafka import KafkaConsumer
from kafka.errors import KafkaError

KAFAKA_HOST = "xxx.xxx.x.xxx" #服务器端口地址
KAFAKA_PORT = 9092    #端口号
KAFAKA_TOPIC = "topic0"  #topic

data=pd.read_csv(os.getcwd()+'\\data\\1.csv')
key_value=data.to_json()
class Kafka_producer():
 '''
 生产模块:根据不同的key,区分消息
 '''

 def __init__(self, kafkahost, kafkaport, kafkatopic, key):
  self.kafkaHost = kafkahost
  self.kafkaPort = kafkaport
  self.kafkatopic = kafkatopic
  self.key = key
  self.producer = KafkaProducer(bootstrap_servers='{kafka_host}:{kafka_port}'.format(
   kafka_host=self.kafkaHost,
   kafka_port=self.kafkaPort)
  )

 def sendjsondata(self, params):
  try:
   parmas_message = params  #注意dumps
   producer = self.producer
   producer.send(self.kafkatopic, key=self.key, value=parmas_message.encode('utf-8'))
   producer.flush()
  except KafkaError as e:
   print(e)


class Kafka_consumer():


 def __init__(self, kafkahost, kafkaport, kafkatopic, groupid,key):
  self.kafkaHost = kafkahost
  self.kafkaPort = kafkaport
  self.kafkatopic = kafkatopic
  self.groupid = groupid
  self.key = key
  self.consumer = KafkaConsumer(self.kafkatopic, group_id=self.groupid,
          bootstrap_servers='{kafka_host}:{kafka_port}'.format(
           kafka_host=self.kafkaHost,
           kafka_port=self.kafkaPort)
          )

 def consume_data(self):
  try:
   for message in self.consumer:
    yield message
  except KeyboardInterrupt as e:
   print(e)

def sortedDictValues(adict):
 items = adict.items()
 items=sorted(items,reverse=False)
 return [value for key, value in items]

def main(xtype, group, key):
 '''
 测试consumer和producer
 '''
 if xtype == "p":
  # 生产模块
  producer = Kafka_producer(KAFAKA_HOST, KAFAKA_PORT, KAFAKA_TOPIC, key)
  print("===========> producer:", producer)
  params =key_value
  producer.sendjsondata(params)


 if xtype == 'c':
  # 消费模块
  consumer = Kafka_consumer(KAFAKA_HOST, KAFAKA_PORT, KAFAKA_TOPIC, group,key)
  print("===========> consumer:", consumer)

  message = consumer.consume_data()
  for msg in message:
   msg=msg.value.decode('utf-8')
   python_data=json.loads(msg) ##这是一个字典
   key_list=list(python_data)
   test_data=pd.DataFrame()
   for index in key_list:
    print(index)
    if index=='Month':
     a1=python_data[index]
     data1 = sortedDictValues(a1)
     test_data[index]=data1
    else:
     a2 = python_data[index]
     data2 = sortedDictValues(a2)
     test_data[index] = data2
     print(test_data)


   # print('value---------------->', python_data)
   # print('msg---------------->', msg)
   # print('key---------------->', msg.kry)
   # print('offset---------------->', msg.offset)


if __name__ == '__main__':
 main(xtype='p',group='py_test',key=None)
 main(xtype='c',group='py_test',key=None)
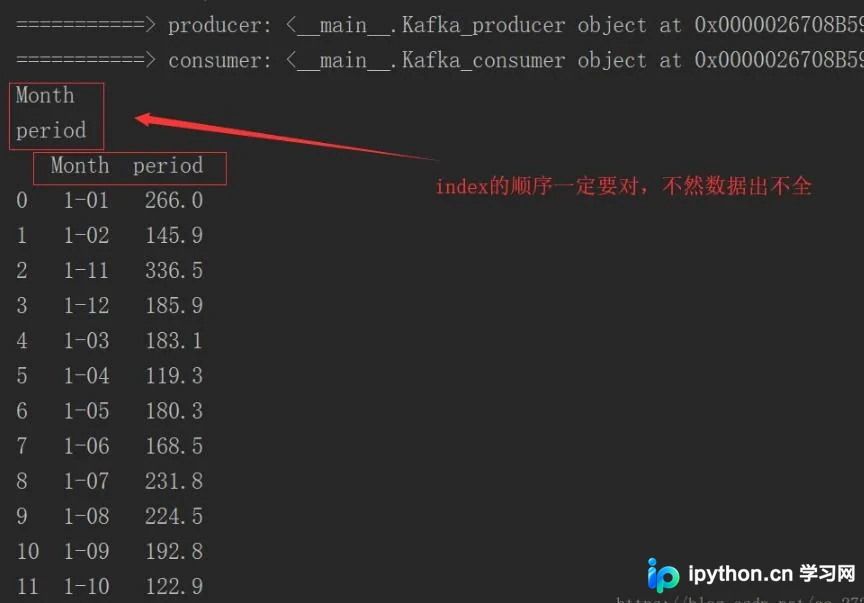
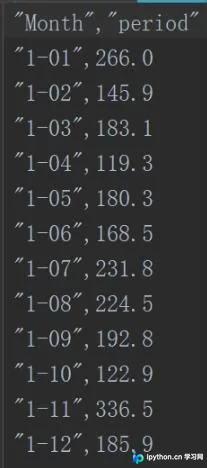
示例数据文件1.csv内容如下:
关键注意事项:
1. 必须配置有效的服务器端口地址,严禁使用本机IP或随意填写的IP地址,否则程序将抛出错误。笔者曾尝试使用本机IP进行调试,导致持续报错,因此请务必使用正确的远程服务器地址。
2. 需严格注意数据传输格式及编码问题(涉及二进制传输)。数据发送前需转换为JSON格式,接收端再将JSON格式转换为目标所需格式。若数据非JSON格式,请注意使用dumps进行序列化操作。
在本示例中,数据流转路径为:DataFrame -> JSON -> DataFrame。
3. 示例中将字典(dict)转换为DataFrame时,也可采用更简便的方法直接转换。
示例代码:type(data) ==> dict,随后使用 pd.DataFrame(data) 进行转换。
以上即为在Python环境下运用Kafka进行数据实时传输的完整方法,希望能为读者提供参考与帮助,欢迎支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















