



很多人理解柯里化时,只记得“函数返回函数”,却没真正看清参数为什么能一层层记住。关键就在闭包:外层函数创建出一块当前调用专属的私有存储区,后续每次继续传参,拿到的其实都是同一份被保留下来的状态。
放到实际代码里看,柯里化是否可靠,主要取决于三件事:参数是怎么隔离存放的、后续参数是追加还是合并、以及什么时候该停止累积并执行原函数。把这三点理顺,基本就能判断一个柯里化写法是否稳妥。
闭包如何为每次柯里化创建独立存储
柯里化函数启动时,通常会在外层作用域先声明一个数组,比如 args,或者一个对象,比如 config。随后返回的中间函数会一直引用这份变量,这就是闭包在这里最核心的作用。
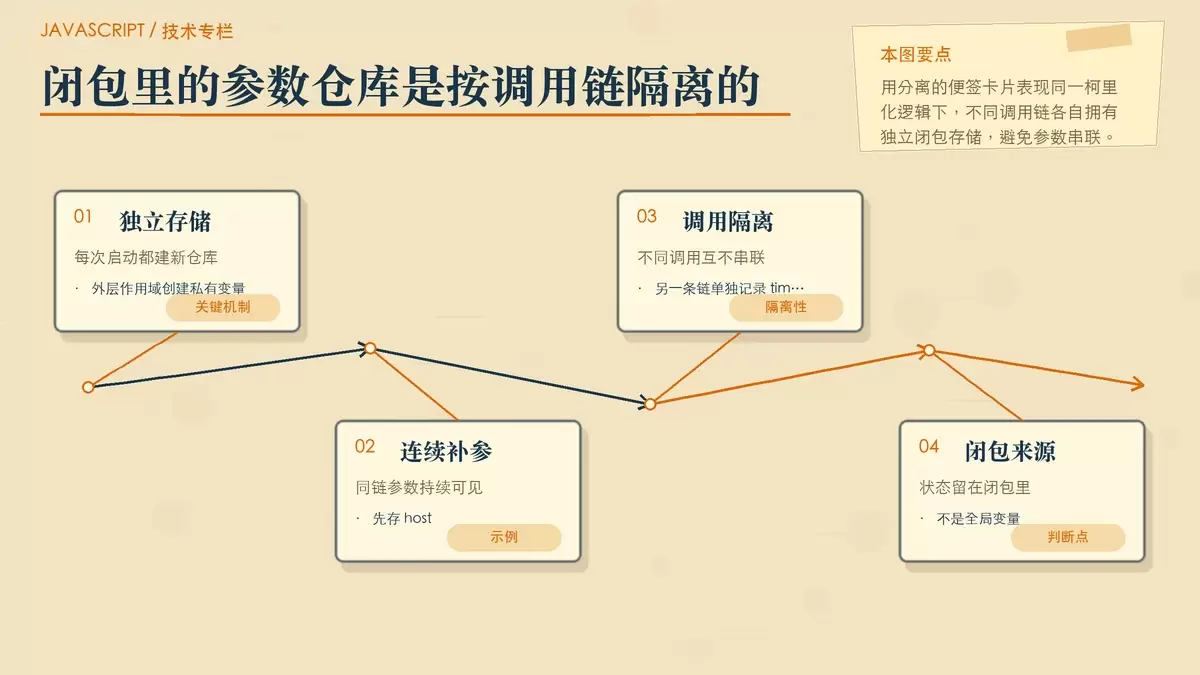
它带来的不是“共享全局状态”,而是“只属于当前这一条调用链的私有状态”。也就是说,同一套柯里化逻辑可以并行跑多次,但每次调用都会生成自己的参数存储空间,不会互相串数据。
- 调用
curry(request)({ host: 'a.com' }),闭包里先记下这个host - 继续调用
({ token: 'x123' }),新参数会合并到同一个闭包中的config对象 - 如果另起一次
curry(request)({ timeout: 3000 }),又会生成一份全新的闭包,和前一条调用链互不影响
因此,闭包在柯里化里更像一个“分步收集参数的私有仓库”。仓库只在当前调用链里可见,外部拿不到,也不会被其他调用污染。
参数是如何在闭包里持续累积的
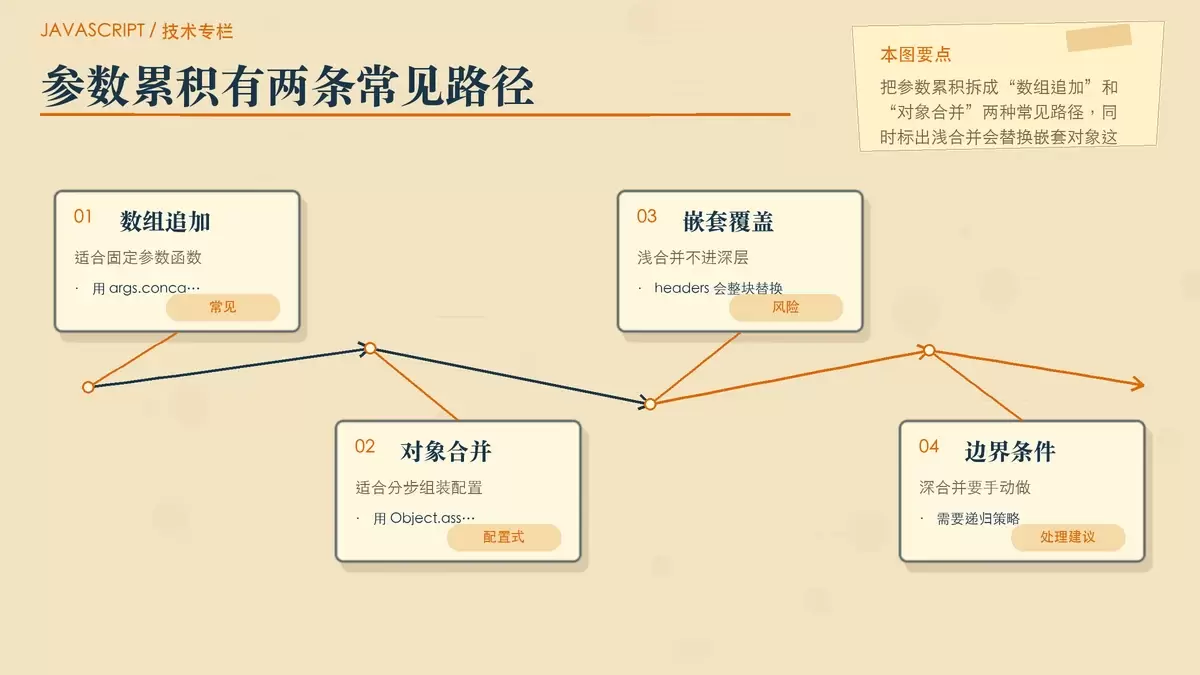
参数进入闭包后,下一步就是累积。这里最常见的方式有两类:一类是普通多参数函数的数组追加,另一类是配置式调用的对象合并。两者思路相同,都是在同一份闭包变量上持续更新。
数组式累积:适合普通多参数函数
如果目标函数本身是固定参数列表,那么常见写法是把每次传进来的新参数拼到已有数组后面,例如用 args.concat(newArgs)。等参数收集完整后,再一次性展开给原函数执行。
这种方式的重点是“追加而不是覆盖”。前一次传入的值不会丢,后一次只是继续往后补。
对象式累积:适合配置项逐步补齐
如果柯里化过程是分步组装配置对象,通常会使用 Object.assign(target, newConfig) 做合并。这样每次调用都能向同一个 config 对象里补充字段。
不过这里有一个很容易被忽略的边界:Object.assign 是浅合并,不会递归处理嵌套对象。
例如,当前闭包里已有:
config = { headers: { a: 1 } }如果后面再传入:
{ headers: { b: 2 } }那么结果会变成:
{ headers: { b: 2 } }也就是说,原来的 a: 1 会被整块替换掉,而不是自动得到 { a: 1, b: 2 }。如果业务要求深层配置也能累积,就不能直接依赖这种浅合并,必须额外手动处理深合并逻辑。
什么时候停止累积并执行原函数
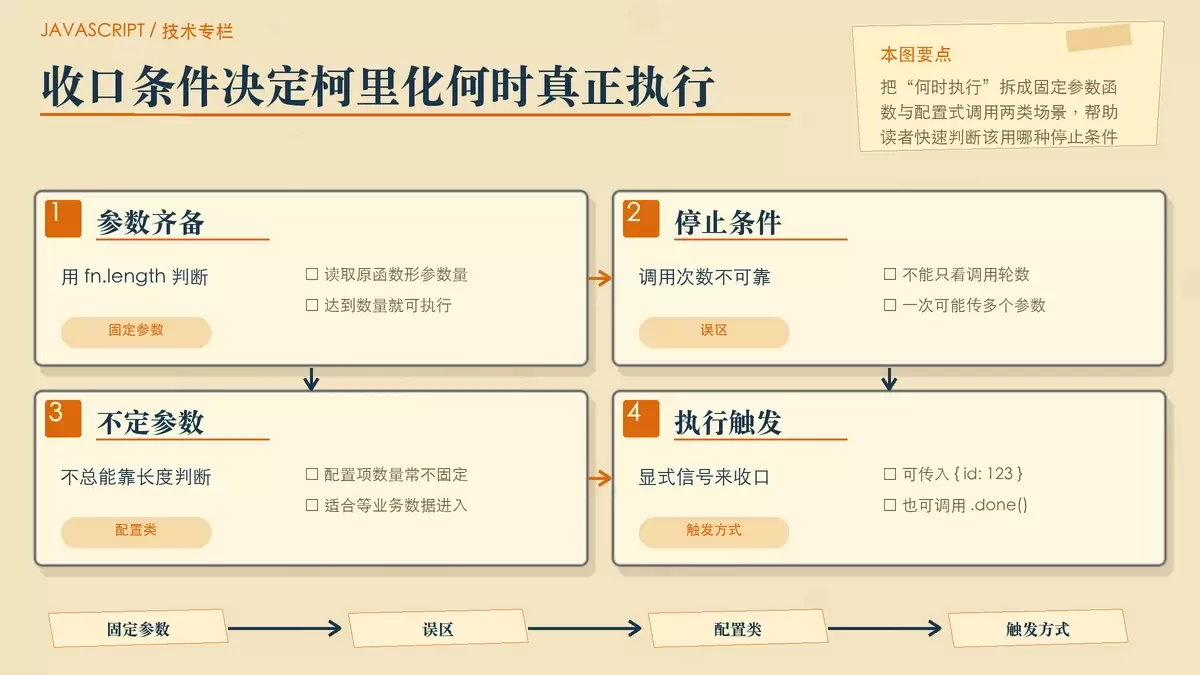
柯里化做到最后,必须解决一个问题:什么时候算“参数够了”,可以正式执行?这里不能只凭调用了几次来判断,因为一次调用可能传一个参数,也可能传多个参数,配置式场景甚至参数数量本来就不固定。
更可靠的判断一般有两种。
用 fn.length 判断固定参数是否齐备
对于固定形参的函数,fn.length 可以读取原函数声明时的形参数量,因此常被用作“是否收集完成”的依据。只要闭包里累积的参数数目达到这个值,就可以把所有参数一次性交给目标函数。
这种做法适合普通函数柯里化,因为停止条件清晰,而且和“调用了多少轮”无关,只和“已经拿到多少个有效参数”有关。
用显式触发处理不定数量的配置式调用
但如果是配置类柯里化,单纯依赖 fn.length 往往不够,因为配置项数量本身就不固定。这类场景更常见的做法,是等到某个业务数据传入时再执行,比如收到 { id: 123 },或者通过显式调用 .done() 来触发收口。
一旦满足这些条件,闭包里前面分步积累下来的所有参数或配置,就会被统一打包并传给原函数,整个柯里化过程到这里结束。
写柯里化时最该先判断的三件事
如果你在实现或阅读一段柯里化代码,可以先按下面三个问题快速判断它的设计是否清楚:
- 它把参数存在哪里:是闭包里的
args,还是闭包里的config - 它怎么累积:是
args.concat(newArgs)这种数组追加,还是Object.assign(target, newConfig)这种对象合并 - 它何时执行:是依赖
fn.length,还是靠业务数据、.done()这类显式信号触发
把这三点拆开看,闭包在柯里化中的作用就很明确了:它并不是一个抽象概念,而是用来保存中间状态、持续累积参数,并在满足条件时完成最后一次调用的底层机制。















