


深入解析Python字典底层实现:散列表与扩容机制

本文深入剖析Python字典的底层数据结构,重点讲解散列表(Sparse Array)的存储机制。通过解析哈希值计算、偏移量确定及冲突解决流程,阐明字典如何实现快速查询。同时详细说明了当负载因子接近2/3时触发的扩容机制,以及键对象必须满足的可散列性要求,帮助开发者理解字典的空间换时间特性及遍历修改的注意事项。
字典对象的核心数据结构是散列表。散列表本质上是一个稀疏数组,其内部包含大量空白元素,数组中的每个单元被称为 bucket(桶)。每个 bucket 包含两部分引用:一部分指向键对象,另一部分指向值对象。由于所有 bucket 的结构和大小保持一致,系统可以通过计算偏移量来高效读取指定的 bucket。下文将通过数据的存储与获取流程,详细解析字典的底层工作原理。
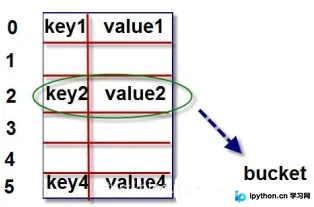
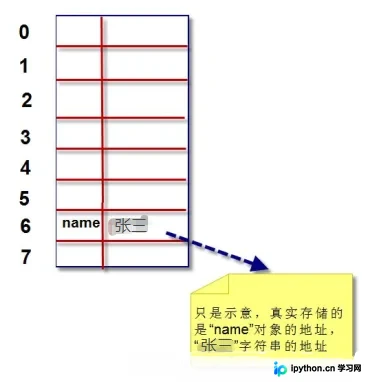
数据存储的具体过程如下所述。
以将键值对 'name' = '张三' 存入字典 map 为例,假设当前散列表数组长度为8,该长度可用3位二进制数表示。
>>> map = {}
>>> map
{}
>>> map['name'] = '张三'
第一步是计算键 'name' 的散列值(Hash Value)。
>>> bin(hash('name'))
'0b101011100000110111101000101010100010011010110010100101001000110'
第二步,取散列值最右侧的3位二进制数作为偏移量。例如,若最右侧3位为“110”,转换为十进制即为数字6。系统检查偏移量为6的 bucket 是否为空:若为空,则直接将键值对存入;若不为空(发生哈希冲突),则依次右移3位,取新的3位作为偏移量(例如“000”,即十进制0),并重复此过程,直到找到空的 bucket 为止。Python 会根据散列表的拥挤程度决定是否进行“扩容”。扩容是指创建更大的数组,并将原有内容拷贝至新数组中。当散列表的使用率接近 2/3 时,系统将触发扩容操作。扩容后,用于计算偏移量的位数会增加,例如数组长度扩容至16时,将使用最右侧4位二进制数作为偏移量。
数据获取的具体过程如下所述。
>>> map.get('name')
'张三'
第一步,同样计算键 'name' 的散列值。
第二步,取散列值最右侧3位二进制数作为偏移量(如“110”,即十进制6)。检查偏移量为6的 bucket 是否为空:若为空,则返回 None;若不为空,则计算该 bucket 中键对象的散列值,并与当前计算的散列值进行比较。若两者相等,则返回对应的“值对象”;若不相等,则继续依次取其他位数字重新计算偏移量,循环此过程直至找到匹配项。
核心要点总结:
1. 字典的键必须是可散列(hashable)的,例如数字、元组、字符串等。对于自定义对象,必须满足三个条件:支持 hash 方法、支持通过 __eq__() 方法检测相等性,且若 a==b 为真,则 hash(a)==hash(b) 也必须为真。
>>> b = [1,2] //List不可散列
>>> bin(hash(b))
Traceback (most recent call last):
 File "<pyshell#90>", line 1, in <module>
  bin(hash(b))
TypeError: unhashable type: 'list'
2. 字典在内存中开销较大,体现了典型的“空间换时间”设计思想;
3. 基于散列表结构,键的查询速度非常快;
4. 向字典中添加新键可能导致散列表扩容,进而引起散列表中键的存储次序发生变化。因此,严禁在遍历字典的同时对字典进行增删修改操作。
总结
以上即为 Python 字典底层原理的完整解析,希望本文内容能对您的学习或工作提供参考价值。感谢支持。如需了解更多相关技术细节,请查阅相关链接。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















