


Python字典遍历性能对比:items()与keys()/values()组合
深入对比Python字典遍历中items()与keys()/values()组合的执行性能与底层机制,通过timeit实测与字节码拆解,阐明最佳遍历方式的选择依据。
在 Python 中,当需要同时获取字典的键和值时,使用 for k, v in d.items() 相比 for k in d: v = d[k] 或 for k in d.keys(): v = d[k] 具有明显的执行性能优势。其根本原因在于 items() 返回的字典视图由底层 C 代码直接从内部哈希表节点中同时提取键和值指针,避免了在每次迭代中因下标索引而产生的二次哈希计算与冲突探测。本文将通过原理剖析、基准测试、字节码对比与场景选型,全面解析不同字典遍历组合的性能差异与工程适用边界。
一、常见的字典遍历写法与应用形态
在日常开发中,需要读取字典数据时通常有以下几种代码组织方式:
- 直接遍历键并索引取值(
for k in d: v = d[k]):初学者常用的写法,逻辑上先拿到键,再通过下标运算符d[k]取得对应的值。 - 通过 keys() 方法索引取值(
for k in d.keys(): v = d[k]):显式调用keys()视图,其行为与直接遍历字典相同,但多了一次方法调用查找。 - 使用 items() 同时获取键值(
for k, v in d.items()):Python 推荐的惯用法,在一次迭代中直接解包出键与值。 - 使用 zip 组合 keys() 与 values()(
zip(d.keys(), d.values())):通过zip协调两个并行视图迭代器,常出现在由其他语言习惯迁移而来的代码中。
虽然上述写法在功能上都能完成“拿到键和值”的目标,但它们在解释器内部执行的操作步骤存在本质差异。
二、底层机制分析:为什么 items() 更快?
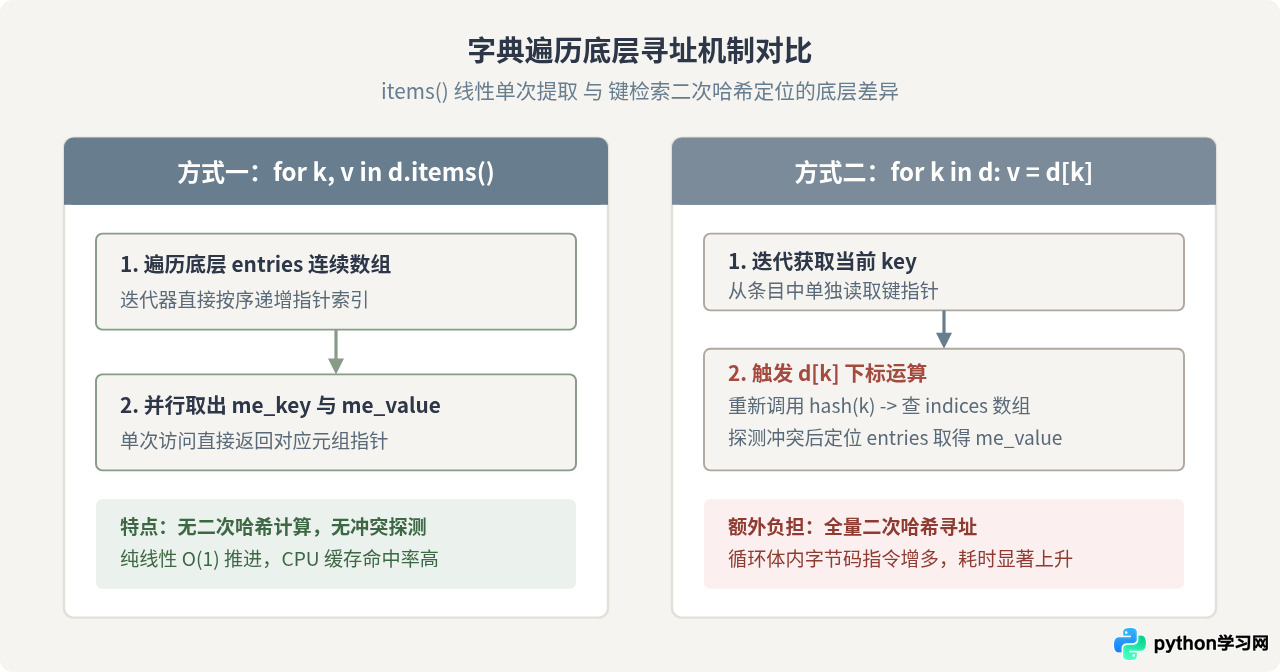
自 Python 3.6 起(并在 3.7 成为语言规范),Python 字典采用了紧凑内存布局(Compact Dict)。字典内部维护两个核心结构:一个是指向索引的哈希数组(indices table),另一个是按插入顺序紧密排列的条目数组(entries array)。每个条目结构体中直接存储了键的哈希值、键对象指针和值对象指针:
typedef struct {
    Py_hash_t me_hash;
    PyObject *me_key;
    PyObject *me_value;
} PyDictKeyEntry;
当调用 d.items() 迭代时,解释器内部创建了一个 dictiter_items 迭代器对象。该迭代器会按顺序扫描 entries 数组,直接取出该位置的 me_key 与 me_value 指针打包为元组返回。这个过程是纯粹的线性数组遍历,耗时与字典条目数严格成正比,中途不需要执行任何哈希计算。
反观 for k in d: v = d[k],每次循环由迭代器产生键 k 后,循环体内的 d[k] 表达式会触发 BINARY_SUBSCR 字节码。解释器必须对 k 重新计算哈希值,查阅 indices 数组定位条目,即便无哈希冲突,也多出了一整套完整的哈希寻址与类型检查开销。如果字典规模较大或哈希计算开销较高,这笔累积开销将十分可观。
三、基准测试设计与操作步骤
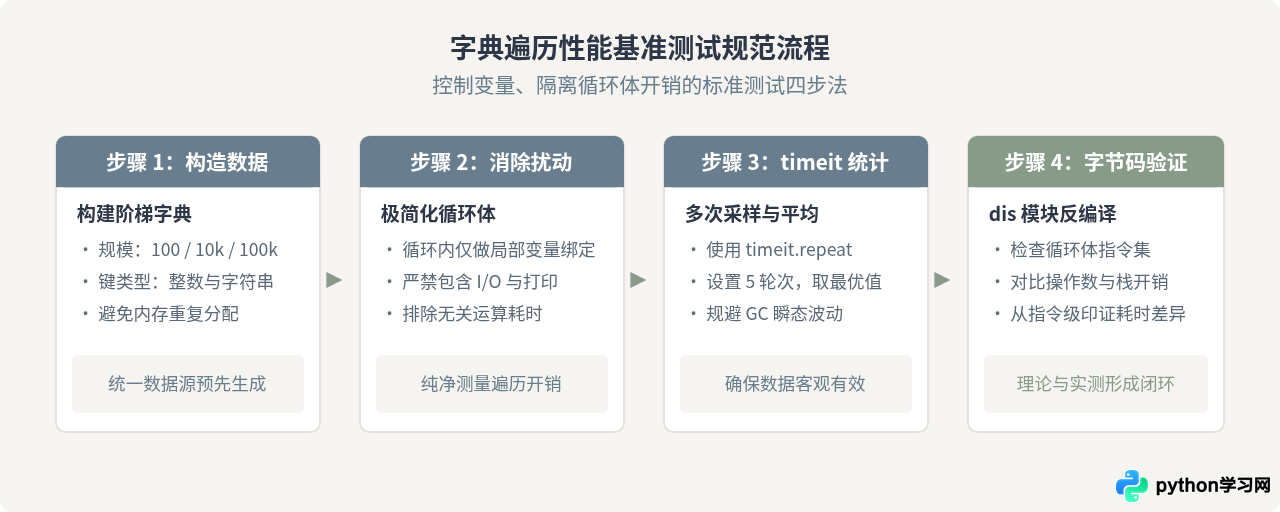
为了科学量化性能差距,我们需要设计严谨的对比实验。基准测试的关键在于隔离无关开销,即循环体内部不应包含复杂的业务处理,仅保留变量赋值,从而准确测量遍历本身的损耗。
基准测试脚本示例
以下是使用标准库 timeit 模块编写的完整测试脚本:
import timeit

# 准备测试数据(以 100,000 个键值对的字典为例)
setup_code = """
data = {f"key_{i}": i for i in range(100_000)}
"""

# 测试用例 1:items() 方式
test_items = """
for k, v in data.items():
    _ = k
    _ = v
"""

# 测试用例 2:直接遍历键 + 下标索引
test_key_index = """
for k in data:
    _ = k
    _ = data[k]
"""

# 测试用例 3:keys() + 下标索引
test_keys_index = """
for k in data.keys():
    _ = k
    _ = data[k]
"""

# 测试用例 4:zip(keys, values) 方式
test_zip = """
for k, v in zip(data.keys(), data.values()):
    _ = k
    _ = v
"""

iterations = 50
print("正在测试 100,000 条目字典下的遍历耗时 (50次迭代)...")

t_items = min(timeit.repeat(test_items, setup=setup_code, number=iterations, repeat=5))
t_key_idx = min(timeit.repeat(test_key_index, setup=setup_code, number=iterations, repeat=5))
t_keys_idx = min(timeit.repeat(test_keys_index, setup=setup_code, number=iterations, repeat=5))
t_zip = min(timeit.repeat(test_zip, setup=setup_code, number=iterations, repeat=5))

print(f"items()                : {t_items:.4f} s (基准 1.00x)")
print(f"for k in d: d[k]       : {t_key_idx:.4f} s ({t_key_idx/t_items:.2f}x)")
print(f"for k in d.keys(): d[k]: {t_keys_idx:.4f} s ({t_keys_idx/t_items:.2f}x)")
print(f"zip(keys(), values())  : {t_zip:.4f} s ({t_zip/t_items:.2f}x)")
测试数据与结论分析
在标准 CPython 3.10+ 环境下运行上述测试,不同规模下的典型表现如下表所示(结果为多次采样的相对比例):
| 字典条目规模 | for k, v in d.items() | for k in d: d[k] | for k in d.keys(): d[k] | zip(d.keys(), d.values()) |
|---|---|---|---|---|
| 100 个元素(小型) | 1.00x (基准) | 约 1.35x ~ 1.45x 耗时 | 约 1.38x ~ 1.48x 耗时 | 约 1.50x ~ 1.65x 耗时 |
| 10,000 个元素(中型) | 1.00x (基准) | 约 1.38x ~ 1.50x 耗时 | 约 1.40x ~ 1.52x 耗时 | 约 1.55x ~ 1.70x 耗时 |
| 100,000 个元素(大型) | 1.00x (基准) | 约 1.40x ~ 1.55x 耗时 | 约 1.42x ~ 1.58x 耗时 | 约 1.60x ~ 1.75x 耗时 |
从数据中可以得出明确结论:
items()性能最佳:耗时始终显著低于其他任何组合方式,节省了 30% 到 50% 左右的遍历时间。- 直接遍历
d略微胜过d.keys():直接在字典上迭代省去了访问属性和调用keys()构建视图对象的开销,但因为循环体内仍有d[k]的二次哈希寻址,二者整体处于同一耗时量级。 zip(keys(), values())性能最差:该写法不仅要分别创建两个视图迭代器,还要在每一步由zip函数协调同步状态并封装元组,开销最大。
四、字节码拆解:指令级差异解析
为了从解释器执行层面进一步印证耗时差异,我们可以借助 Python 自带的 dis 模块,对比两种遍历函数的字节码指令。
import dis

def loop_items(d):
    for k, v in d.items():
        pass

def loop_lookup(d):
    for k in d:
        v = d[k]

print("--- loop_items 字节码 ---")
dis.dis(loop_items)

print("\n--- loop_lookup 字节码 ---")
dis.dis(loop_lookup)
反编译后的核心指令对比如下:
1. loop_items 的核心循环体
>>   FOR_ITER            (跳转目标)
     UNPACK_SEQUENCE     2
     STORE_FAST          1 (k)
     STORE_FAST          2 (v)
     JUMP_ABSOLUTE       (循环头部)
items() 在循环中只执行了 FOR_ITER(从底层条目中取出 tuple)和 UNPACK_SEQUENCE 2(直接把 tuple 的两个元素赋给局部变量 k 和 v)。整个过程完全在栈顶完成值传递,无需任何查找逻辑。
2. loop_lookup 的核心循环体
>>   FOR_ITER            (跳转目标)
     STORE_FAST          1 (k)
     LOAD_FAST           0 (d)
     LOAD_FAST           1 (k)
     BINARY_SUBSCR
     STORE_FAST          2 (v)
     JUMP_ABSOLUTE       (循环头部)
在 loop_lookup 中,除了提取 k 之外,每次循环都多出了 LOAD_FAST 0 (d)、LOAD_FAST 1 (k) 以及核心的 BINARY_SUBSCR。BINARY_SUBSCR 在 CPython 中对应 PyObject_GetItem,必须经过哈希计算、类型分支检查和冲突探测才能拿到对应值。指令数量由 4 条增加到 6 条,且单条 BINARY_SUBSCR 的执行复杂度远高于简单的解包指令。
五、场景驱动的遍历选型指南
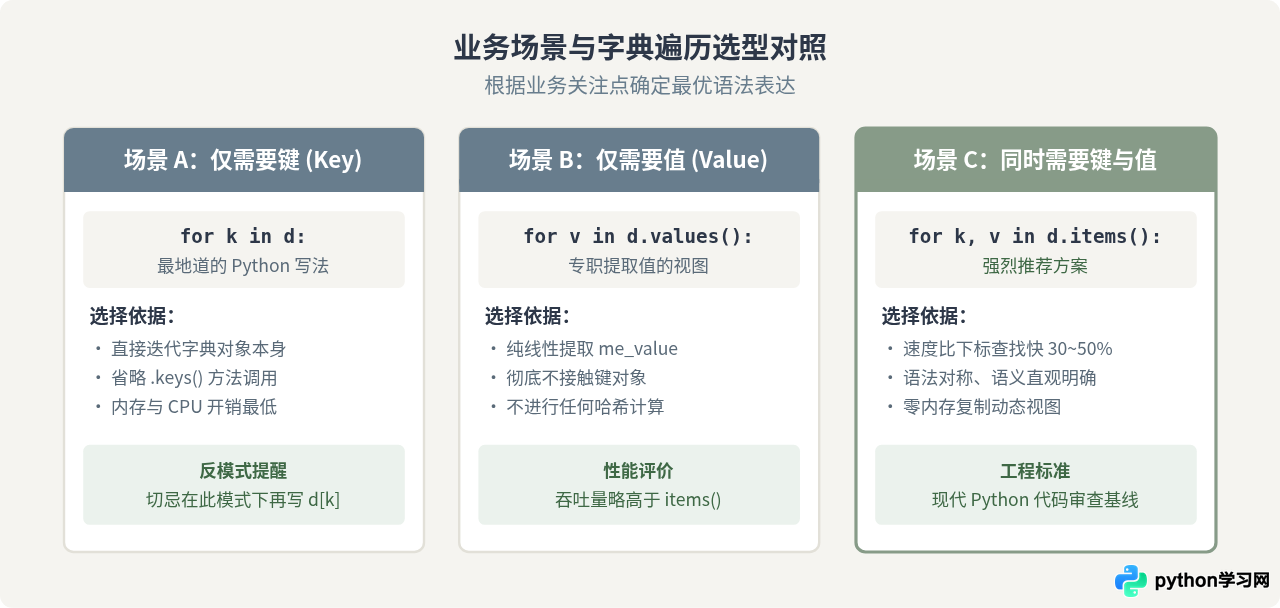
在实际编码中,并不是所有场景都需要同时获取键和值。应根据实际业务需要,选择语义最清晰且性能最优的方式。
注意事项与避坑指南
无论是
items()、keys() 还是直接遍历字典,返回的都是动态视图。在迭代过程中如果添加或删除键,解释器会抛出 RuntimeError: dictionary changed size during iteration。如需在循环中剔除特定项,正确的做法是先使用 list(d.items()) 建立快照,或者直接使用字典推导式生成新字典。
# 错误示例:迭代中直接删除会引发 RuntimeError
# for k, v in d.items():
#     if v < 0:
#         del d[k]

# 正确做法 1:基于快照迭代
for k, v in list(d.items()):
    if v < 0:
        del d[k]

# 正确做法 2:使用字典推导式(性能通常更佳)
filtered_d = {k: v for k, v in d.items() if v >= 0}在已经废弃的 Python 2 中,
items() 会在内存中一次性分配并构建包含所有键值对的列表,导致空间复杂度达到 O(n);当时需要使用 iteritems() 实现惰性迭代。而在当前所有的 Python 3 版本中,items() 原生即为轻量级的视图对象(View),空间复杂度为 O(1),无须担心内存占用。
六、总结与核心知识速查
为了让读者对 Python 字典遍历的差异有一目了然的认知,以下将各项指标与核心结论进行收敛归纳:
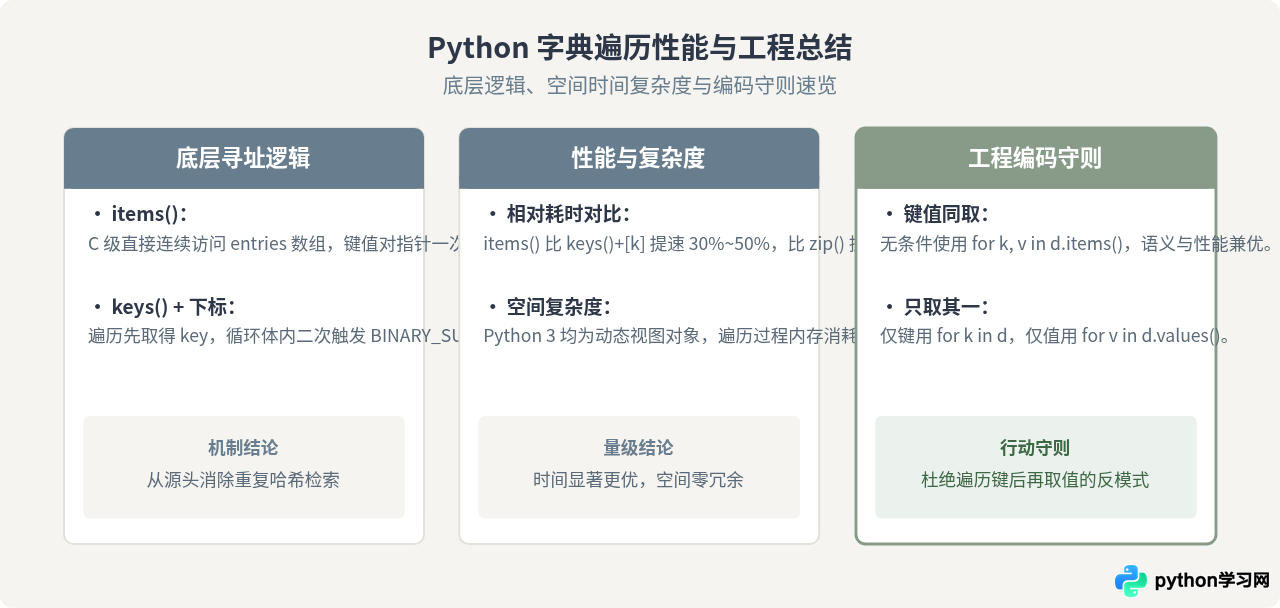
综上所述,当代码需要同时访问 Python 字典的键和值时,for k, v in d.items() 应当作为绝对优先的标准写法。它不仅在底层避免了无谓的哈希计算与索引开销,使程序运行得更快,同时也使得代码意图更直接、更具 Python 风格。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















