


基于Python与Scrapy的微信租房机器人实战解析

本文详细介绍如何利用Python、Scrapy爬虫框架及Whoosh搜索引擎构建一个自动抓取豆瓣租房信息并推送到微信的机器人。通过jieba分词与索引生成API,结合wxBot接口实现定时推送与持久化存储,帮助租房者高效获取实时房源。
项目背景与目标
项目目标
两年前,笔者曾开发过一个用于租房场景的自动化工具,主要功能是从豆瓣租房小组抓取数据并定时推送至微信。该工具运行一段时间后便停止维护。
由于早期代码结构较为简单,未曾公开源码。考虑到开源项目可能有助于其他用户更高效地获取租房信息,现对代码进行整理后在GitHub开源,仓库地址为:https://github.com/facert/zufang(支持本地下载)。
以下是该项目的基本原理说明:
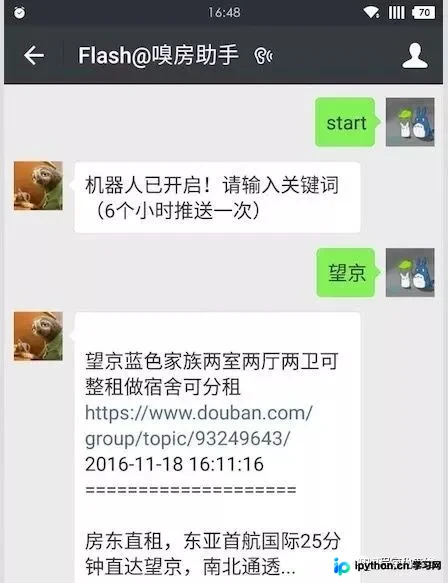
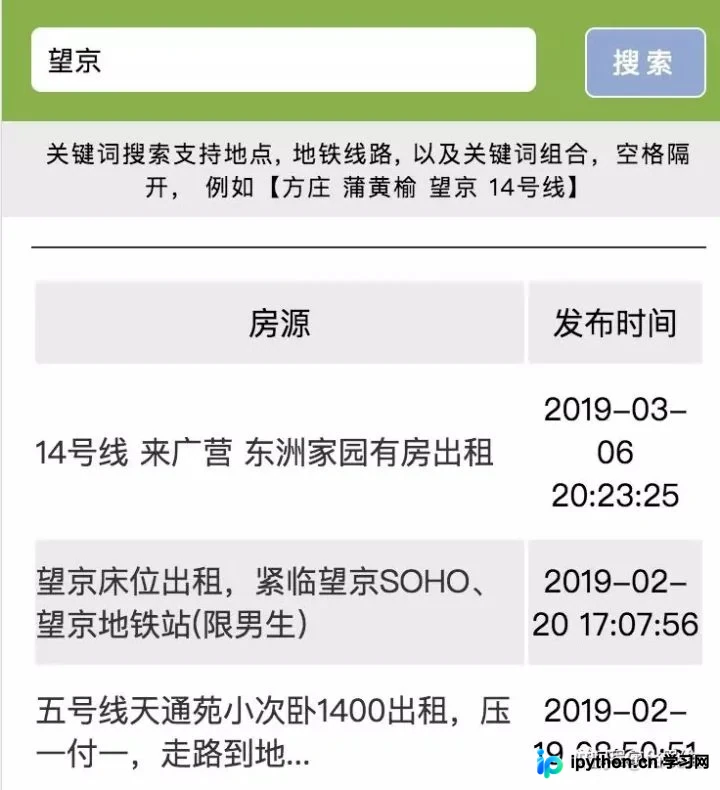
对于身处北京等大城市的人群而言,租房往往是一项耗时耗力的任务。豆瓣租房小组虽然房源相对可靠,但因其信息杂乱且缺乏搜索功能,实时获取目标房源极具挑战。为此,笔者开发了这款微信找房机器人,具体效果可参考下图展示:
技术实现方案
技术实现方案
整体技术架构主要包含三个部分:首先,利用Scrapy爬虫框架对豆瓣北京租房小组进行实时数据抓取,并通过jieba进行中文分词,结合Whoosh引擎对标题和描述建立全文索引,最终封装为API接口。其次,接入微信机器人接口,基于开源项目[[wxBot]]进行修改,实现了定时推送消息及数据持久化存储功能。最后,公众号端也实现了相同的功能,支持用户实时搜索租房信息。
核心代码解析
核心代码片段
Scrapy框架支持自定义Pipeline,这使得在数据录入过程中实时生成索引成为可能。具体实现逻辑见下方代码:
class IndexPipeline(object):

 def __init__(self, index):
 self.index = index

 @classmethod
 def from_crawler(cls, crawler):
 return cls(
  index=crawler.settings.get('WHOOSH_INDEX', 'indexes')
 )

 def process_item(self, item, spider):
 self.writer = AsyncWriter(get_index(self.index, zufang_schema))
 create_time = datetime.datetime.strptime(item['create_time'], "%Y-%m-%d %H:%M:%S")
 self.writer.update_document(
  url=item['url'].decode('utf-8'),
  title=item['title'],
  description=item['description'],
  create_time=create_time
 )
 self.writer.commit()
 return item
搜索API的实现逻辑相对简洁,主要流程如下:
def zufang_query(keywords, limit=100):
 ix = get_index('indexes', zufang_schema)
 content = ["title", "description"]
 query = MultifieldParser(content, ix.schema).parse(keywords)
 result_list = []
 with ix.searcher() as searcher:
 results = searcher.search(query, sortedby="create_time", reverse=True, limit=limit)
 for i in results:
  result_list.append({'url': i['url'], 'title': i['title'], 'create_time': i['create_time']})
 return result_list
总结
以上内容即为该项目的完整介绍,希望能为从事相关学习或工作的读者提供有价值的参考。感谢各位的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















