


Python爬虫工程师面试核心考点与基础实战指南

本文系统梳理Python爬虫工程师面试高频考点,涵盖Python语言特性、6种内置数据类型辨析、CPython运行机制及GIL锁原理。深入解析深/浅拷贝、is与==区别、文件IO操作及一行代码实现技巧,并对比多进程与多线程的稳定性差异,助力求职者掌握核心基础知识。
Python爬虫面试知识体系概览
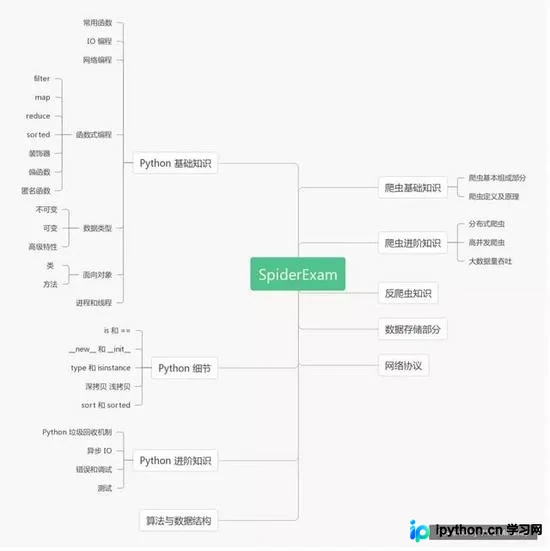
首先整理一份完整的爬虫工程师面试知识体系框架。
Python基础核心考点
一、 Python 基本功
1、简述Python 的特点和优点
Python 属于开源的解释型语言,相较于 Java 和 C++ 等编译型语言,Python 具备动态类型特性,语法简洁且灵活性极高。
2、Python 有哪些数据类型?
Python 内置了 6 种核心数据类型。其中不可变类型包括 Number(数值)、String(字符串)和 Tuple(元组);可变类型包括 List(列表)、Dict(字典)和 Set(集合)。
3、列表和元组的区别
列表和元组均支持迭代操作,如循环遍历和切片处理。主要区别在于元组(tuple)一旦创建便不可修改,这一不可变性使得元组可以作为字典(Dict)的键使用,而列表则不能。
CPython运行机制与性能优化
4、Python 是如何运行的
CPython 执行流程如下:
Python 程序执行时,首先将 .py 源代码编译为字节码(byte code),编译后的字节码对象存储在内存中的 PyCodeObject 里,随后由 Python 虚拟机(PVM)逐行解释执行。程序运行结束后,解释器会将 PyCodeObject 持久化保存为 .pyc 文件。再次运行时,Python 会优先查找同名 .pyc 文件,通过比对时间戳等修改记录,判断是否直接加载 .pyc 或重新编译生成新的 .pyc 文件。
5、Python 运行速度慢的原因
a). Python 属于弱类型语言,解释器在执行变量赋值、类型转换、比较运算及引用传递时,必须动态检查每个变量的数据类型,增加了运行时开销。
b). 虽然 Python 编译器启动速度优于 Java,但每次脚本执行通常都需要重新初始化编译环境。
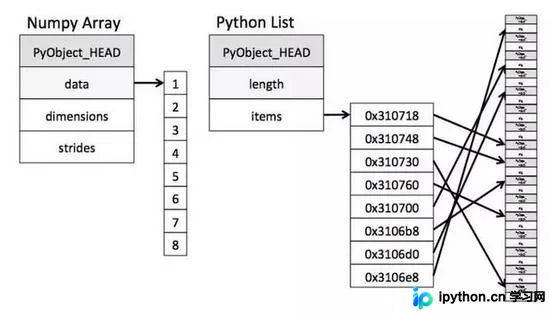
c). Python 的对象模型导致内存访问效率较低。例如 Numpy 中指针直接指向缓存区数据值,而 Python 中指针指向缓存对象,再通过缓存对象间接指向实际数据,增加了寻址层级。
6、面对 Python 慢的问题,有什么解决办法
a). 更换解释器,例如使用 PyPy(基于 JIT 编译)或 Jython(Java 平台实现)。
b). 对于性能要求高且静态类型变量较多的场景,可考虑使用 CPython 配合 C 扩展或 Cython 优化。
c). 针对 IO 密集型应用,利用 Python 提供的 asyncio 模块实现异步非阻塞 IO,提升并发处理能力。
7、描述一下全局解释器锁 GIL
在 CPython 中,每个线程执行前必须获取全局解释器锁(GIL),确保同一时刻仅有一个线程执行字节码,即单线程独占 CPU 时间片,因此多线程并非真正的并行执行。但在执行 IO 操作时,GIL 会被释放,允许其他线程运行(这也是异步 IO 可行的基础)。若需利用多核 CPU 进行计算密集型任务,应采用多进程而非多线程。
8、深拷贝 浅拷贝
深拷贝(Deep Copy)会递归复制对象及其包含的所有子对象,生成完全独立的新对象;浅拷贝(Shallow Copy)仅复制对象本身,子对象仍共享原对象的引用。因此,修改深拷贝后的对象不会影响原对象,而修改浅拷贝后的可变子对象会影响原对象。
9、is 和 == 的区别
is 用于比较两个对象的身份标识(object identity),即判断它们是否指向内存中的同一地址;== 用于比较两个对象的值是否相等(equality)。
is 检查内存地址是否一致,== 检查值是否相等。为优化性能,Python 对小整数和短字符串采用驻留机制(interning),即相同值的对象可能共享内存地址。例如:
a = 8

b = 8

a is b
文件IO与一行代码实战技巧
10、文件读写
简述文件读取时 read 、readline、readlines 的区别和作用
三者的区别不仅在于读取内容的范围,还在于返回的数据类型不同。
read() 方法读取整个文件内容,将其作为单个字符串返回,类型为 str。
readline() 方法每次读取文件中的一行内容,包含换行符,返回类型为 str。
readlines() 方法读取文件所有内容,按行分割并存入列表,返回类型为 list。
11、请用一行代码实现
请分别使用匿名函数和推导式这两种方式将 [0, 1, 2, 3, 4, 5] 中的元素求乘积,并打印输出元组。
print(tuple(map(lambda x: x * x, [0, 1, 2, 3, 4, 5])))
print(tuple(i*i for i in [0, 1, 2, 3, 4, 5]))
12、请用一行代码实现
用 reduce 计算 n 的阶乘(n!=1×2×3×...×n)
print(reduce(lambda x, y: x*y, range(1, n)))13、请用一行代码实现
筛选并打印输出 100 以内能被 3 整除的数的集合
print(set(filter(lambda n: n % 3 == 0, range(1, 100))))14、请用一行代码实现
text = 'Obj{"Name": "pic", "data": [{"name": "async", "number": 9, "price": "$3500"}, {"name": "Wade", "number": 3, "price": "$5500"}], "Team": "Hot"'打印文本中的球员身价元组,如 ( 5500)
print(tuple(i.get("price") for i in json.loads(re.search(r'[(.*)]', text).group(0))))15、请写出递归的基本骨架
def recursions(n):
 if n == 1:
 # 退出条件
 return 1
 # 继续递归
 return n * recursions(n - 1)
16、切片
请写出下方输出结果
tpl = [0, 5, 10, 15, 20, 25, 30, 35, 40, 45, 50, 55, 60, 65, 70, 75, 80, 85, 90, 95]
print(tpl[3:])
print(tpl[:3])
print(tpl[::5])
print(tpl[-3])
print(tpl[3])
print(tpl[::-5])
print(tpl[:])
del tpl[3:]
print(tpl)
print(tpl.pop())
tpl.insert(3, 3)
print(tpl)
[15, 20, 25, 30, 35, 40, 45, 50, 55, 60, 65, 70, 75, 80, 85, 90, 95]
[0, 5, 10]
[0, 25, 50, 75]
85
15
[95, 70, 45, 20]
[0, 5, 10, 15, 20, 25, 30, 35, 40, 45, 50, 55, 60, 65, 70, 75, 80, 85, 90, 95]
[0, 5, 10]
10
[0, 5, 3]
17、文件路径
打印输出当前文件所在目录路径
import os
print(os.path.dirname(os.path.abspath(__file__)))
打印输出当前文件路径
import os
print(os.path.abspath(__file__))
打印输出当前文件上两层文件目录路径
import os
print(os.path.dirname(os.path.dirname(os.path.abspath(__file__))))
切片操作与对象不可变性解析
18、请写出运行结果,并回答问题
tpl = (1, 2, 3, 4, 5)
apl = (6, 7, 8, 9)
print(tpl.__add__(apl))
问题:tpl 的值发生变化了吗?
运行结果如下:
(1, 2, 3, 4, 5, 6, 7, 8, 9)
答:元组是不可变对象,__add__ 方法返回的是新生成的元组对象,原 tpl 变量指向的元组并未改变,但打印输出的是新对象的值。
19、请写出运行结果,并回答问题
name = ('James', 'Wade', 'Kobe')
team = ['A', 'B', 'C']
tpl = {name: team}
print(tpl)
apl = {team: name}
print(apl)
问题:这段代码能运行完毕吗?为什么?它的运行结果是?
答:这段代码无法完整运行,会在创建 apl 字典时抛出异常。因为字典的键必须是不可变对象,而列表(list)是可变的,因此不能作为字典的键。运行结果是:
{('James', 'Wade', 'Kobe'): ['A', 'B', 'C']}
TypeError
装饰器与多进程多线程对比
20、装饰器
请写出装饰器代码骨架
def log(func):
 def wrapper(*args, **kw):
 print('call %s():' % func.__name__)
 return func(*args, **kw)
 return wrapper
简述装饰器在 Python 中的作用:
在不修改原函数源代码的前提下,动态增加新的功能(如日志记录、权限校验等)。
21、多进程 多线程
多进程更稳定还是多线程更稳定?为什么?
多进程更稳定,因为各进程拥有独立的内存空间,一个进程的崩溃不会影响其他进程。
多线程的致命缺点是什么?
由于所有线程共享同一进程的内存空间,任何一个线程发生崩溃(如段错误)都可能导致整个进程终止。
进程间通信有哪些方式?
常见的进程间通信(IPC)方式包括共享变量(如全局变量,但受 GIL 限制)、队列(Queue)和管道(Pipe)。
好了,本文就给大家介绍到这里,祝大家面试so easy!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















