


Python与PyQt5构建美剧下载爬虫可视化工具实战

本文介绍使用Python 3.7.1结合PyQt5框架开发美剧下载爬虫可视化工具的方法。通过urllib库处理HTTPS请求并忽略代理验证,利用XPath解析美剧天堂页面结构,提取剧集名称与下载链接。文章详细讲解了从数据抓取、URL编码处理到图形界面交互逻辑的完整实现过程,提供了Mac和Windows版本的可执行文件打包方案。
项目背景与开发思路
随着美剧《权力的游戏》最终季即将播出,作为乔治·R·R·马丁作品的忠实读者,为了理清第八季错综复杂的剧情脉络,我决定重新回顾前几季内容。虽然可以直接访问美剧天堂网站进行下载,但频繁操作较为繁琐,因此决定编写一个自动化爬虫程序来批量获取资源。
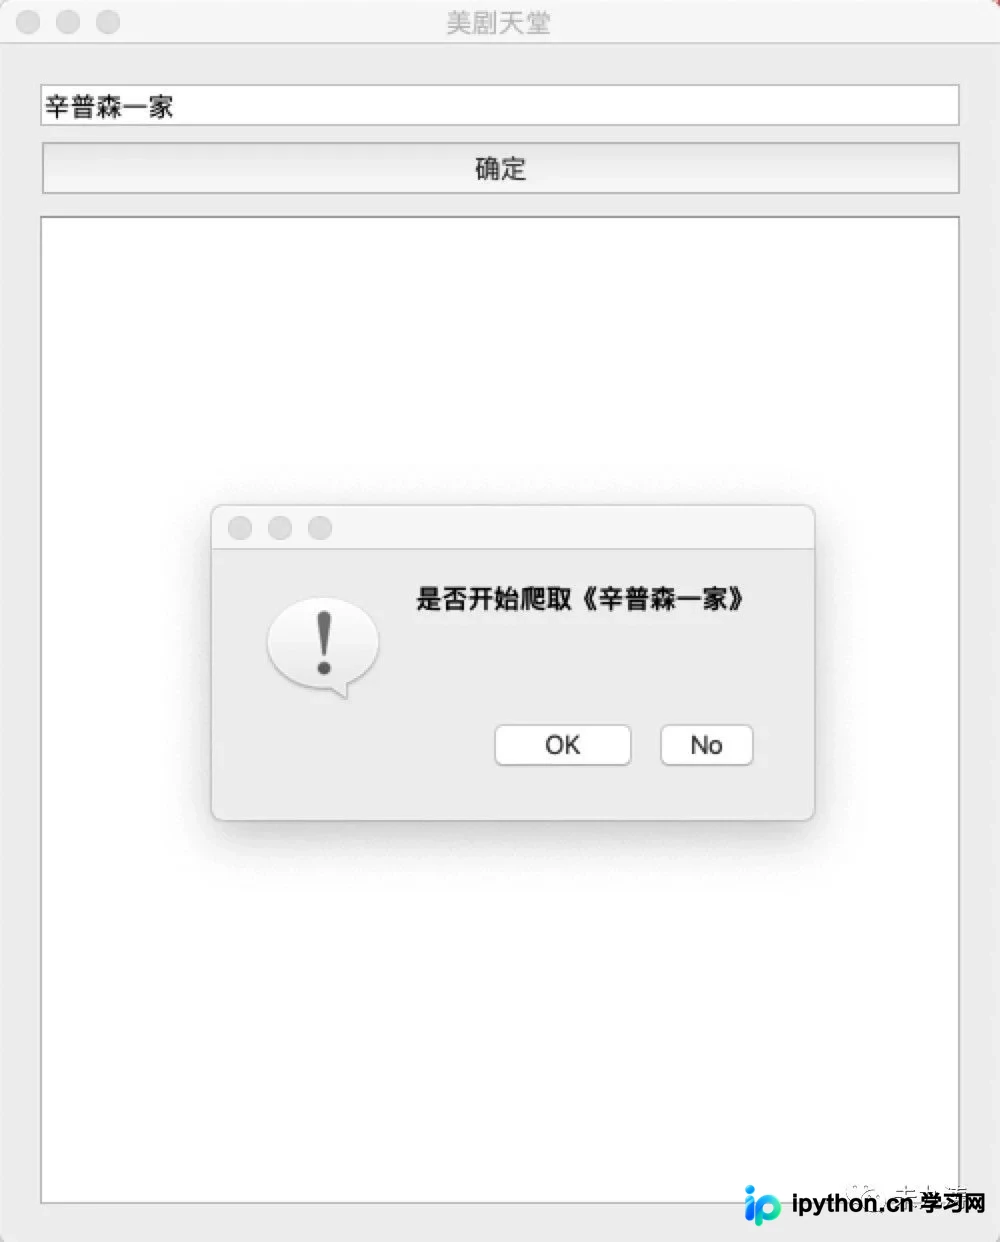
首先展示一下最终实现的软件界面效果。
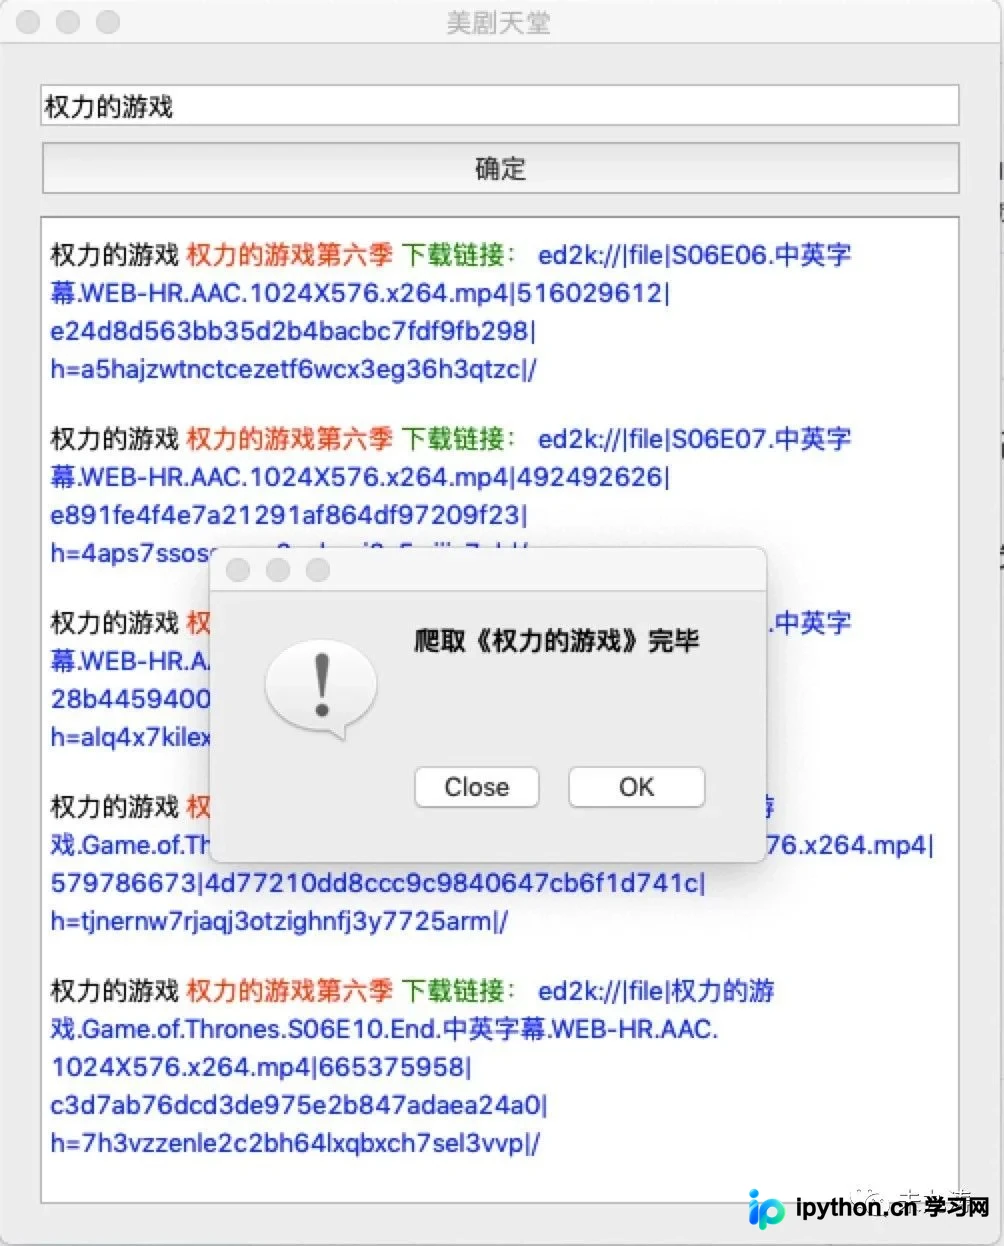
尽管代码实现较为简单,但核心在于功能可用,旨在提供一个便捷的可视化工具。
开发语言选定为Python,具体运行环境版本为3.7.1。
整体开发思路分为两步:首先利用Python脚本完成数据抓取,随后基于抓取结果构建图形用户界面(GUI)。
鉴于本项目仅涉及基础数据获取,不涉及Cookie管理等敏感信息,也未配置代理服务器,因此无需引入Selenium或Scrapy等重量级框架,直接使用标准库即可满足需求。
最终选定urllib库作为网络请求工具。在Python 2.X版本中,urllib和urllib2是两个独立模块,而在Python 3.X中二者已合并为统一的urllib模块,虽然语法细节有所差异,但核心逻辑保持一致。
核心代码实现与库选择
接下来展示核心代码片段,以辅助理解实现细节。
import urllib.request
from urllib import parse
from lxml import etree
import ssl
from PyQt5.QtWidgets import QApplication, QWidget, QLineEdit, QTextEdit, QVBoxLayout, QPushButton, QMessageBox
import sys

# 取消代理验证
ssl._create_default_https_context = ssl._create_unverified_context

class TextEditMeiJu(QWidget):
 def __init__(self, parent=None):
  super(TextEditMeiJu, self).__init__(parent)
  # 定义窗口头部信息
  self.setWindowTitle('美剧天堂')
  # 定义窗口的初始大小
  self.resize(500, 600)
  # 创建单行文本框
  self.textLineEdit = QLineEdit()
  # 创建一个按钮
  self.btnButton = QPushButton('确定')
  # 创建多行文本框
  self.textEdit = QTextEdit()
  # 实例化垂直布局
  layout = QVBoxLayout()
  # 相关控件添加到垂直布局中
  layout.addWidget(self.textLineEdit)
  layout.addWidget(self.btnButton)
  layout.addWidget(self.textEdit)
  # 设置布局
  self.setLayout(layout)
  # 将按钮的点击信号与相关的槽函数进行绑定,点击即触发
  self.btnButton.clicked.connect(self.buttonClick)

 # 点击确认按钮
 def buttonClick(self):
  # 爬取开始前提示一下
  start = QMessageBox.information(
   self, '提示', '是否开始爬取《' + self.textLineEdit.text() + "》",
   QMessageBox.Ok | QMessageBox.No, QMessageBox.Ok
  )
  # 确定爬取
  if start == QMessageBox.Ok:
   self.page = 1
   self.loadSearchPage(self.textLineEdit.text(), self.page)
  # 取消爬取
  else:
   pass

 # 加载输入美剧名称后的页面
 def loadSearchPage(self, name, page):
  # 将文本转为 gb2312 编码格式
  name = parse.quote(name.encode('gb2312'))
  # 请求发送的 url 地址
  url = "https://www.meijutt.com/search/index.asp?page=" + str(page) + "&searchword=" + name + "&searchtype=-1"
  # 请求报头
  headers = {"User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_3) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/72.0.3626.121 Safari/537.36"}
  # 发送请求
  request = urllib.request.Request(url, headers=headers)
  # 获取请求的 html 文档
  html = urllib.request.urlopen(request).read()
  # 对 html 文档进行解析
  text = etree.HTML(html)
  # xpath 获取想要的信息
  pageTotal = text.xpath('//div[@class="page"]/span[1]/text()')
  # 判断搜索内容是否有结果
  if pageTotal:
   self.loadDetailPage(pageTotal, text, headers)
  # 搜索内容无结果
  else:
   self.infoSearchNull()

 # 加载点击搜索页面点击的本季页面
 def loadDetailPage(self, pageTotal, text, headers):
  # 取出搜索的结果一共多少页
  pageTotal = pageTotal[0].split('/')[1].rstrip("页")
  # 获取每一季的内容(剧名和链接)
  node_list = text.xpath('//a[@class="B font_14"]')
  items = {}
  items['name'] = self.textLineEdit.text()
  # 循环获取每一季的内容
  for node in node_list:
   # 获取信息
   title = node.xpath('@title')[0]
   link = node.xpath('@href')[0]
   items["title"] = title
   # 通过获取的单季链接跳转到本季的详情页面
   requestDetail = urllib.request.Request("https://www.meijutt.com" + link, headers=headers)
   htmlDetail = urllib.request.urlopen(requestDetail).read()
   textDetail = etree.HTML(htmlDetail)
   node_listDetail = textDetail.xpath('//div[@class="tabs-list current-tab"]//strong//a/@href')
   self.writeDetailPage(items, node_listDetail)
  # 爬取完毕提示
  if self.page == int(pageTotal):
   self.infoSearchDone()
  else:
   self.infoSearchContinue(pageTotal)

 # 将数据显示到图形界面
 def writeDetailPage(self, items, node_listDetail):
  for index, nodeLink in enumerate(node_listDetail):
   items["link"] = nodeLink
   # 写入图形界面
   self.textEdit.append(
    "<div>"
     "<font color='black' size='3'>" + items['name'] + "</font>" + "\n"
     "<font color='red' size='3'>" + items['title'] + "</font>" + "\n"
     "<font color='orange' size='3'>第" + str(index + 1) + "集</font>" + "\n"
     "<font color='green' size='3'>下载链接:</font>" + "\n"
     "<font color='blue' size='3'>" + items['link'] + "</font>"
     "<p></p>"
    "</div>"
   )

 # 搜索不到结果的提示信息
 def infoSearchNull(self):
  QMessageBox.information(
   self, '提示', '搜索结果不存在,请重新输入搜索内容',
   QMessageBox.Ok, QMessageBox.Ok
  )

 # 爬取数据完毕的提示信息
 def infoSearchDone(self):
  QMessageBox.information(
   self, '提示', '爬取《' + self.textLineEdit.text() + '》完毕',
   QMessageBox.Ok, QMessageBox.Ok
  )

 # 多页情况下是否继续爬取的提示信息
 def infoSearchContinue(self, pageTotal):
  end = QMessageBox.information(
   self, '提示', '爬取第' + str(self.page) + '页《' + self.textLineEdit.text() + '》完毕,还有' + str(int(pageTotal) - self.page) + '页,是否继续爬取',
   QMessageBox.Ok | QMessageBox.No, QMessageBox.No
  )
  if end == QMessageBox.Ok:
   self.page += 1
   self.loadSearchPage(self.textLineEdit.text(), self.page)
  else:
   pass


if __name__ == '__main__':
 app = QApplication(sys.argv)
 win = TextEditMeiJu()
 win.show()
 sys.exit(app.exec_())
上述代码涵盖了功能实现的全部逻辑,具备Python运行环境的用户可直接复制并在本地执行。正如业界共识,Python确实是开发爬虫工具的高效选择,实践后深感其便捷性。
数据抓取逻辑详解
下面对代码逻辑进行逐步拆解分析:
import urllib.request
from urllib import parse
from lxml import etree
import ssl
from PyQt5.QtWidgets import QApplication, QWidget, QLineEdit, QTextEdit, QVBoxLayout, QPushButton, QMessageBox, QLabel
import sys
代码头部引入了必要的依赖库。前四个库用于处理美剧天堂网站的数据请求,后两个库则负责构建图形化应用程序界面。
首先探讨如何从网站获取信息。
由于目标网站采用HTTPS协议,且访问时可能涉及代理验证,为简化流程,代码中使用了ssl模块来取消默认的证书验证检查。
完成上述配置后,即可正常发起网络请求访问网站。
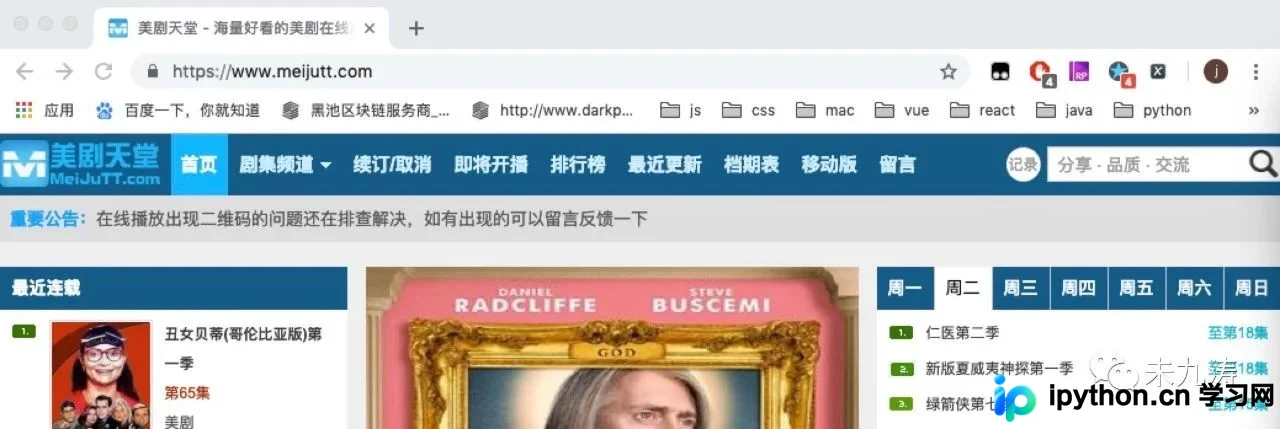
初始访问的URL为https://www.meijutt.com/search/index.asp,该地址本身并不包含具体的搜索结果信息。当用户刷新页面时,界面显示如下:
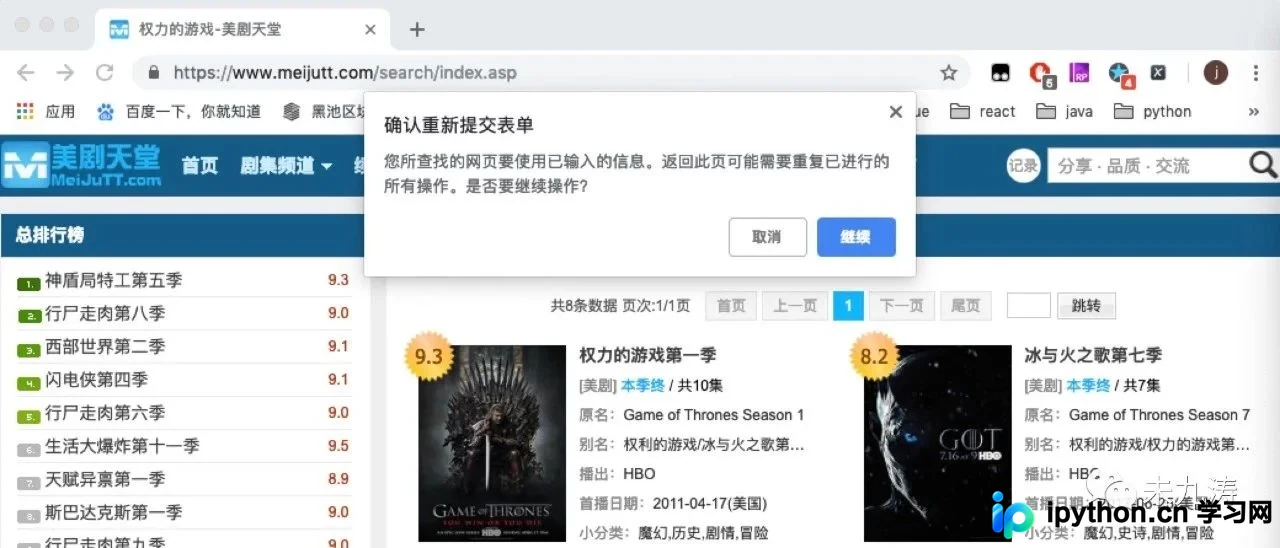
若手动在浏览器地址栏输入上述URL进行搜索,页面表现如下:
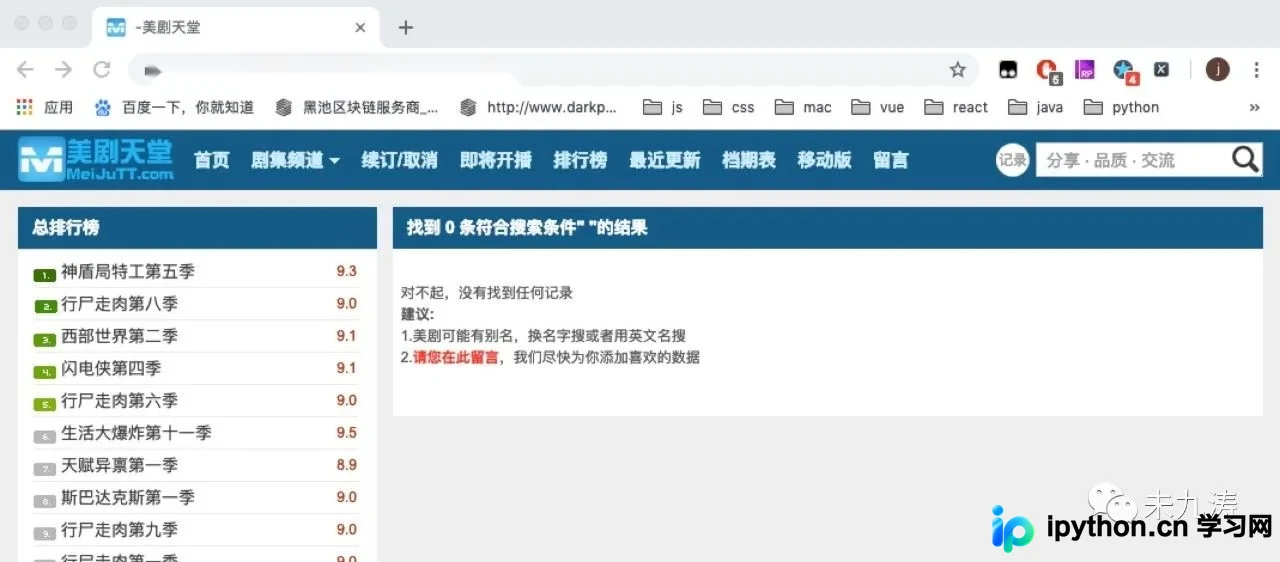
观察发现,当在首页输入美剧名称并提交搜索时,网站并未将参数直接拼接至URL中,而是通过隐藏表单提交数据。为了避免每次都要从首页手动提交表单的繁琐操作,经过研究发现了更优的URL构造方法,具体效果如下图所示:
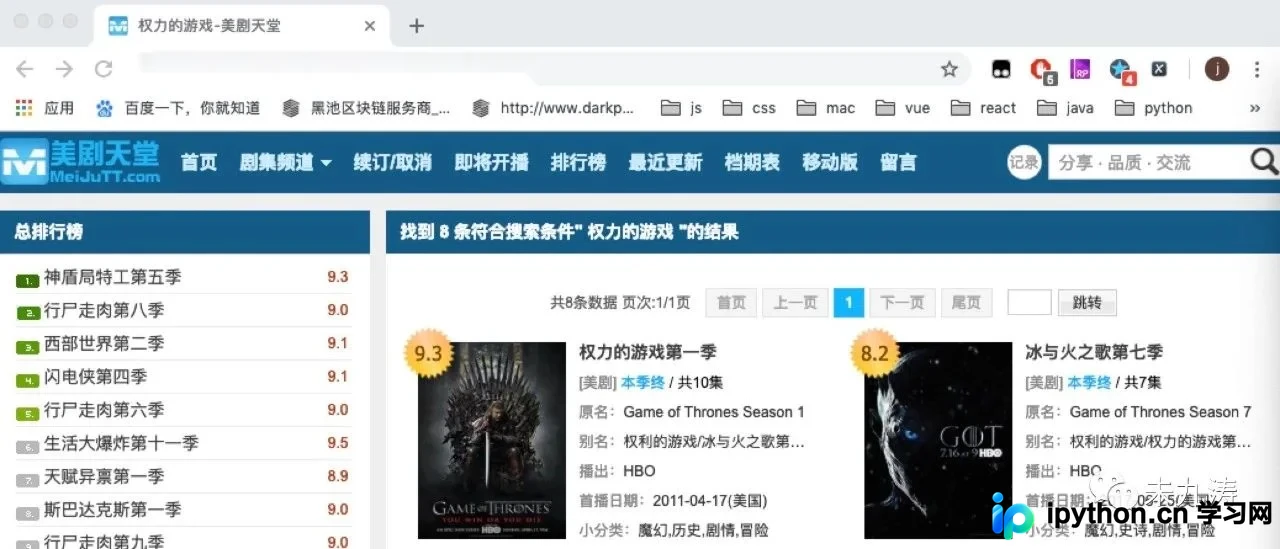
页面顶部提供了分页跳转功能,允许用户选择特定的页码。当切换页码后,页面布局发生如下变化:
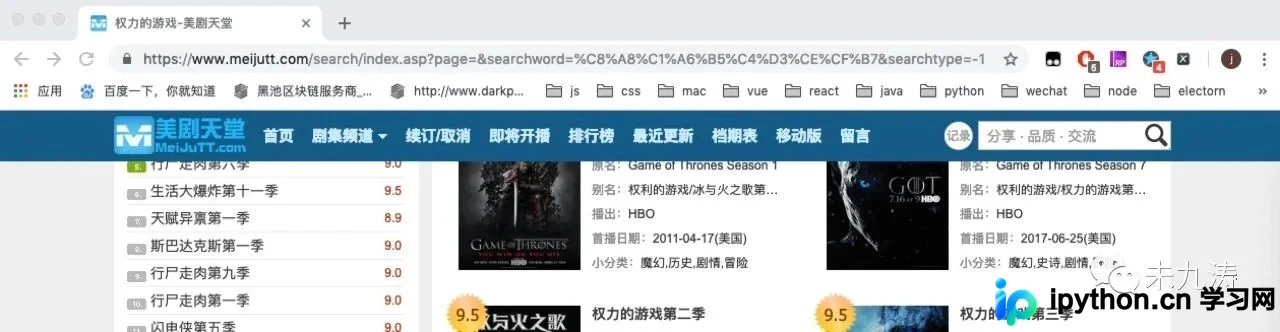
此时URL链接发生了改变,格式变为:https://www.meijutt.com/search/index.asp?page=&searchword=%C8%A8%C1%A6%B5%C4%D3%CE%CF%B7&searchtype=-1。
若将page参数动态设置为page=1,页面显示效果与手动翻页一致。
通过对多部不同剧集的多次搜索验证,发现URL中仅page和searchword两个参数发生变化。其中page默认为1,对于集数较少的美剧(如《老友记》、《生活大爆炸》、《邪恶力量》),通常只需一页即可显示完毕;而对于集数较多的剧集(如《辛普森一家》、《法律与秩序》),则可能涉及多页数据。因此需要对页数进行控制。需特别注意,若搜索内容过于宽泛(例如仅输入单个字母“i”),可能导致搜索结果多达219页,这将极大增加抓取耗时,故必须对搜索页数进行合理限制。
进一步分析searchword参数,将其解码转换为汉字后:
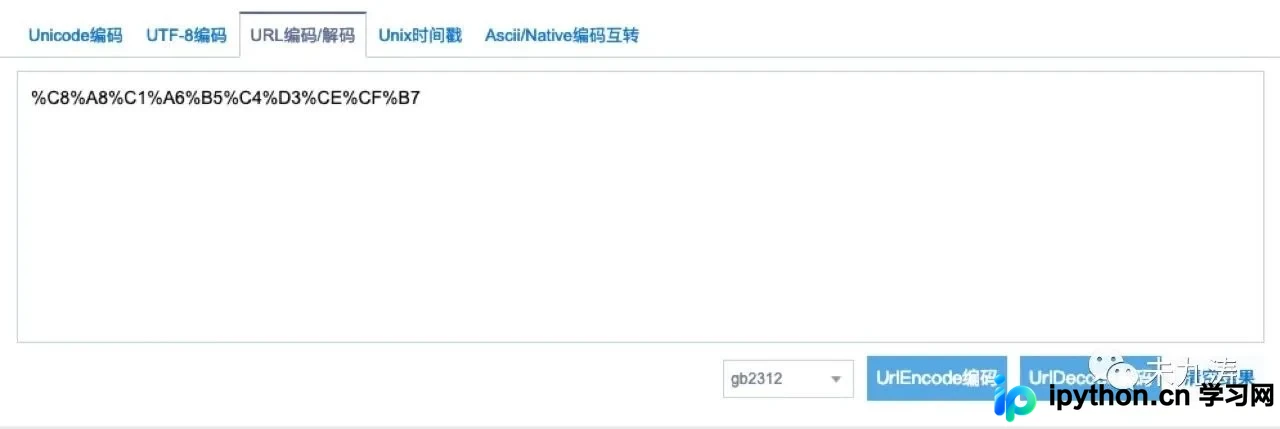
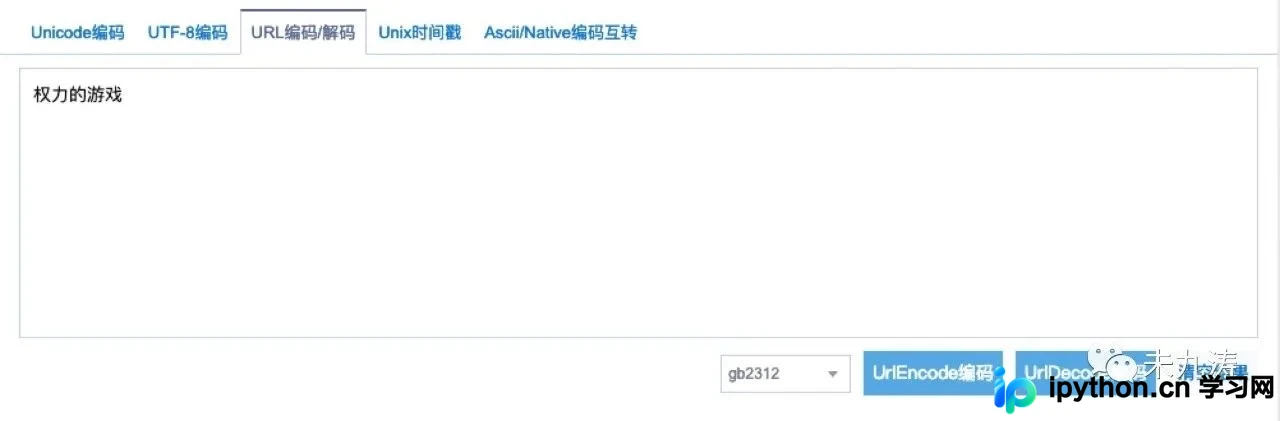
结果显示该参数确实对应我们输入的美剧名称,这标志着数据抓取的第一步已成功实现。
# 加载输入美剧名称后的页面
def loadSearchPage(self, name, page):
 # 将文本转为 gb2312 编码格式
 name = parse.quote(name.encode('gb2312'))
 # 请求发送的 url 地址
 url = "https://www.meijutt.com/search/index.asp?page=" + str(page) + "&searchword=" + name + "&searchtype=-1"
 # 请求报头
 headers = {"User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_3) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/72.0.3626.121 Safari/537.36"}
 # 发送请求
 request = urllib.request.Request(url, headers=headers)
 # 获取请求的 html 文档
 html = urllib.request.urlopen(request).read()
 # 对 html 文档进行解析
 text = etree.HTML(html)
 # xpath 获取想要的信息
 pageTotal = text.xpath('//div[@class="page"]/span[1]/text()')
 # 判断搜索内容是否有结果
 if pageTotal:
  self.loadDetailPage(pageTotal, text, headers)
 # 搜索内容无结果
 else:
  self.infoSearchNull()
接下来的任务是将用户输入的美剧名称转换为URL编码格式。如上所示,通过urllib库对目标网站发起操作。
此外,还需增加判断逻辑以确认搜索结果是否存在,例如搜索“行尸跑肉”时可能返回无结果的情况。
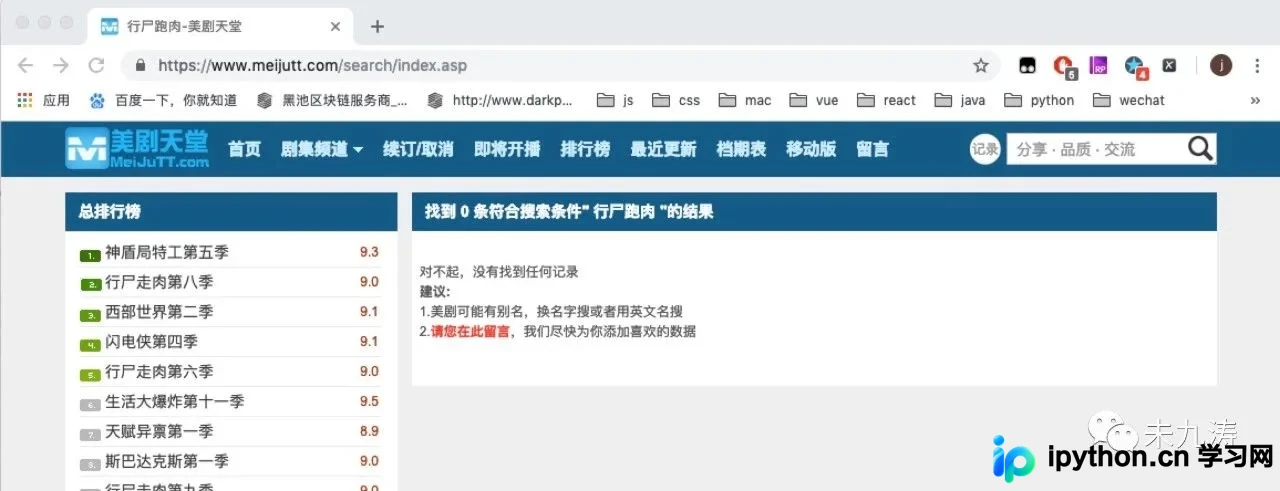
当搜索结果存在时,页面显示如下:
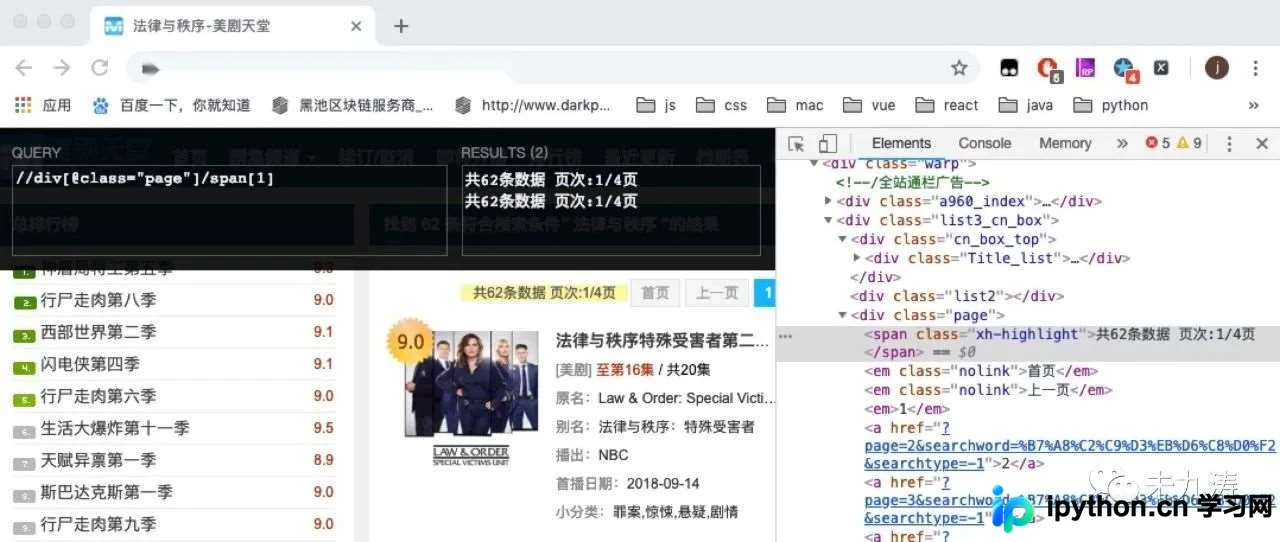
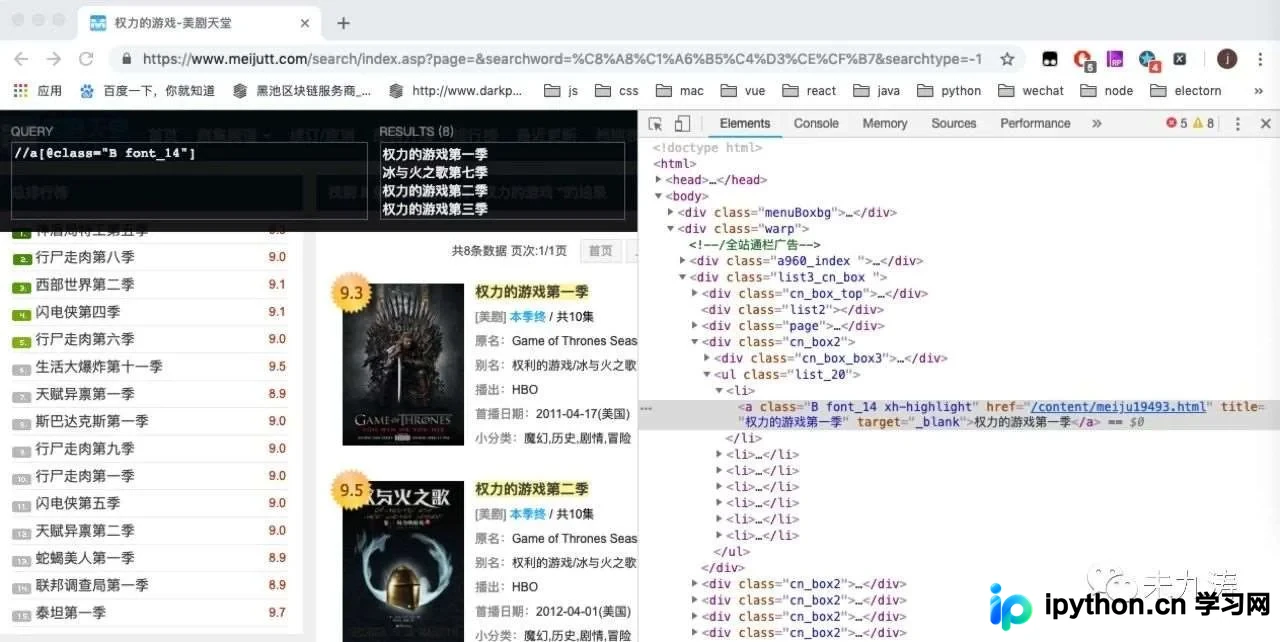
利用Chrome浏览器的XPath Helper插件对页面DOM结构进行分析,定位到包含剧集信息的class类名。
根据获取到的总页数,遍历所有页面以提取所需信息:
# 加载点击搜索页面点击的本季页面
def loadDetailPage(self, pageTotal, text, headers):
 # 取出搜索的结果一共多少页
 pageTotal = pageTotal[0].split('/')[1].rstrip("页")
 # 获取每一季的内容(剧名和链接)
 node_list = text.xpath('//a[@class="B font_14"]')
 items = {}
 items['name'] = self.textLineEdit.text()
 # 循环获取每一季的内容
 for node in node_list:
  # 获取信息
  title = node.xpath('@title')[0]
  link = node.xpath('@href')[0]
  items["title"] = title
  # 通过获取的单季链接跳转到本季的详情页面
  requestDetail = urllib.request.Request("https://www.meijutt.com" + link, headers=headers)
  htmlDetail = urllib.request.urlopen(requestDetail).read()
  textDetail = etree.HTML(htmlDetail)
  node_listDetail = textDetail.xpath('//div[@class="tabs-list current-tab"]//strong//a/@href')
  self.writeDetailPage(items, node_listDetail)
 # 爬取完毕提示
 if self.page == int(pageTotal):
  self.infoSearchDone()
 else:
  self.infoSearchContinue(pageTotal)
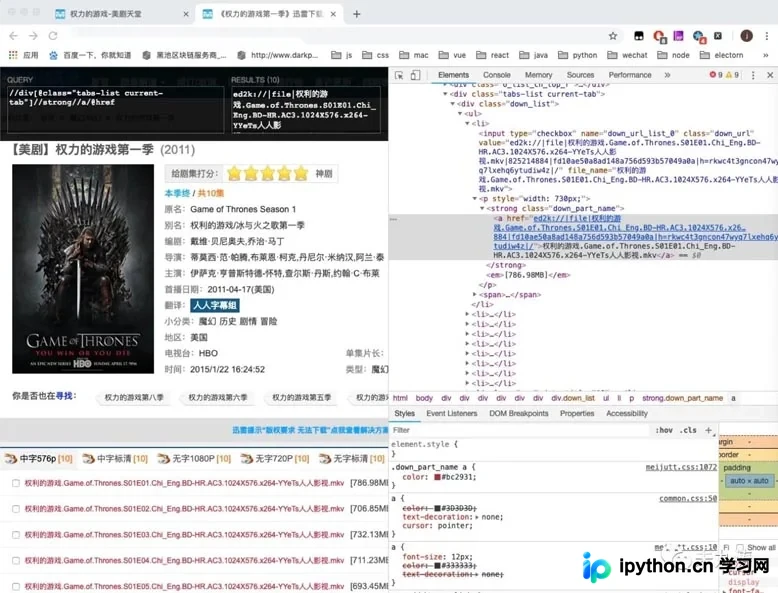
获取到具体剧集链接后,再次使用urllib库访问详情页(例如点击“权利的游戏第一季”),并通过XPath提取所需的下载链接:
图形界面开发与交互流程
至此,已成功获取所有目标美剧的下载链接,接下来重点转向图形界面的编写。
界面开发选用PyQt5框架,该框架内置QT操作语法,对初学者较为友好。代码中已添加详细注释,此处仅做简要说明。
from PyQt5.QtWidgets import QApplication, QWidget, QLineEdit, QTextEdit, QVBoxLayout, QPushButton, QMessageBox, QLabel
import sys
将抓取到的信息写入搜索结果展示区域:
# 将数据显示到图形界面
def writeDetailPage(self, items, node_listDetail):
 for index, nodeLink in enumerate(node_listDetail):
  items["link"] = nodeLink
  # 写入图形界面
  self.textEdit.append(
   "<div>"
    "<font color='black' size='3'>" + items['name'] + "</font>" + "\n"
    "<font color='red' size='3'>" + items['title'] + "</font>" + "\n"
    "<font color='orange' size='3'>第" + str(index + 1) + "集</font>" + "\n"
    "<font color='green' size='3'>下载链接:</font>" + "\n"
    "<font color='blue' size='3'>" + items['link'] + "</font>"
    "<p></p>"
   "</div>"
  )
考虑到可能存在多页数据的情况,程序需进行判断并提示剩余页数,允许用户选择继续爬取或停止,以实现人性化交互。
# 搜索不到结果的提示信息
def infoSearchNull(self):
 QMessageBox.information(
  self, '提示', '搜索结果不存在,请重新输入搜索内容',
  QMessageBox.Ok, QMessageBox.Ok
 )

# 爬取数据完毕的提示信息
def infoSearchDone(self):
 QMessageBox.information(
  self, '提示', '爬取《' + self.textLineEdit.text() + '》完毕',
  QMessageBox.Ok, QMessageBox.Ok
 )

# 多页情况下是否继续爬取的提示信息
def infoSearchContinue(self, pageTotal):
 end = QMessageBox.information(
  self, '提示', '爬取第' + str(self.page) + '页《' + self.textLineEdit.text() + '》完毕,还有' + str(int(pageTotal) - self.page) + '页,是否继续爬取',
  QMessageBox.Ok | QMessageBox.No, QMessageBox.No
 )
 if end == QMessageBox.Ok:
  self.page += 1
  self.loadSearchPage(self.textLineEdit.text(), self.page)
 else:
  pass
演示图形化软件的操作流程如下:
在搜索框中输入美剧名称并点击“确定”按钮。系统会弹出提示询问是否开始爬取,点击“No”则不执行,点击“OK”则开始爬取。
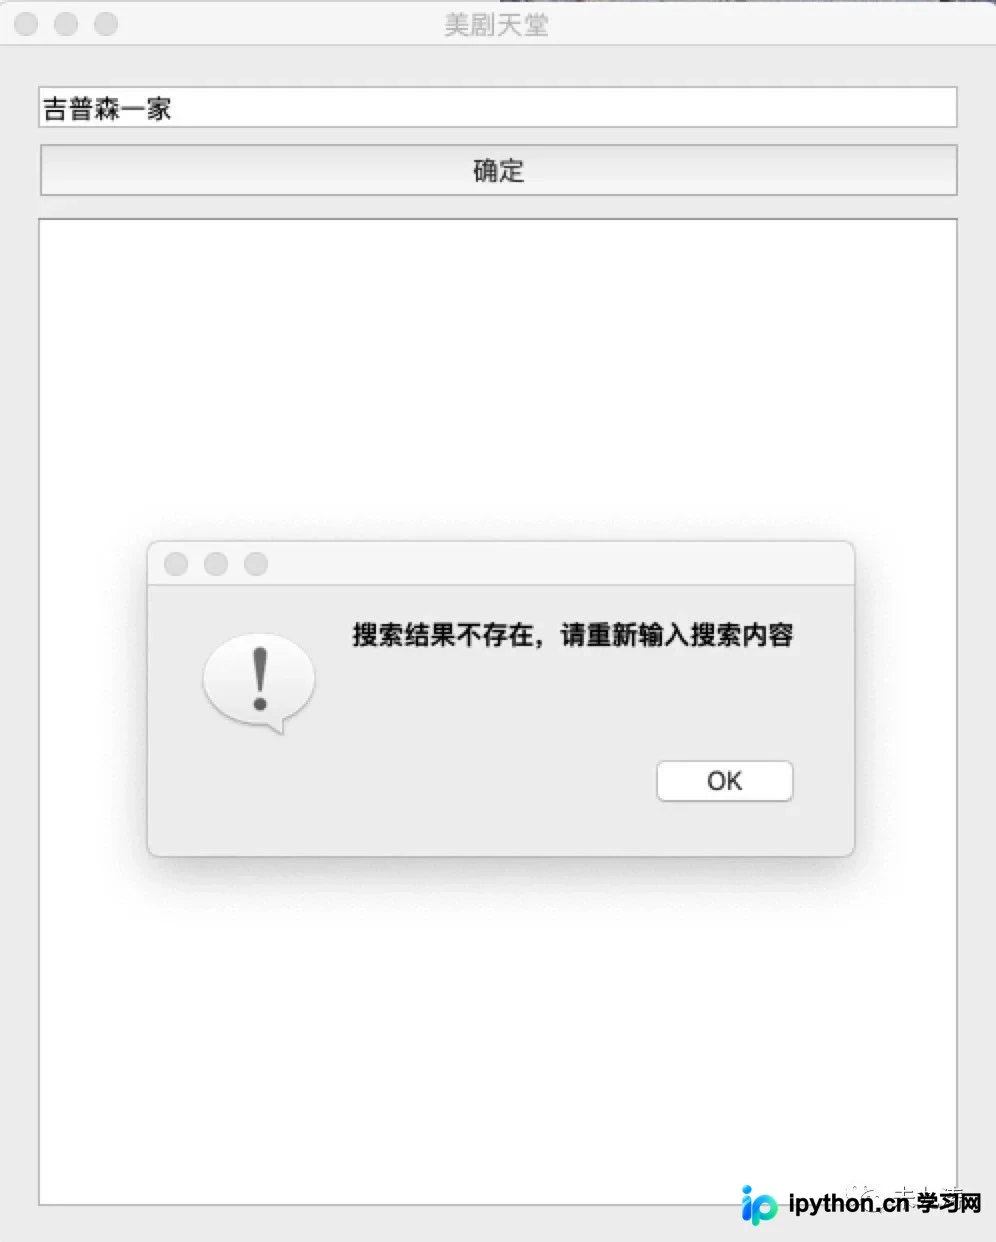
程序会判断搜索结果是否存在,例如将“辛普森一家”误输为“吉普森一家”时,系统会提示搜索内容为空。
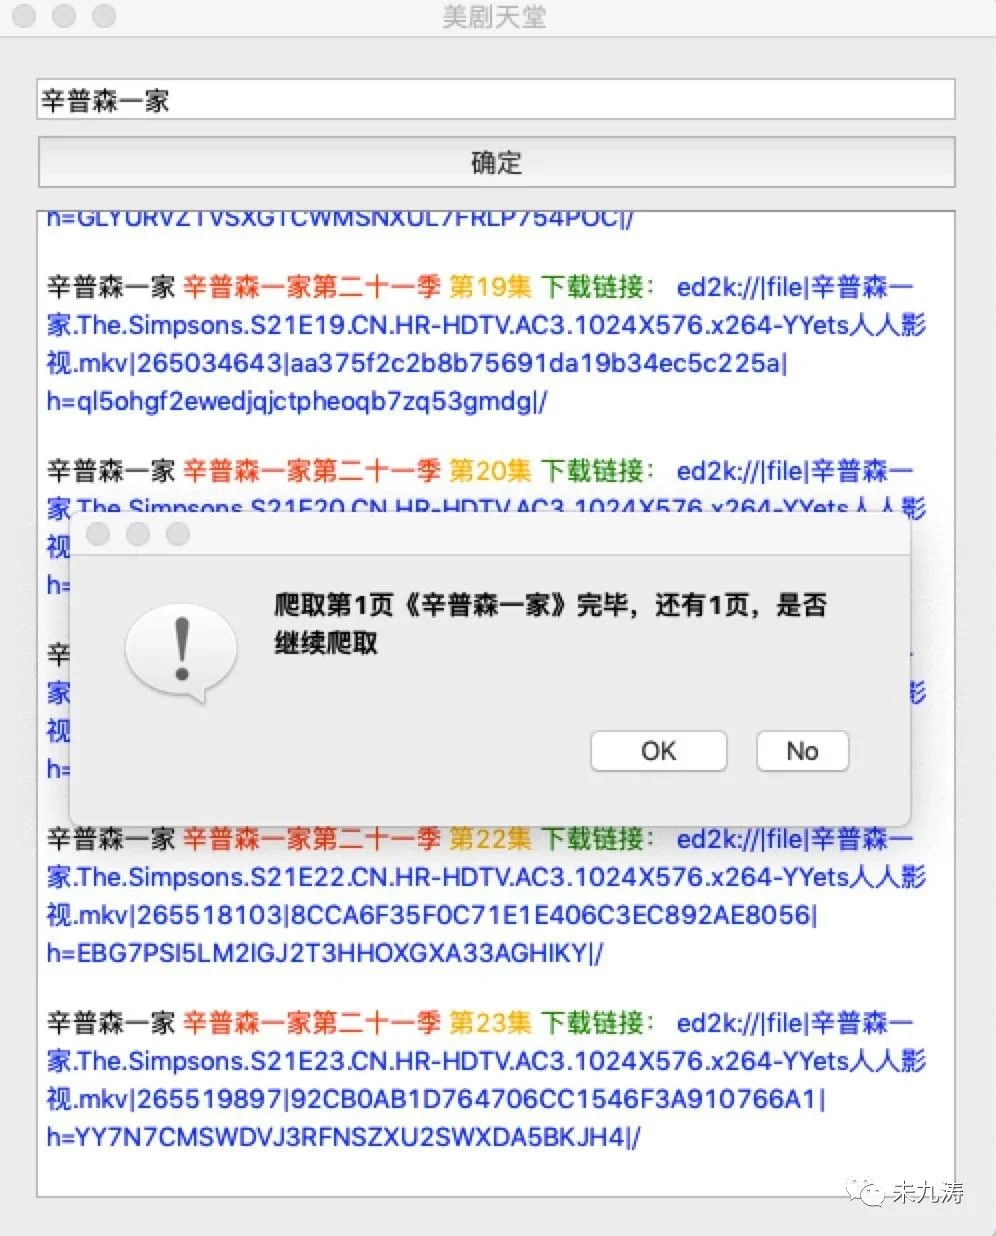
若搜索结果存在,在第一页爬取完成后,系统会提示是否继续爬取剩余页面,点击“No”表示停止,点击“OK”则继续。
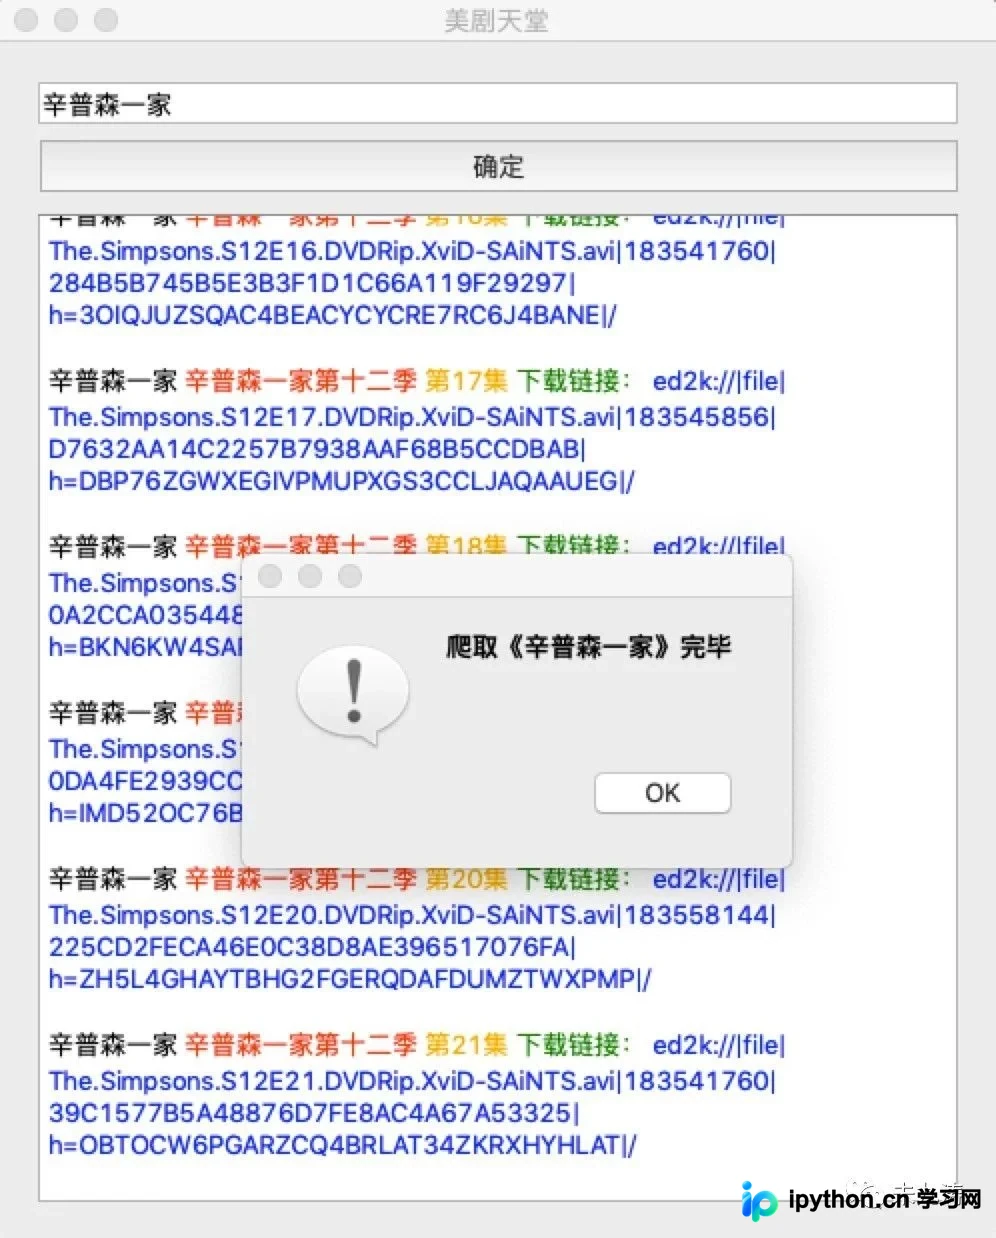
全部爬取任务完成后,系统会弹出提示告知爬取完毕:
由于个人对Python掌握程度有限,代码中必然存在诸多不足,恳请各位技术大佬批评指正,以便后续学习改进。
工具打包与使用说明
最后,本人提供了一套包含Mac和Windows版本的图形化美剧天堂抓取工具。用户只需在对应操作系统上点击运行即可使用。有需要的用户可在本人公众号后台回复“美剧天堂”获取。注:Windows版生成的.exe文件首次运行时可能被360安全卫士拦截,点击允许即可;Mac版无此提示。
以上就是本文的全部内容,希望对各位的学习有所帮助,也欢迎大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















