



在 Go 开发里,结构体到底该按值用,还是该传指针,几乎是每个项目都会遇到的判断题。真正容易出错的地方,不只是语法层面的“能不能调到方法”,而是修改语义、方法集一致性以及内存与逃逸带来的实际成本。下面就按这几个最常见的问题拆开说,并结合示例把选择标准落到可操作的层面。
结构体与接收器,先把基本语义说清楚
在 Go 语言中,结构体(struct)是把多个字段组合在一起的复合数据类型。最常见的定义方式如下:
type Person struct {
    Name string
    Age  int
}
围绕结构体定义方法时,接收器可以写成值类型,也可以写成指针类型。两者的区别,不在于写法本身,而在于方法拿到的是“副本”还是“原对象”。这也是后续所有选择的基础。
值接收器和指针接收器,差别到底在哪
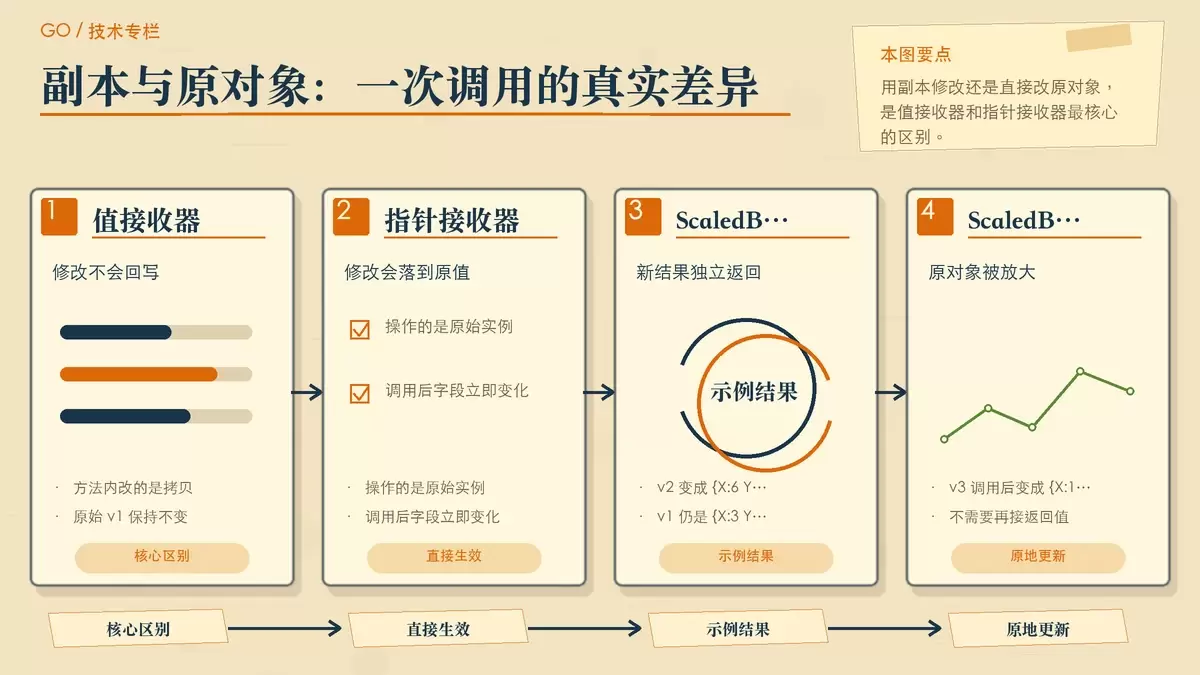
值接收器:方法拿到的是副本
func (p Person) SetName(name string) {
    p.Name = name  // 修改的是副本,原对象不变
}
这里的 p 是结构体值的一份拷贝。方法内部即使改了字段,也只会改这份副本,不会影响调用方持有的原始变量。
指针接收器:方法操作的是原始实例
func (p *Person) SetName(name string) {
    p.Name = name  // 修改的是原始对象
}
当接收器是 *Person 时,方法拿到的是结构体实例的地址。此时对字段的修改会直接落到原对象上,因此调用结束后,外部变量也会发生变化。
所以最核心的一条可以先记住:值接收器更像“拿副本来处理”,指针接收器更像“直接改原件”。
用一个例子看清调用结果为什么不同
只看定义容易停留在概念层面,放到实际代码里差异会更直观:
type Vertex struct {
    X, Y float64
}

// 值接收器方法,返回一个新的Vertex
func (v Vertex) ScaledByValue(f float64) Vertex {
    v.X = v.X * f  // 操作的是副本
    v.Y = v.Y * f
    return v  // 返回修改后的副本
}

// 指针接收器方法,直接修改原始Vertex
func (v *Vertex) ScaledByPointer(f float64) {
    v.X = v.X * f  // 直接修改原始对象
    v.Y = v.Y * f
}

func main() {
    v1 := Vertex{3, 4}
    fmt.Printf("原始 Vertex v1: %+vn", v1)  // 输出: {X:3 Y:4}

    v2 := v1.ScaledByValue(2)
    fmt.Printf("值接收器缩放后的 v2: %+vn", v2)  // 输出: {X:6 Y:8}
    fmt.Printf("原始 Vertex v1 (未改变): %+vn", v1)  // 输出: {X:3 Y:4}

    v3 := &Vertex{5, 6}
    v3.ScaledByPointer(2)
    fmt.Printf("指针接收器缩放后的 v3: %+vn", *v3)  // 输出: {X:10 Y:12}
}这个例子里,ScaledByValue 返回的是一份新的 Vertex,原来的 v1 保持不变;而 ScaledByPointer 是在原对象上直接修改,所以 v3 调用后字段值就被更新了。
这也是很多业务代码里最值得先问自己的问题:你需要的是“生成新结果”,还是“原地修改状态”?如果是前者,值接收器往往更直观;如果是后者,指针接收器才符合语义。
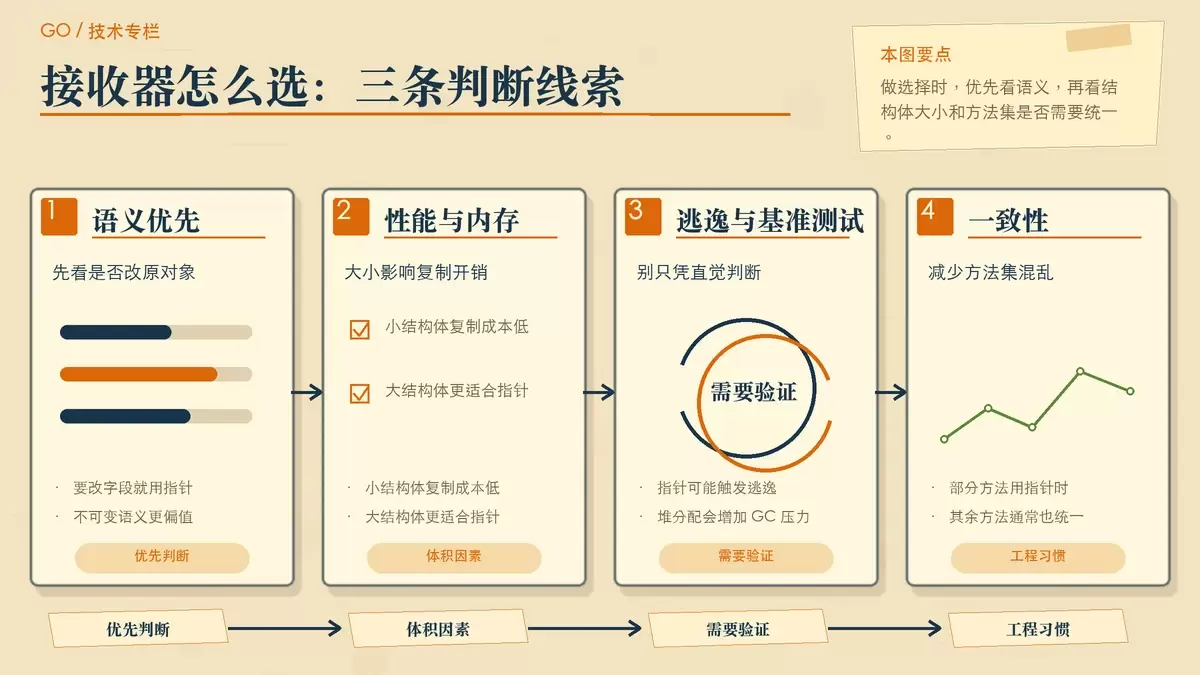
怎么选更稳妥:从语义、性能和方法集三方面判断
先看语义:方法是否必须修改原对象
这是第一优先级。只要方法需要修改结构体字段,就应该使用指针接收器。反过来,如果你希望调用方拿到的是一份独立数据,或者类型在概念上更接近不可变对象,那么值接收器通常更合适。
例如标准库里的 time.Time,就是典型的偏值语义类型。它更强调“一个时间值”本身,而不是“共享并被原地修改的对象”。
再看成本:结构体大小和逃逸行为
从直觉上看,值传递意味着复制整个结构体,指针传递只复制一个地址,因此大型结构体通常更偏向指针接收器,这样可以减少不必要的拷贝。
不过性能问题不能只看“复制大还是小”。原文提到的一个关键点值得保留:对于需要频繁分配的大型结构体,值传递在某些场景下反而可能比指针传递更快,因为指针可能导致变量逃逸到堆上,进一步增加垃圾回收压力。
也就是说,性能判断不能只靠经验口号。一般规则仍然成立:小结构体优先考虑值,大结构体优先考虑指针;但一旦进入性能敏感路径,最好结合基准测试和逃逸分析再做最终决定。
最后看一致性:同一类型的方法集尽量统一
如果一个类型的某些方法必须使用指针接收器,那么其余方法通常也应该保持为指针接收器。这样做的好处是方法集更统一,类型在接口实现和使用方式上也更少出现“这个方法能调,那个方法却不对”的认知负担。
实际工程里,这条规则常常比单次调用的便利更重要。统一的方法风格,往往能减少后期维护成本。
调用时为什么看起来都能用:Go 的语法糖帮你做了转换
很多初学者会觉得困惑:明明方法定义在指针接收器上,为什么结构体值也能直接调用?这是 Go 提供的语法糖:
var p Person

// 以下两种调用方式是等价的
p.SetName("Alice")     // 自动转换为 (&p).SetName("Alice")
(&p).SetName("Alice")  // 显式使用指针
如果方法定义在指针接收器上,而当前值是可寻址的,编译器会自动帮你取地址;反过来,如果方法定义在值接收器上,通过指针调用时,编译器也会自动解引用。
但这里需要分清一件事:调用方便,不代表语义相同。编译器帮你补了取地址或解引用,只是为了让调用更顺手;值接收器和指针接收器在“是否修改原值”“方法集如何组成”上的差异并没有消失。
哪些场景适合用值,哪些场景更该用指针
更适合值接收器的情况
- 小型结构体:字段少,复制成本低。
- 偏不可变对象:例如像
time.Time这样更强调值语义的类型。 - 需要数据隔离:希望方法处理后的结果不影响原始数据。
- 只读操作为主:方法只是计算、格式化或返回衍生结果,不承担状态修改。
更适合指针接收器的情况
- 需要修改接收器:这是最明确的使用信号。
- 大型结构体:字段多、体积大,复制代价更高。
- 包含引用类型字段:如切片、映射、通道等,通常更需要明确对象状态的共享与修改方式。
- 需要统一接口与方法集:尤其当该类型部分方法已经必须使用指针接收器时。
快速对照:日常开发里可以怎么记
| 特性 | 值接收器 | 指针接收器 |
|---|---|---|
| 修改原对象 | 否 | 是 |
| 内存使用 | 复制整个结构体 | 只复制指针 |
| 性能 | 小结构体更优 | 大结构体更优 |
| 安全性 | 高,数据隔离 | 需注意并发安全 |
| 适用场景 | 只读操作、小结构体 | 需要修改、大结构体 |
把上面的规则压缩成一句更实用的话,就是:先按语义选,再看性能,最后保持方法集一致。
如果你还拿不准,一个足够稳妥的默认原则是:需要修改原值或结构体较大时用指针;只读操作或小型结构体用值。等代码进入性能敏感区后,再用基准测试验证是否需要调整,这样通常比一开始就过度优化更可靠。















