



在 Go 项目里谈到序列化,很多团队第一反应通常是 JSON 或 Protobuf,而标准库自带的 gob 往往容易被忽略。可一旦场景限定在纯 Go 环境,尤其是服务内部通信、RPC 传参或本地持久化时,gob 其实是个很值得重新评估的选项。
这篇文章不做泛泛介绍,而是围绕几个实际问题展开:gob 到底是什么、怎么用、适合放在哪些场景,以及它为什么一直没有成为主流。看完之后,你可以更清楚地判断:自己的项目到底该继续用通用格式,还是在纯 Go 链路里把 gob 用起来。
gob 到底是什么
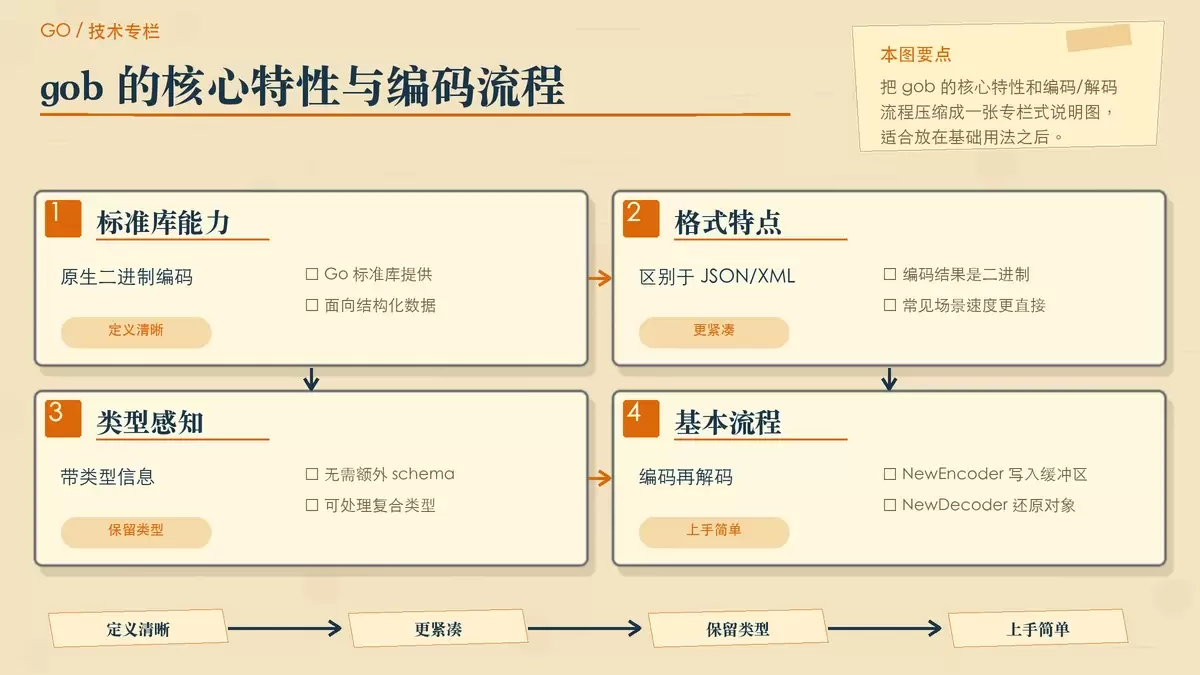
gob 是 Go 语言特有的二进制编码格式,由标准库 encoding/gob 提供支持,专门面向 Go 数据结构设计。它可以直接把结构体、切片、映射以及嵌套类型编码成二进制流,再在另一端还原回 Go 对象。
和 JSON、XML 这类文本格式相比,gob 有几个非常明确的特点:
- 它是二进制格式,通常更紧凑,编码和解码也更快。
- 它是类型感知的,能保留 Go 类型信息,不需要额外编写 schema。
- 它具备一定的自描述性,编码数据里会携带类型相关信息,便于 Go 程序之间交换。
从实现方式看,gob 依赖反射自动分析数据结构,开发者不需要手写复杂的序列化逻辑。对于大多数常见数据类型,只要调用编码器和解码器,就能完成转换。
gob 的基本用法
如果你之前用过 JSON 的编码器,gob 的用法会非常容易上手。下面先定义一个简单结构体:
type Person struct {
    Name string
    Age  int
}
序列化时,通常会先准备一个缓冲区,再把结构体写进去:
import (
    "bytes"
    "encoding/gob"
)

func serialize(p Person) ([]byte, error) {
    var buf bytes.Buffer
    encoder := gob.NewEncoder(&buf)
    err := encoder.Encode(p)
    return buf.Bytes(), err
}
反序列化同样直接,把二进制数据交给解码器即可:
func deserialize(data []byte) (Person, error) {
    var buf = bytes.NewBuffer(data)
    decoder := gob.NewDecoder(buf)
    var p Person
    err := decoder.Decode(&p)
    return p, err
}除了简单结构体,gob 还支持切片、映射和嵌套结构体等常见复合类型。不过有一个很关键的规则不能忽略:只有导出的字段,也就是首字母大写的字段,才会被序列化。未导出字段会被直接忽略,这一点和很多 Go 标准库能力的行为保持一致。
接口类型为什么要注册
当数据里包含接口类型时,gob 需要提前知道这个接口可能对应哪些具体实现,因此要显式注册具体类型。这个机制带来了灵活性,但也增加了一些使用门槛。
type Animal interface {
    Speak() string
}

type Dog struct{ Name string }
type Cat struct{ Name string }

// 必须注册才能序列化接口
func init() {
    gob.Register(Dog{})
    gob.Register(Cat{})
}
如果你的数据模型大量依赖接口、多态对象或动态分派,那么在设计序列化方案时,这个注册成本就要提前算进去。
哪些场景适合用 gob
gob 不算通用格式,但在合适的边界内,它的实用价值并不低。
Go 进程之间的数据交换
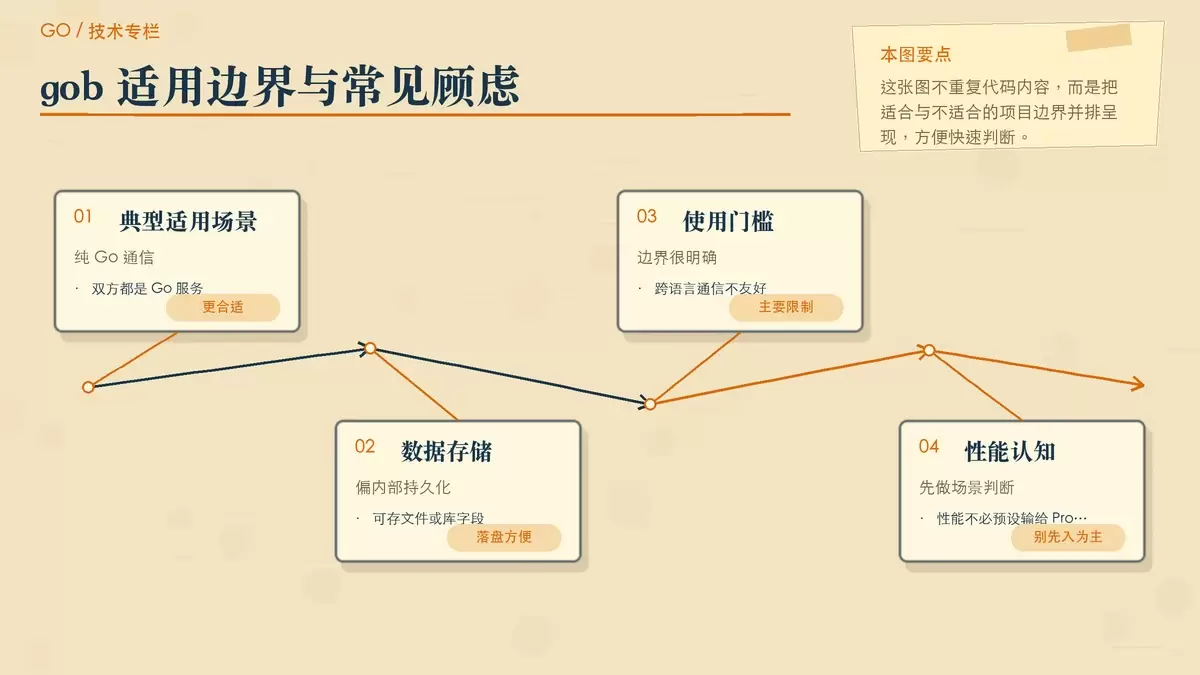
这是 gob 最自然的使用场景。服务端和客户端都运行在 Go 环境里时,gob 可以直接处理 Go 原生数据结构,省去大量格式转换工作。标准库里的 net/rpc 默认采用 gob,正说明它很适合 Go 服务之间的通信链路。
文件或数据库中的结构化持久化
如果目标是把 Go 结构体落盘,或者作为二进制字段存进数据库,gob 往往比文本格式更省空间,读写也更直接。尤其是在不需要人工阅读内容的前提下,这种紧凑编码会更有吸引力。
RPC 编码和纯 Go 性能场景
在 RPC 系统里,gob 的类型信息可以帮助调用双方更顺畅地完成数据还原。对于纯 Go 项目,如果你希望减少外部依赖,同时又希望获得比 JSON、XML 更高的编码效率,gob 通常值得纳入候选列表。
它的一个现实优势在于:很多时候你不需要引入额外 IDL、代码生成流程或第三方工具链,就能直接开始使用。这对内部系统、工具型服务或快速迭代的后端项目尤其友好。
为什么 gob 没有流行起来
既然 gob 是 Go 原生支持、用法也不复杂,为什么在社区里始终不算主流?原因主要集中在下面几个方面。
1. 语言绑定太强
gob 最大的限制,就是它基本只适合 Go 与 Go 之间使用。一旦系统需要和 Java、Python、JavaScript 等其他语言交互,gob 就几乎失去意义。
这也是它难以在多语言微服务体系中普及的根本原因。现代系统里,跨语言通信往往是常态,而不是例外。
2. 接口场景下有额外心智负担
对于简单结构体,gob 很直接;但只要涉及接口类型,就需要开发者主动注册具体实现。这个要求不算复杂,却会增加维护成本,尤其是在模型不断扩展时更明显。
3. 二进制格式不利于人工调试
和 JSON、XML 不同,gob 编码结果无法直接阅读。你不能像查看文本协议那样,随手打开文件或抓包就定位字段问题。在排查线上问题、手动修改测试数据或者做跨团队联调时,这会成为明显短板。
4. 生态和工具链存在差距
围绕 gob 的查看器、编辑器、调试工具和周边生态,远不如 JSON 或 Protobuf 成熟。它不是不能用,而是工具支持不足,让它在工程实践中少了很多“顺手”的地方。
5. 关于性能的认知常常被简化
不少开发者会默认认为 Protobuf 一定全面优于 gob,但这个判断并不总成立。尤其在纯 Go 环境中,gob 的性能往往可以和 Protobuf 接近,某些情况下甚至表现更好。
问题不在于 gob 一定更快,而在于它经常在没有进入候选名单之前就被排除了。很多团队跳过它,不是因为做过对比,而是因为默认把它归类为“冷门方案”。
怎么判断你的项目该不该用 gob
如果你的系统满足下面这些条件,gob 往往值得认真考虑:
- 通信双方都是 Go 服务;
- 数据主要用于内部传输或内部持久化;
- 不要求人类直接阅读编码结果;
- 希望减少外部依赖和额外 schema 管理成本;
- 希望比
JSON获得更紧凑、更直接的二进制编码能力。
相反,如果你的系统需要跨语言互通、公开接口兼容、稳定的外部协议约束,或者高度依赖可读性和成熟工具链,那么 JSON、Protobuf 这类方案通常会更合适。
gob 的价值,不在于替代所有序列化技术,而在于它在纯 Go 边界内提供了一个低接入成本、性能不错、表达能力也足够强的原生选择。把它放回正确的使用场景里看,它并不是“过时功能”,而是一个长期被低估的标准库能力。















