



在 Go 里,字符串比较几乎每天都会写到,但不少人第一次看到 strings.Compare() 时都会有个疑问:既然已经有 ==、<、>,标准库为什么还要再包一层?这篇文章就从 API 用法、标准库源码、字典序规则和运行时优化几部分拆开看,最后把它适合出现的场景和不该滥用的地方一次说清,让你能判断什么时候该直接写运算符,什么时候才值得用这个函数。
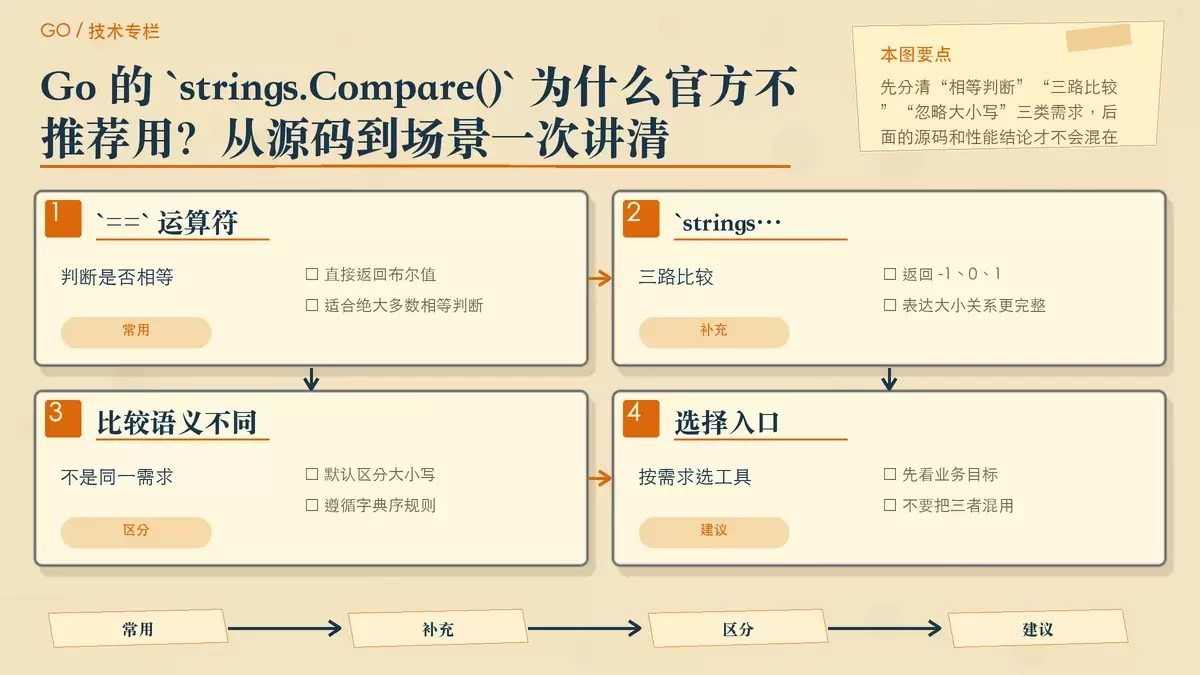
Go 字符串比较,常见的其实就这三种
在进入 strings.Compare() 的细节之前,先把 Go 中常见的字符串比较方式摆清楚:
// 方式一:使用==运算符
func Equal(s1, s2 string) bool {
    return s1 == s2
}

// 方式二:使用strings.Compare
func Compare(s1, s2 string) bool {
    return strings.Compare(s1, s2) == 0
}

// 方式三:使用strings.EqualFold(不区分大小写)
func EqualFold(s1, s2 string) bool {
    return strings.EqualFold(s1, s2)
}
这三种写法解决的问题并不完全一样。
==用于判断两个字符串是否相等,是最直接、也最常见的方式。strings.Compare()返回三路结果,适合表达“小于、等于、大于”这类关系。strings.EqualFold()用于不区分大小写的相等判断,和前两者不是同一类需求。
很多人困惑的重点也正是在这里:如果日常只关心“相不相等”,那 strings.Compare() 看起来确实有些多余。这个问题,源码里已经给了相当直接的答案。
`strings.Compare()` 到底做了什么,源码比文档更直接
strings.Compare() 的函数签名很简单:
func Compare(a, b string) int返回值规则也很明确:
- 返回 0 表示
a == b - 返回 -1 表示
a < b - 返回 1 表示
a > b
看一个最基本的例子:
func main() {
    fmt.Println(strings.Compare("apple", "banana"))  // -1
    fmt.Println(strings.Compare("banana", "apple"))  // 1
    fmt.Println(strings.Compare("apple", "apple"))   // 0
    fmt.Println(strings.Compare("Go", "go"))         // -1 (区分大小写)
}
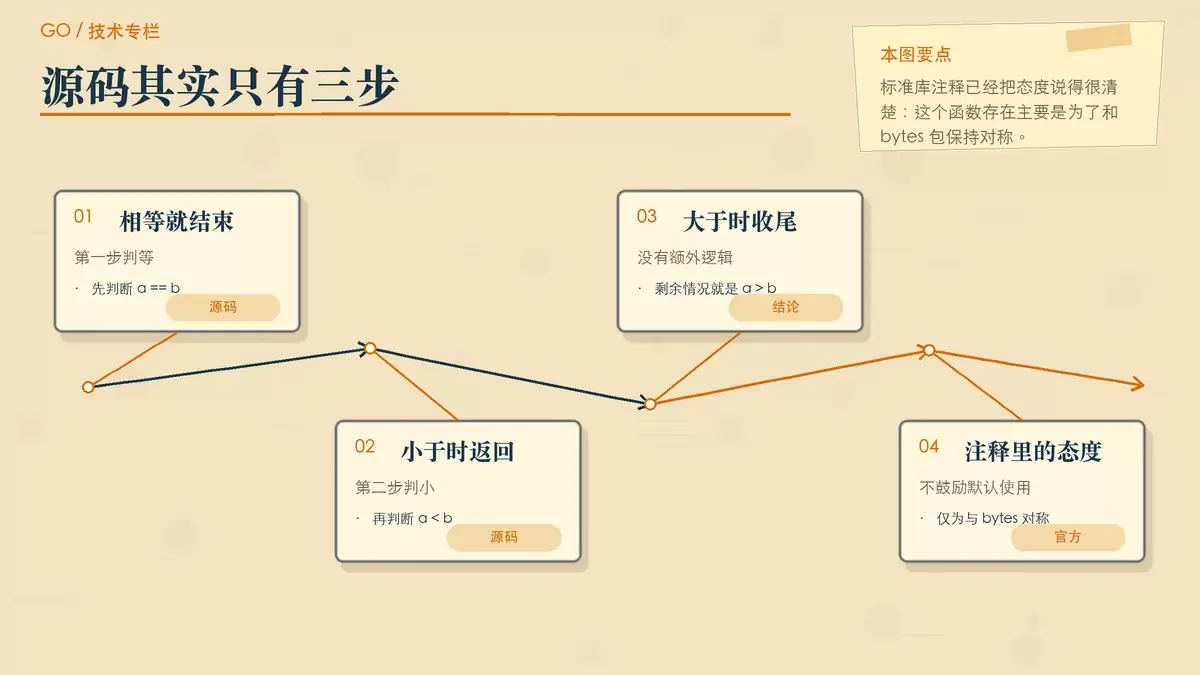
真正关键的是它在标准库中的实现:
// Compare returns an integer comparing two strings lexicographically.
// The result will be 0 if a==b, -1 if a < b, and +1 if a > b.
//
// Compare is included only for symmetry with package bytes.
// It is usually clearer and always faster to use the built-in
// string comparison operators ==, <, >, and so on.
func Compare(a, b string) int {
    if a == b {
        return 0
    }
    if a < b {
        return -1
    }
    return +1
}这段代码基本把结论写透了:strings.Compare() 并没有额外的底层黑魔法,它只是把内置比较运算符重新包装成一个返回 int 的函数。
为什么官方不推荐它
函数注释里有两句最重要的话:
Compare is included only for symmetry with package bytes.It is usually clearer and always faster to use the built-in string comparison operators ==, <, >, and so on.
第一句的意思是,这个函数存在,很大程度上只是为了和 bytes.Compare 保持接口层面的对称;第二句则更直接,标准库明确告诉你:对于字符串,直接使用内置比较运算符通常更清晰,而且总是更快。
也就是说,strings.Compare() 不是“更底层”的能力,恰恰相反,它只是内置比较的一层封装。把这一点看明白,后面关于性能和使用场景的判断就会容易很多。
Go 如何比较字符串:核心是基于 Unicode 码点的字典序
无论你写的是 ==、<、>,还是 strings.Compare(),底层遵循的都是同一套字典序规则。
可以把它概括成下面几点:
- 从左到右逐个字符比较。
- 比较依据是字符的 Unicode 码点值。
- 一旦某一位字符分出大小,整个字符串大小关系就确定了。
- 如果前面所有字符都相同,长度更短的字符串更小。
- 两个空字符串相等。
先看字符层面的比较:
// Unicode码点比较示例
fmt.Println('A' < 'B')   // true,因为A的Unicode码点是65,B是66
fmt.Println('a' < 'b')   // true,因为a的Unicode码点是97,b是98
fmt.Println('A' < 'a')   // true,因为65 < 97

// 字符串比较示例
fmt.Println("Apple" < "Banana")  // true,因为'A'(65) < 'B'(66)
fmt.Println("apple" < "banana")  // true,因为'a'(97) < 'b'(98)
fmt.Println("Go" < "go")         // true,因为'G'(71) < 'g'(103)
这也是为什么 strings.Compare("Go", "go") 会返回 -1:它是区分大小写的,而且比较基础不是“字母表上的视觉顺序”,而是 Unicode 码点顺序。
这里顺带能解释一个常见误区:strings.Compare() 并不会帮你做“更智能”的自然语言比较,它和运算符一样,仍然是严格的字典序。想做不区分大小写,或者更复杂的本地化排序,需要换工具,而不是指望这个函数本身带来不同语义。
为什么 `==` 往往更合适:可读性之外,还有运行时优化
既然 strings.Compare() 最终还是调用了内置比较,那它为什么还会比运算符慢?原因并不复杂:函数调用本身就有额外成本,而运算符路径更直接,也更容易被编译器优化。
原文给出的性能测试项目如下:
BenchmarkStrEqual-8          // 测试 == 运算符
BenchmarkStrCompare-8        // 测试 strings.Compare
BenchmarkStrEqualFold-8 // 测试 strings.EqualFold测试结论是:== 运算符性能最高。这个结果和标准库注释里的 “always faster” 是一致的。
字符串相等判断在运行时如何优化
Go 在处理字符串相等比较时,并不是一上来就逐字节硬比。它会先做一些很便宜的判断,比如长度是否相同、底层数据指针是否一致。
// 伪代码展示运行时优化
func runtime.eqstring(s1, s2 string) bool {
    if len(s1) != len(s2) {
        return false
    }
    if s1.data == s2.data && len(s1) == len(s2) {
        return true  // 相同底层数据
    }
    return memequal(s1.data, s2.data, len(s1))
}
这段伪代码表达的是两个关键信号:
- 如果长度不同,立即返回
false,无需继续比较。 - 如果底层数据指针相同且长度相同,可以直接判定相等。
只有在长度相同、但底层数据不是同一块时,才会进入更底层的字节比较逻辑。
长字符串比较为什么也能保持较高效率
对于底层数据不同但长度一致的字符串,Go 会走优化过的字节比较路径。原文提到这一步可能利用特定 CPU 架构的向量指令,因此即使字符串较长,性能通常也不会太差。
这也是为什么,在只需要判断是否相等的业务代码里,s1 == s2 本身已经是语言层面和运行时层面都很成熟的选择。再套一层 strings.Compare(s1, s2) == 0,并不能获得更好的可读性,反而多了一次函数调用和一次语义转换。
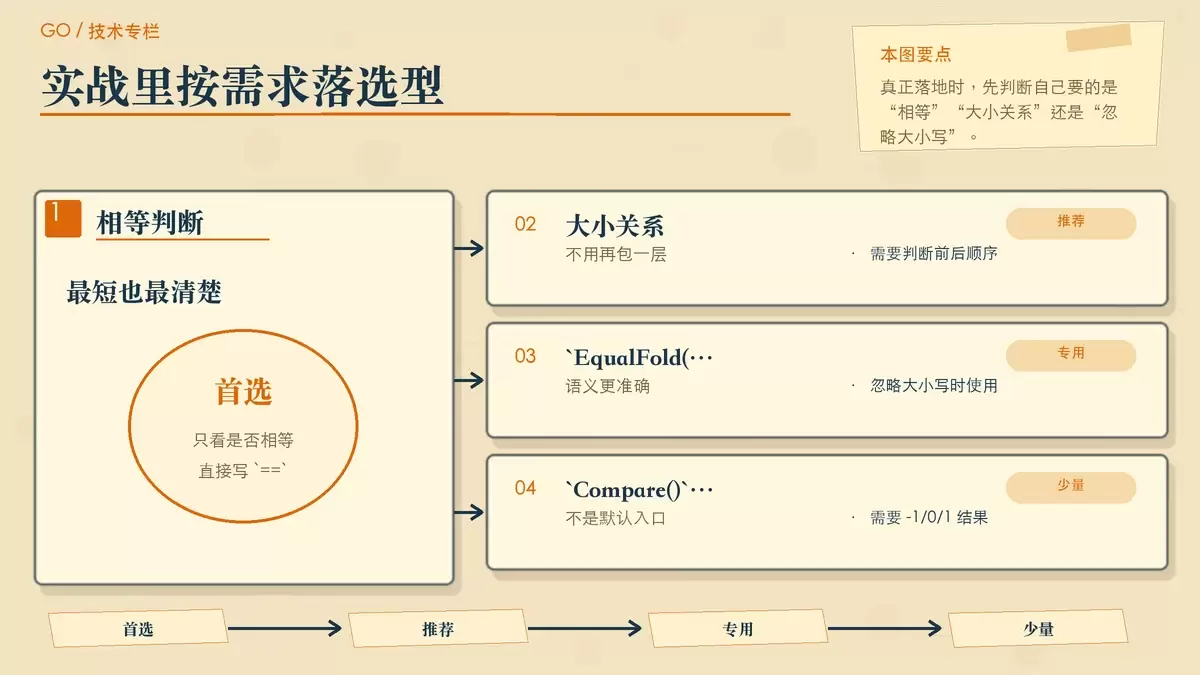
什么时候还能用 `strings.Compare()`,什么时候该换成 `EqualFold()`
说官方不推荐,不代表这个函数完全没用。更准确的说法是:它不是字符串比较的默认入口,只在少数明确需要“三路结果”的地方才比较顺手。
适合使用 `strings.Compare()` 的场景
第一类是你确实需要一个 -1 / 0 / 1 风格的三路比较结果,而不是只判断真或假。
// 比较版本号
func CompareVersions(v1, v2 string) int {
    return strings.Compare(v1, v2)
}

// 在排序算法中使用
func SortStrings(strings []string) {
    sort.Slice(strings, func(i, j int) bool {
        return strings.Compare(strings[i], strings[j]) < 0
    })
}
第二类是代码同时处理字符串和字节切片,希望接口形式保持一致:
// 对称处理字符串和字节切片
strResult := strings.Compare(str1, str2)
byteResult := bytes.Compare(byte1, byte2)
第三类是你要把比较逻辑抽象成函数参数,交给排序器或其他通用逻辑:
// 为字符串切片实现自定义排序
func SortWithCustomRule(strings []string, compareFunc func(a, b string) int) {
    sort.Slice(strings, func(i, j int) bool {
        return compareFunc(strings[i], strings[j]) < 0
    })
}
即便如此,也要看具体代码是否真的更清楚。如果一个地方只是简单判断大小,直接写 <、> 往往更直观。
不区分大小写时,不该再看 `Compare()`
实际开发里更常见的另一个需求,是大小写不敏感比较。这个需求和三路比较是两回事,应该使用 strings.EqualFold()。
// 区分大小写比较
fmt.Println(strings.Compare("Go", "go"))  // -1 (区分大小写)
fmt.Println("Go" == "go")                // false

// 不区分大小写比较
fmt.Println(strings.EqualFold("Go", "go"))  // true
strings.EqualFold() 使用的是 Unicode 大小写折叠(case-folding)规则,能处理的不只是简单的 ASCII 大小写转换,还覆盖一些特殊语言场景。原文提到的德语 ß 与 SS,就是典型例子。
这也是为什么下面这种写法虽然常见,但并不理想:
if strings.ToLower(s1) == strings.ToLower(s2) {
    // 处理不区分大小写的相等情况
}
它不仅会多做一次字符串转换,性能更差,语义上也不如 EqualFold 直接。
落到实战,字符串比较可以按这套规则选
把前面的结论收束到日常编码里,其实选择并不复杂。
只判断相等:优先用 `==`
// 推荐
if s1 == s2 {
    // 处理相等情况
}

// 不推荐
if strings.Compare(s1, s2) == 0 {
    // 处理相等情况
}这一类场景里,== 既更短,也更符合 Go 的日常阅读习惯。
需要判断大小:直接用 `<`、`>`
// 推荐
if s1 < s2 {
    // 处理s1小于s2的情况
} else if s1 > s2 {
    // 处理s1大于s2的情况
} else {
    // 处理相等情况
}

// 不推荐
result := strings.Compare(s1, s2)
if result < 0 {
    // 处理s1小于s2的情况
} else if result > 0 {
    // 处理s1大于s2的情况
} else {
    // 处理相等情况
}
除非上下文强依赖“三路比较返回值”这一接口形式,否则运算符表达更自然。
需要忽略大小写:用 `strings.EqualFold()`
// 推荐
if strings.EqualFold(s1, s2) {
    // 处理不区分大小写的相等情况
}

// 不推荐(性能较差)
if strings.ToLower(s1) == strings.ToLower(s2) {
    // 处理不区分大小写的相等情况
}
这个选择背后的原则也很简单:比较需求是什么,就用最贴近语义的工具。Go 标准库已经把这三类需求分得很清楚,没有必要把所有场景都塞进 strings.Compare()。
最后再把本文的核心结论压缩成一句话:strings.Compare() 能用,但它不是 Go 字符串比较的首选入口。 如果你只是判断是否相等,用 ==;如果要比较大小,直接用 < 和 >;如果要忽略大小写,用 strings.EqualFold()。只有在你明确需要三路结果,或者想和 bytes.Compare 保持接口对称时,strings.Compare() 才算用得其所。















