


Python自动化测试:数据驱动架构实现脚本复用与高效维护

本文深入解析Python自动化测试中的数据驱动思想,通过将测试数据与执行脚本分离,显著提升代码复用率与维护效率。通过封装openpyxl类实现Excel数据的读取与结果写入,展示如何以单一脚本循环执行多条测试用例,确保测试数据的完整性与准确性,适用于登录等常见场景的批量自动化验证。
数据驱动思想概述
前言
数据驱动是一种核心设计思想,旨在实现数据逻辑与代码逻辑的解耦。以爬虫场景为例,当需要分页抓取数据时,通常将页码参数化并置于 for 循环的 range 函数中。若缺乏此类内置序列生成机制,开发者不得不手动逐个添加参数,这不仅繁琐且易错。
在实际业务场景中,此类问题屡见不鲜。例如,在爬取上海各区房租数据时,为简化操作,曾将地区拼音全称直接存入列表以拼接房源链接。后续有读者指出遗漏了徐汇区的数据。即便数据量较小,手动管理仍易出现疏漏;面对海量数据时,如何确保数据的完整性与准确性成为关键。因此,将数据独立存储于特定文件(如 Excel)中显得尤为重要。
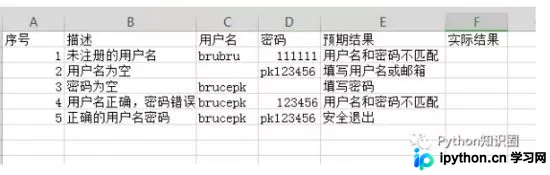
以下通过一个典型示例说明:登录流程的自动化测试。除了验证登录成功的场景外,测试工作还需覆盖各种登录异常的边界情况。
列举几条常见的测试用例如下:
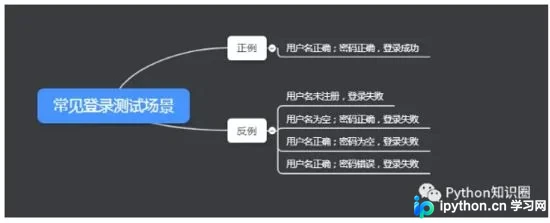
假设上述包含 5 条测试用例,若数据与脚本未分离,则需编写 5 个独立的自动化测试脚本。
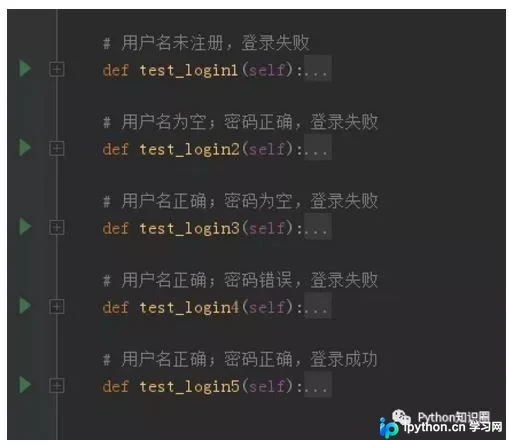
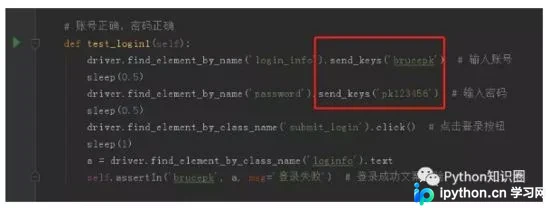
在这 5 条用例中,核心脚本逻辑完全一致,唯一区别在于输入框中填入的数据不同。
数据分离与Excel封装实现
数据分离策略
我们可以将测试数据统一存储于 Excel 表格中,通过编写循环读取 Excel 数据,实现单条脚本执行多条测试用例的目标。
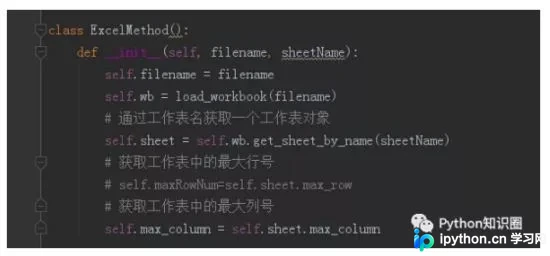
首先,需封装一个用于操作 Excel 文件的类,并安装导入 openpyxl 库。
利用该库可实现两项核心功能:读取表格数据以及保存执行结果。
在类中首先定义打开 Excel 文件的初始化方法(构造方法)。其作用是当类被实例化时,立即调用该方法以建立文件连接。
数据读取方法
读取表格数据
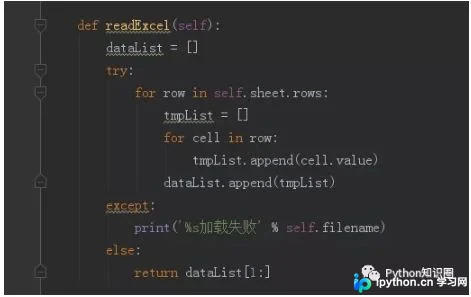
接着编写读取 Excel 数据的方法。该方法读取数据后返回数据列表,供后续调用以获取对应数据。由于第 1 列为序号,方法直接返回第 2 列及之后的有效数据。
结果保存机制
保存执行结果
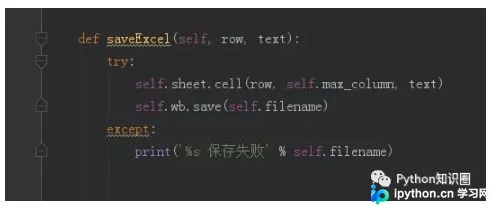
在实际操作中,对比实际结果与预期结果后,需标记执行状态为 pass 或 fail,并将结果保存至对应的单元格中。
查看我们的案例格式:
通过这种方式,脚本无需编写 5 条独立代码,只需调用 Excel 文件中的数据并循环执行即可。这不仅使逻辑更加清晰,也极大便利了后期的维护工作。
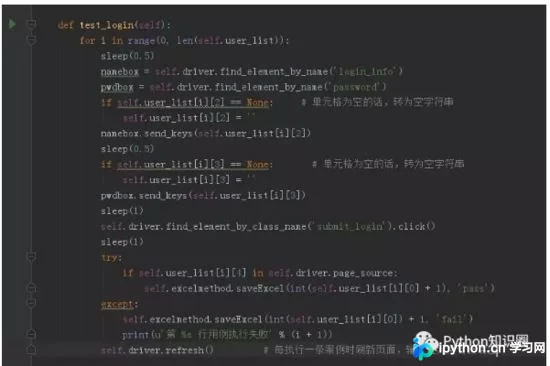
实现测试数据与脚本分离后,不同的测试数据集可分别保存于不同的 Excel 文件中。
利用这一机制,可在用餐期间或下班后自动执行测试脚本,待用餐结束或次日上班时,直接查看 Excel 中的执行结果。若出现 fail 状态,再手动排查是否可复现,这种工作流显著提升了测试效率。
效率提升与总结
总结
以上介绍了 Python 自动化测试中数据驱动模式的应用,旨在通过数据与脚本的分离,使脚本结构简洁度提升约 10 倍,希望对读者有所帮助。如有任何疑问,欢迎留言,小编会及时回复。感谢大家对本站的支持! 若本文对您有帮助,欢迎转载,请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















