



很多 Go 开发者都会把一个问题问到最后一步:执行 go build 之后,编译器到底交出了什么,汇编代码还是机器码?这个问题表面像在分辨名词,实际牵涉到 Go 编译器如何组织中间表示、怎样做平台适配,以及为什么它能同时兼顾部署简单和运行效率。下面就按编译链路一步步拆开,从源代码、SSA、Plan 9 汇编一直讲到最终可执行文件,顺带说明哪些产物只是中间形态,哪些才是最终结果。
Go 编译后的最终产物到底是什么
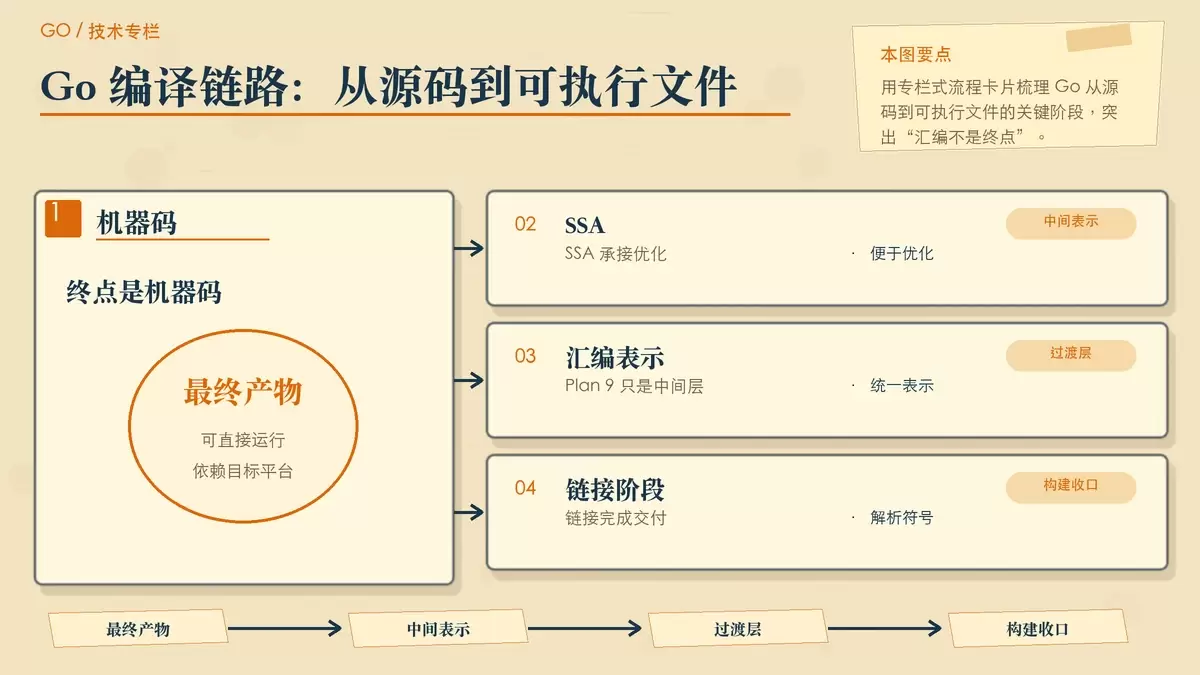
先给结论:Go 语言编译的最终产物是机器码,不是汇编代码。
更准确一点说,汇编代码只是编译流程中的中间表示。go build 的目标,是生成能够在指定操作系统和 CPU 架构上直接运行的二进制文件;这个文件内部承载的是目标平台可执行的机器指令,而不是给人阅读的汇编文本。
把整条路径压缩成一句话,大致可以写成:
Go 源代码 → 标记流 → 抽象语法树 → SSA 中间表示 → Plan 9 汇编表示 → 目标机器码 → 链接后的可执行文件
因此,如果问题是“Go 编译过程中会不会产生汇编”,答案是会;如果问题是“Go 编译完成后最终输出的是什么”,答案则是机器码。
为什么 Go 不会停在汇编阶段
要理解这一点,先得区分几种常见的语言执行路径。
像 Python、JavaScript 这类解释型语言,通常依赖运行时环境去解释执行代码;而 C、C++、Go 这类编译型语言,则会在运行前先把源代码转换成可执行形式。
编译型语言内部也并不完全一样。比如 Java 常见路径是先生成字节码,再交给虚拟机执行;Go 走的是另一条路线,它会把程序完整编译到目标平台相关的本地代码中。
这也是 Go 被称为静态编译型语言的关键含义:程序运行前,编译器已经把大部分工作做完,最终交付的是一个可直接运行的二进制文件。它通常不依赖额外虚拟机,部署时也不要求再解释源码。
这种设计带来了两类直接影响。
性能收益来自提前完成分析和优化
因为编译器在构建阶段就能拿到完整程序信息,它可以提前做类型检查、内联、常量折叠、死代码消除等优化。这样一来,程序运行时不需要承担解释执行的额外开销,执行效率更高。
产物天然带有平台属性
代价也很明确:机器码依赖目标 CPU 指令集和操作系统约定。给一种架构编出来的程序,通常不能直接拿到另一种架构上运行。
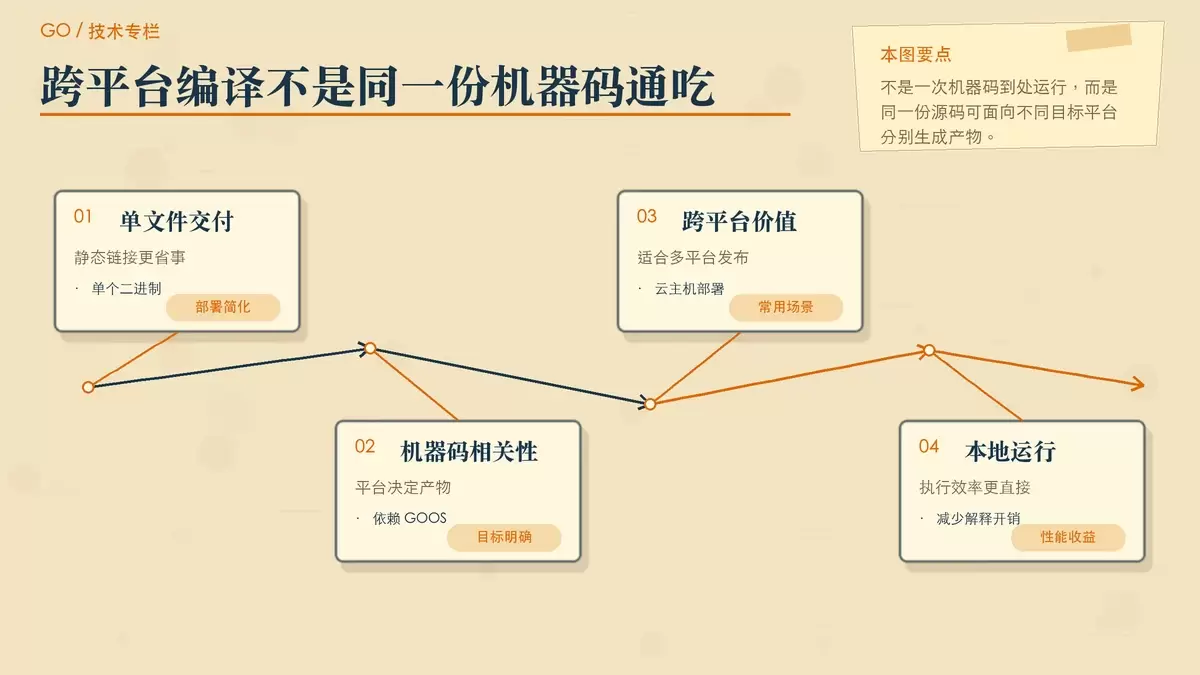
这就是为什么 Go 虽然编译速度快、跨平台支持强,但跨平台的本质并不是“一次编译到处运行”,而是“可以方便地为不同平台分别生成机器码”。
Go 编译过程的 6 个关键阶段
Go 从源码到可执行文件,中间大致会经历 6 个主要阶段。理解这些阶段后,“机器码还是汇编代码”这个问题基本就不会再混淆。
1. 词法分析:把源码切成标记
第一步是词法分析,也叫扫描。编译器会逐字符读取源代码,把它拆成一个个最小语法单元,也就是标记(tokens)。
这些标记包括关键字、标识符、字面量、运算符和括号等;空白字符与注释通常不会进入后续逻辑判断,因为它们不影响程序语义。
例如代码 a := b + c(12),会被识别成标识符 a、运算符 :=、标识符 b、运算符 +、标识符 c、括号 (、数字 12 和括号 ) 等标记。
2. 语法分析:把标记组织成 AST
有了标记流之后,编译器会按 Go 语言语法规则,把这些标记组织成树形结构,也就是抽象语法树(AST)。
AST 保留的是代码的语法骨架:哪些是声明,哪些是表达式,哪些是语句,以及它们之间如何嵌套。它不追求保留全部书写细节,但会准确描述程序结构。
Go 使用递归下降分析法构建 AST。这个阶段如果发现语法不合法,例如括号不匹配、语句结构错误,编译器就会直接报错,流程也不会继续。
3. 语义分析:检查类型、作用域和调用是否合法
语法正确不代表程序语义正确。进入语义分析后,编译器会继续检查 AST 中的含义是否成立。
这里最核心的是类型检查。Go 是静态类型语言,所以编译器要确认变量赋值是否匹配、函数参数是否正确、返回值是否符合声明、表达式能否成立。
除了类型检查,语义分析还会处理作用域与标识符解析,确保变量、函数、包级符号都在合法位置被引用。很多开发者日常看到的“未定义”“类型不匹配”这类错误,主要就来自这个阶段。
4. 中间表示与优化:进入 SSA
语义分析通过后,编译器不会立刻输出机器码,而是先把程序转换成更适合优化和生成代码的中间表示,其中一个关键形式就是 SSA,也就是静态单赋值形式。
SSA 的特点是每个变量只赋值一次,这会让数据流更清晰,编译器也更容易判断哪些值可传播、哪些计算可消除、哪些分支可简化。
在这一阶段,Go 编译器会做多种优化,例如:
- 死代码消除
- 常量折叠
- 函数内联
- 去虚拟化
这些优化不会改变程序语义,但会直接影响最后生成机器码的体积、性能和执行路径。
5. 汇编表示生成:先到 Plan 9 汇编
优化后的 SSA 还不是最终可执行指令,接下来它会被进一步转换为汇编层面的表示。
Go 在这里有一个比较特殊的历史选择:它不会一开始就直接吐出某个平台原生汇编文本,而是先进入一种与 Go 工具链紧密相关的 Plan 9 汇编 表示。
这类表示的意义,在于把部分平台差异先收敛起来,让编译器内部有一套更统一的汇编接口。它方便 Go 工具链在不同系统、不同架构之间保持相对一致的处理方式。
但这里必须强调一次:Plan 9 汇编不是最终机器指令。它仍然只是中间层,后面还要经过汇编和链接,才能变成真正可运行的二进制产物。
6. 机器码生成与链接:形成最终可执行文件
到了最后阶段,汇编器会把前面的汇编表示转换成目标平台机器码,生成目标文件;随后链接器再把多个目标文件及所需依赖组织起来,解决符号引用,产出最终的可执行文件。
链接器处理的问题很实际:一个文件里调用了另一个文件中的函数,这些调用点最终要指向真实地址;标准库、包依赖和运行时需要被正确并入;程序入口也要被设置好。完成这些工作后,Go 程序才真正成为一个能在目标平台上启动的二进制。
所以从编译器流程角度看,汇编代码是中途站,机器码才是终点站。
这套设计给 Go 带来了什么实际优势
Go 之所以在工程实践里很受欢迎,很大程度上就来自这条“直接面向机器码”的编译路径。
静态链接让部署更直接
Go 默认倾向于生成静态链接的可执行文件,把程序运行所需的大部分内容一并打进单个二进制中。这样部署时通常不需要额外解释器或虚拟机,分发和运维都更省事。
这也是很多团队喜欢用 Go 写基础设施、命令行工具和服务端程序的原因之一:交付形式简单,环境依赖少,落地成本可控。
跨平台能力强,但本质仍是分别生成目标机器码
Go 的跨平台能力经常被提到,但要说清楚,它不是像字节码那样在统一虚拟机上运行,而是工具链帮你为目标平台重新编译。
最常见的做法,就是通过 GOOS 和 GOARCH 指定目标系统与架构:
GOOS=linux GOARCH=arm64 go build -o myapp_linux_arm64这条命令的意义很明确:即使你当前在别的平台开发,也可以直接为 linux 上的 arm64 目标生成对应的机器码产物。
编译速度和运行性能之间做了平衡
Go 编译器一直强调编译速度。它被设计成偏单遍、强调快速反馈的工具链,因此大型项目通常也能在较短时间内完成构建。
与此同时,它并没有为了速度完全放弃优化。像内联、逃逸分析等机制,仍然会在关键位置提升运行时表现。这也是 Go 在开发效率和执行性能之间能保持不错平衡的原因。
想看 Go 编译过程,可以用哪些方法
如果你不满足于只知道结论,还想亲眼看看中间产物,Go 工具链本身就提供了几种常用入口。
用 -x 查看构建时执行的命令
-x 会把编译过程中调用的命令打印出来,适合先了解整个构建链路都做了哪些事。
用 -gcflags -S 查看汇编输出
如果你的目标是观察编译器生成的汇编层内容,可以直接执行:
go build -gcflags -S main.go这会输出对应的汇编信息。这里看到的是编译过程中的低层表示,能帮助你分析函数调用、栈布局、寄存器相关处理,但它并不等于最终可执行文件本身就是“汇编代码”。
用 GOSSAFUNC 观察 SSA 过程
如果你更关心优化发生在什么阶段、SSA 是如何变化的,可以设置 GOSSAFUNC:
GOSSAFUNC=main go build这个命令会为指定函数生成 SSA HTML 文件,展示从初始中间表示到后续优化和代码生成的过程。对于理解编译器如何把高级语言结构逐步压低到机器相关表示,这个入口很有价值。
结论:最终是机器码,汇编只是中间层
回到最初的问题,答案已经可以非常明确:Go 编译后的最终产物是机器码,汇编代码只是中间步骤之一。
从源码开始,Go 先做词法分析、语法分析和语义检查,再进入 SSA 优化阶段,然后生成 Plan 9 汇编表示,最后经过汇编和链接,得到能在目标平台直接运行的二进制文件。
理解这条路径的意义,不只是为了回答一个概念题。它还会直接影响你对跨平台编译、性能优化、静态链接以及调试手段的判断。以后再看到 go build,就可以把它理解成一条完整的“源码到机器码”流水线,而不是简单地“把 Go 代码变成汇编”。















