


Python3网络爬虫requests库高级用法实战指南

本文深入解析Python3中requests库的高级功能,涵盖文件上传、Cookies管理与会话维持、SSL证书验证与忽略、代理设置(含SOCKS)、超时控制、身份认证及Prepared Request等核心用法。通过具体代码实例,帮助开发者掌握高效、稳定的网络请求技巧,适用于复杂爬虫场景。
Requests高级用法概述
本节继续探讨Requests库的高级应用,重点介绍文件上传、代理配置、Cookies管理等功能,帮助开发者应对更复杂的网络请求场景。
文件上传实现
1. 文件上传
Requests库不仅能模拟表单提交,还能轻松处理文件上传。实现过程直观简洁,具体示例如下:
import requests
files = {'file': open('favicon.ico', 'rb')}
r = requests.post('http://httpbin.org/post', files=files)
print(r.text)
以上一章节下载的favicon.ico文件为例进行上传演示。请注意,该文件需与当前执行的脚本位于同一目录。若需上传其他文件,只需修改文件名即可。
执行上述代码后,
{
 "args": {},
 "data": "",
 "files": {
  "file": "data:application/octet-stream;base64,AAAAAA...="
 },
 "form": {},
 "headers": {
  "Accept": "*/*",
  "Accept-Encoding": "gzip, deflate",
  "Content-Length": "6665",
  "Content-Type": "multipart/form-data; boundary=809f80b1a2974132b133ade1a8e8e058",
  "Host": "httpbin.org",
  "User-Agent": "python-requests/2.10.0"
 },
 "json": null,
 "origin": "60.207.237.16",
 "url": "http://httpbin.org/post"
}
返回的响应对象中包含files字段,而form字段为空,这表明文件上传部分由独立的files字段进行标识,与表单数据分离。
Cookies管理与会话维持
2. Cookies
此前使用Urllib处理Cookies时代码较为繁琐,而Requests库简化了这一过程,获取和设置Cookies仅需一步操作。
首先通过一个实例展示如何获取Cookies:
import requests
r = requests.get('https://www.baidu.com')
print(r.cookies)
for key, value in r.cookies.items():
  print(key + '=' + value)
运行结果如下:
‘'‘
<RequestsCookieJar[<Cookie BDORZ=27315 for .baidu.com/>]>
BDORZ=27315
'‘'
通过调用cookies属性即可获取Cookies,其类型为RequestsCookieJar。利用items()方法可将其转换为包含元组的列表,进而遍历输出每个Cookie的名称和值,实现Cookies的解析与遍历。
此外,Cookies还可用于维持登录状态。
以知乎网站为例,直接利用Cookies即可保持登录状态。
首先登录知乎,复制Headers中的Cookies内容,如图3-6所示:
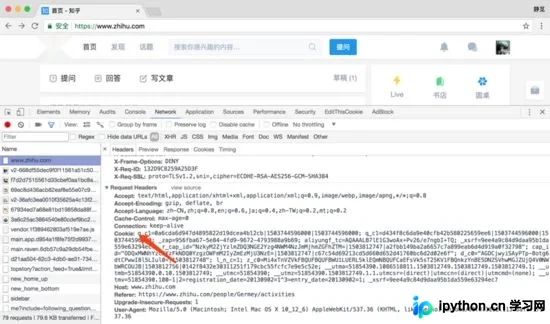
图 3-6 Cookies
此处可替换为你自己的Cookies,并将其设置到Headers中发送请求,示例如下:
import requests

headers = {
  'Cookie': 'q_c1=31653b264a074fc9a57816d1ea93ed8b|1474273938000|1474273938000; d_c0="AGDAs254kAqPTr6NW1U3XTLFzKhMPQ6H_nc=|1474273938"; __utmv=51854390.100-1|2=registration_date=20130902=1^3=entry_date=20130902=1;a_t="2.0AACAfbwdAAAXAAAAso0QWAAAgH28HQAAAGDAs254kAoXAAAAYQJVTQ4FCVgA360us8BAklzLYNEHUd6kmHtRQX5a6hiZxKCynnycerLQ3gIkoJLOCQ==";z_c0=Mi4wQUFDQWZid2RBQUFBWU1DemJuaVFDaGNBQUFCaEFsVk5EZ1VKV0FEZnJTNnp3RUNTWE10ZzBRZFIzcVNZZTFGQmZn|1474887858|64b4d4234a21de774c42c837fe0b672fdb5763b0',
  'Host': 'www.zhihu.com',
  'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_11_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/53.0.2785.116 Safari/537.36',
}
r = requests.get('https://www.zhihu.com', headers=headers)
print(r.text)
结果显示包含了登录后的页面内容,如图3-7所示:
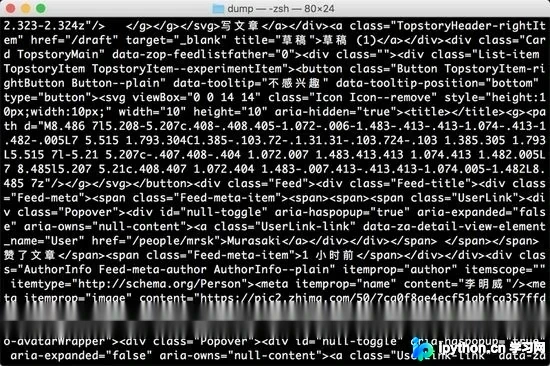
图 3-7 运行结果
这证明登录操作已成功。
当然,也可以通过cookies参数直接设置,但这需要构造RequestsCookieJar对象,并对Cookies字符串进行分割处理,相对繁琐,但效果一致,示例如下:
import requests

cookies = 'q_c1=31653b264a074fc9a57816d1ea93ed8b|1474273938000|1474273938000; d_c0="AGDAs254kAqPTr6NW1U3XTLFzKhMPQ6H_nc=|1474273938"; __utmv=51854390.100-1|2=registration_date=20130902=1^3=entry_date=20130902=1;a_t="2.0AACAfbwdAAAXAAAAso0QWAAAgH28HQAAAGDAs254kAoXAAAAYQJVTQ4FCVgA360us8BAklzLYNEHUd6kmHtRQX5a6hiZxKCynnycerLQ3gIkoJLOCQ==";z_c0=Mi4wQUFDQWZid2RBQUFBWU1DemJuaVFDaGNBQUFCaEFsVk5EZ1VKV0FEZnJTNnp3RUNTWE10ZzBRZFIzcVNZZTFGQmZn|1474887858|64b4d4234a21de774c42c837fe0b672fdb5763b0'
jar = requests.cookies.RequestsCookieJar()
headers = {
  'Host': 'www.zhihu.com',
  'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_11_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/53.0.2785.116 Safari/537.36'
}
for cookie in cookies.split(';'):
  key, value = cookie.split('=', 1)
  jar.set(key, value)
r = requests.get('http://www.zhihu.com', cookies=jar, headers=headers)
print(r.text)
上述代码首先创建了一个RequestsCookieJar对象,利用split()方法分割复制的Cookies字符串,再通过set()方法逐一设置每个Cookie的key和value。最后调用Requests的get()方法,并将构造好的Cookies对象传递给cookies参数。需要注意的是,由于知乎的限制,headers参数仍不可省略,只是无需在headers中再设置Cookie字段。
测试结果表明,此方法同样能成功登录知乎。
3. 会话维持
在Requests中,直接使用get()或post()等方法模拟网页请求时,每次调用都相当于开启了一个新的会话(Session),即不同的浏览器窗口。
设想这样一个场景:第一次请求使用post()方法登录网站,第二次请求使用get()方法获取个人信息。由于这是两个独立的会话,相当于打开了两个不相关的浏览器窗口,因此无法成功获取登录后的个人信息。
有人可能会建议,在两次请求中手动设置相同的Cookies即可。虽然可行,但这种方法较为繁琐,我们还有更简便的解决方案。
解决此问题的关键在于维持同一个会话,这相当于在同一个浏览器中打开新的标签页,而非启动新浏览器。为了避免每次手动设置Cookies,我们可以使用Session对象这一新工具。
利用Session对象,我们可以方便地维护会话状态,无需担心Cookies的管理问题,库会自动处理相关细节。
下面通过一个实例来演示:
import requests

requests.get('http://httpbin.org/cookies/set/number/123456789')
r = requests.get('http://httpbin.org/cookies')
print(r.text)
在示例中,我们首先请求测试网址:http://httpbin.org/cookies/set/number/123456789,该网址用于设置名为number、值为123456789的Cookie。随后,我们请求http://httpbin.org/cookies,该网址用于获取当前会话中的Cookies。
这样能否成功获取设置的Cookies呢?让我们尝试一下。
运行结果如下:
{
 "cookies": {}
}
结果并不理想。接下来,我们使用Session对象重试:
import requests

s = requests.Session()
s.get('http://httpbin.org/cookies/set/number/123456789')
r = s.get('http://httpbin.org/cookies')
print(r.text)
查看运行结果:
{
 "cookies": {
  "number": "123456789"
 }
}
成功获取!此时,你应该能体会到同一会话与不同会话之间的区别。
因此,利用Session对象可以模拟同一会话,无需担心Cookies问题,通常用于模拟登录成功后执行后续操作。
Session对象在日常开发中应用广泛,可用于模拟在浏览器中打开同一站点的不同页面,后文将有专门章节深入讲解此部分内容。
SSL证书验证与处理
4. SSL证书验证
Requests库提供了SSL证书验证功能。发送HTTP请求时,默认会检查SSL证书(verify参数默认为True)。
前文曾提及,12306网站的证书未被官方认可,访问时会出现证书验证错误提示,如图3-8所示:
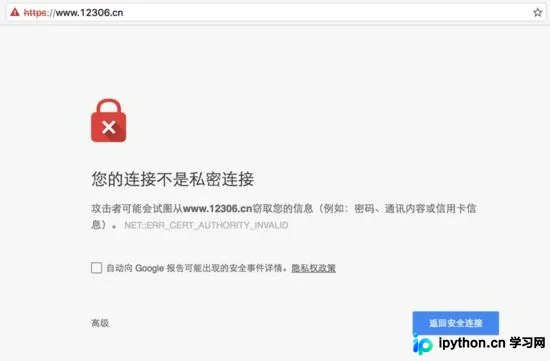
图 3-8 错误页面
现在,我们使用Requests库进行测试:
import requests
response = requests.get('https://www.12306.cn')
print(response.status_code)
运行结果如下:
requests.exceptions.SSLError: ("bad handshake: Error([('SSL routines', 'tls_process_server_certificate', 'certificate verify failed')],)",)
系统提示SSLError错误,即证书验证失败。因此,当请求的HTTPS站点证书验证出错时,会抛出此类异常。解决方法很简单,将verify参数设置为False即可。
修改代码如下:
import requests
response = requests.get('https://www.12306.cn', verify=False)
print(response.status_code)
此时,程序将打印出请求成功的状态码。
/usr/local/lib/python3.6/site-packages/urllib3/connectionpool.py:852: InsecureRequestWarning: Unverified HTTPS request is being made. Adding certificate verification is strongly advised. See: https://urllib3.readthedocs.io/en/latest/advanced-usage.html#ssl-warnings
 InsecureRequestWarning)
200
不过,控制台会显示一条警告,建议指定证书。
我们可以通过设置忽略警告来屏蔽该提示:
import requests
from requests.packages import urllib3
urllib3.disable_warnings()
response = requests.get('https://www.12306.cn', verify=False)
print(response.status_code)
或者通过捕获警告到日志的方式来忽略:
import logging
import requests
logging.captureWarnings(True)
response = requests.get('https://www.12306.cn', verify=False)
print(response.status_code)
此外,还可以指定本地证书作为客户端证书,可以是包含密钥和证书的单文件,也可以是包含两个文件路径的元组。
import requests
response = requests.get('https://www.12306.cn', cert=('/path/server.crt', '/path/key'))
print(response.status_code)
上述代码为示例,实际使用时需具备crt和key文件,并指定其路径。请注意,本地私有证书的key必须处于解密状态,加密状态的key不被支持。
代理设置与SOCKS支持
5. 代理设置
对于某些网站,少量请求可能正常获取内容,但大规模爬取时,网站可能会触发验证码验证,甚至直接封禁IP。
为防止这种情况,我们需要设置代理。在Requests库中,需使用proxies参数。
设置方式如下:
import requests
proxies = {
 'http': 'http://10.10.1.10:3128',
 'https': 'http://10.10.1.10:1080',
}
requests.get('https://www.taobao.com', proxies=proxies)
直接运行此示例可能无效,因为代理可能已失效,请替换为有效的代理地址进行测试。
若代理需要使用HTTP Basic Auth,可采用类似http://user:password@host:port的语法进行设置。
示例如下:
import requests
proxies = {
  'https': 'http://user:password@10.10.1.10:3128/',
}
requests.get('https://www.taobao.com', proxies=proxies)
除了基本的HTTP代理,Requests还支持SOCKS协议代理。
首先需安装Socks库,命令如下:
pip3 install "requests[socks]"
安装完成后,即可使用SOCKS协议代理,示例如下:
import requests
proxies = {
  'http': 'socks5://user:password@host:port',
  'https': 'socks5://user:password@host:port'
}
requests.get('https://www.taobao.com', proxies=proxies)
超时控制策略
6. 超时设置
当本机网络状况不佳或服务器响应缓慢甚至无响应时,请求可能会长时间挂起甚至报错。为防止服务器响应不及时,应设置超时时间,即超过该时间未收到响应则抛出异常。
设置超时时间需使用timeout参数,该时间计算的是从发出Request到服务器返回Response的时间。
下面通过一个实例来演示:
import requests
r = requests.get('https://www.taobao.com', timeout=1)
print(r.status_code)
通过这种方式,可将超时时间设置为1秒,若1秒内无响应,则抛出异常。
实际上,请求分为两个阶段:connect(连接)和read(读取)。
上述设置的timeout值将作为connect和read两个阶段的超时总和。
若要分别指定,可传入一个元组:
r = requests.get('https://www.taobao.com', timeout=(5, 11))
若希望永久等待,可将timeout设置为None,或不设置(默认为None)。这样,即使服务器响应缓慢,也不会返回超时错误。
用法如下:
r = requests.get('https://www.taobao.com', timeout=None)
或直接省略参数:
r = requests.get('https://www.taobao.com')
7. 身份认证
身份认证机制
访问某些网站时,可能会遇到认证页面,如图3-9所示:
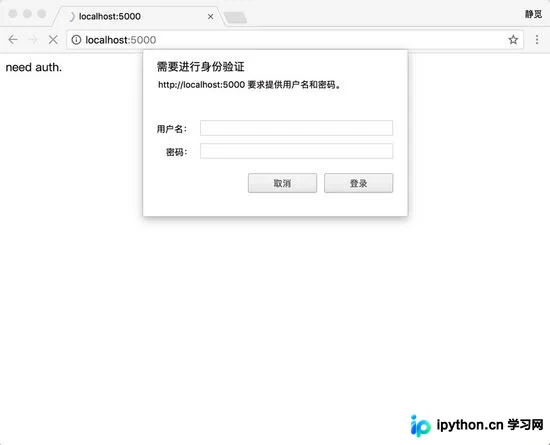
图 3-9 认证页面
遇到此类网站验证时,可使用Requests自带的身份认证功能,示例如下:
import requests
from requests.auth import HTTPBasicAuth
r = requests.get('http://localhost:5000', auth=HTTPBasicAuth('username', 'password'))
print(r.status_code)
若用户名和密码正确,请求将自动认证成功,返回200状态码;若认证失败,则返回401状态码。
当然,若每次传递HTTPBasicAuth类显得繁琐,Requests提供了更简洁的写法,可直接传递元组,库会默认使用HTTPBasicAuth类进行认证。
因此,上述代码可直接简写为:
import requests
r = requests.get('http://localhost:5000', auth=('username', 'password'))
print(r.status_code)
运行效果与前述示例一致。
Requests还提供了其他认证方式,如OAuth认证,但需安装oauth包,命令如下:
pip3 install requests_oauthlib
使用OAuth1认证的方法如下:
import requests
from requests_oauthlib import OAuth1
url = 'https://api.twitter.com/1.1/account/verify_credentials.json'
auth = OAuth1('YOUR_APP_KEY', 'YOUR_APP_SECRET',
       'USER_OAUTH_TOKEN', 'USER_OAUTH_TOKEN_SECRET')
requests.get(url, auth=auth)
更多详细功能可参考requests_oauthlib的官方文档:https://requests-oauthlib.rea...,此处不再赘述。
Prepared Request对象应用
8. Prepared Request
在前文介绍Urllib时,可将Request表示为数据结构,其参数通过Request对象体现。在Requests库中同样可以实现,该数据结构称为Prepared Request。
我们通过一个实例来演示:
from requests import Request, Session

url = 'http://httpbin.org/post'
data = {
  'name': 'germey'
}
headers = {
  'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_11_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/53.0.2785.116 Safari/537.36'
}
s = Session()
req = Request('POST', url, data=data, headers=headers)
prepped = s.prepare_request(req)
r = s.send(prepped)
print(r.text)在此示例中,我们引入了Request,并使用url、data、headers参数构造了一个Request对象。随后,需调用Session的prepare_request() 方法将其转换为Prepared Request对象,最后调用send()方法发送请求,运行结果如下:
{
 "args": {},
 "data": "",
 "files": {},
 "form": {
  "name": "germey"
 },
 "headers": {
  "Accept": "*/*",
  "Accept-Encoding": "gzip, deflate",
  "Connection": "close",
  "Content-Length": "11",
  "Content-Type": "application/x-www-form-urlencoded",
  "Host": "httpbin.org",
  "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_11_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/53.0.2785.116 Safari/537.36"
 },
 "json": null,
 "origin": "182.32.203.166",
 "url": "http://httpbin.org/post"
}
可以看到,我们达到了与直接POST请求相同的效果。
有了Request对象,我们可以将每个请求视为独立对象,这在队列调度时非常便利,后文将有一节专门讲解如何构造Request队列。
9. 结语
本节讲解了Requests库的一些高级用法,这些功能在后续实战中应用频繁,需熟练掌握。
更多用法可参考Requests官方文档:http://docs.python-requests.org/。
总结
以上所述是小编给大家介绍的Python3网络爬虫中的requests高级用法详解,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对本站网站的支持! 如果你觉得本文对你有帮助,欢迎转载,烦请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















