


Python实现微博热搜数据抓取:基于Requests与Lxml的实战教程

本文介绍使用Python的Requests和Lxml库抓取微博热搜数据的方法。通过解析HTML源码,利用XPath定位热搜标题、排名及阅读量节点,并处理置顶微博的特殊逻辑,最终格式化输出结果。
抓取微博热搜数据的过程相对直接,本示例主要依赖lxml和requests这两个Python库来完成。
目标URL为:https://s.weibo.com/top/summary?Refer=top_hot&topnav=1&wvr=6
第一步,分析网页源代码:在浏览器中右键点击页面,选择“查看网页源代码”以查看原始HTML结构。
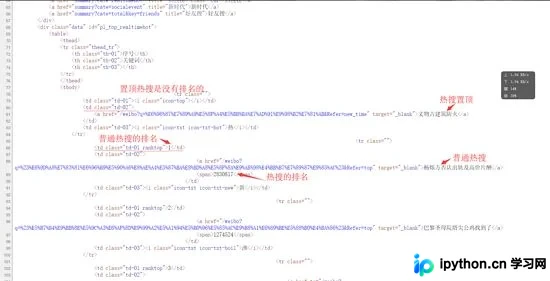
通过检查网页代码,我们可以定位到关键的数据节点。
具体而言,热搜标题文本位于<td class="td-02">元素的子节点<a>中。
其次,热搜的排名信息包含在<td class=td-01 ranktop>元素内(需注意,置顶微博不显示常规排名)。
最后,热搜的阅读量数据存储在<td class="td-02">元素的子节点<span>中。
第二步,使用requests库获取网页内容。
首先定义目标url,并设置User-Agent以模拟浏览器请求(此步骤虽非绝对必要,但有助于防止被识别为爬虫程序)。
###网址
url="https://s.weibo.com/top/summary?Refer=top_hot&topnav=1&wvr=6"
###模拟浏览器,这个请求头windows下都能用
header={'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36'}
接着,利用requests库的get()方法获取网页文本,并通过lxml的etree.HTML()将文本解析为DOM对象。
###获取html页面
  html=etree.HTML(requests.get(url,headers=header).text)
第三步,构造XPath路径以提取数据。
根据前文分析的HTML结构,对应的三个XPath路径分别如下。
affair=html.xpath('//td[@class="td-02"]/a/text()')
rank=html.xpath('//td[@class="td-01 ranktop"]/text()')
view=html.xpath('//td[@class="td-02"]/span/text()')
由于XPath查询返回的是列表,因此变量affair、rank和view均为字符串列表。
第四步,对提取的数据进行格式化输出。
需要注意的是,affair列表中第一个元素为置顶热搜,需将其单独分离处理。
top=affair[0]
affair=affair[1:]
此处使用了Python的列表切片功能来实现这一分离。
 print('{0:<10}\t{1:<40}'.format("top",top))
  for i in range(0, len(affair)):
    print("{0:<10}\t{1:{3}<30}\t{2:{3}>20}".format(rank[i],affair[i],view[i],chr(12288)))
当前的输出格式尚未实现完美的列对齐,但已能展示基本数据。
第五步,整合全部代码。
###导入模块
import requests
from lxml import etree
###网址
url="https://s.weibo.com/top/summary?Refer=top_hot&topnav=1&wvr=6"
###模拟浏览器
header={'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36'}
###主函数
def main():
  ###获取html页面
  html=etree.HTML(requests.get(url,headers=header).text)
  rank=html.xpath('//td[@class="td-01 ranktop"]/text()')
  affair=html.xpath('//td[@class="td-02"]/a/text()')
  view = html.xpath('//td[@class="td-02"]/span/text()')
  top=affair[0]
  affair=affair[1:]
  print('{0:<10}\t{1:<40}'.format("top",top))
  for i in range(0, len(affair)):
    print("{0:<10}\t{1:{3}<30}\t{2:{3}>20}".format(rank[i],affair[i],view[i],chr(12288)))
main()
程序运行后的结果展示如下。
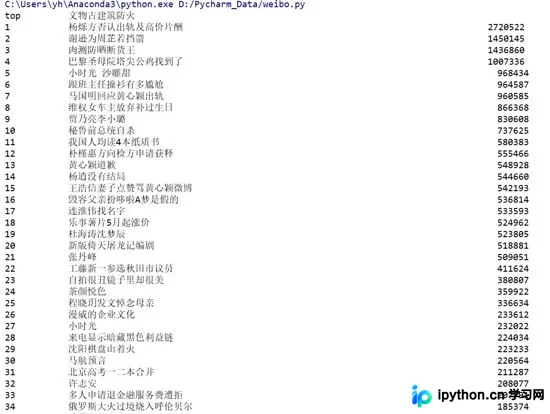
总结:本文介绍了使用Python进行微博热搜抓取的基本流程。
以上内容为Python网络爬虫之爬取微博热搜的详细介绍,希望能对大家有所帮助。如有任何疑问,欢迎留言,小编会及时回复。感谢大家对本站的支持! 如果本文对您有帮助,欢迎转载,请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















