



在 Go 项目里,很多性能问题并不是出在复杂算法上,而是悄悄出在一次次堆分配和随之而来的 GC 成本上。内存逃逸正是定位这类问题的入口:本文会先讲清它到底是什么,再结合常见触发场景、编译器分析命令和可落地的优化写法,帮你判断哪些代码值得改,哪些逃逸其实不用过度紧张。
什么是内存逃逸,为什么它会拖慢程序
在 Go 里,变量通常会被分配在栈或堆上。栈属于函数调用过程中的局部内存区域,函数结束后会自动回收;堆则由运行时统一管理,回收依赖垃圾回收器(GC)。
所谓内存逃逸,就是原本有机会分配在栈上的变量,因为生命周期、大小或使用方式等原因,被编译器安排到了堆上。
这件事之所以值得关注,是因为两者的成本差异很明显:栈分配通常非常快,而堆分配要经过更复杂的内存管理流程;变量一旦进入堆,还会继续增加 GC 的扫描和回收负担。
func main() {
    // 这个变量可能会分配在栈上
    a := make([]int, 0, 10)

    // 这个变量可能会逃逸到堆上
    b := make([]int, 0, 100000)
}
从性能角度看,逃逸带来的影响主要集中在三点:
- 内存分配速度变慢,堆分配通常比栈分配慢得多;
- GC 压力上升,程序吞吐和延迟都可能受影响;
- 堆对象增多后,还可能带来更多内存碎片问题。
但也要先建立一个正确预期:逃逸不是错误,更不是越少越绝对正确。编译器让变量逃逸,很多时候是在为程序正确性兜底。真正要做的是识别“不必要的逃逸”,优先处理性能敏感路径里的热点分配。
Go 中最常见的几类逃逸场景
理解具体触发方式,比死记定义更有用。下面几类场景,是日常 Go 代码里最常碰到的。
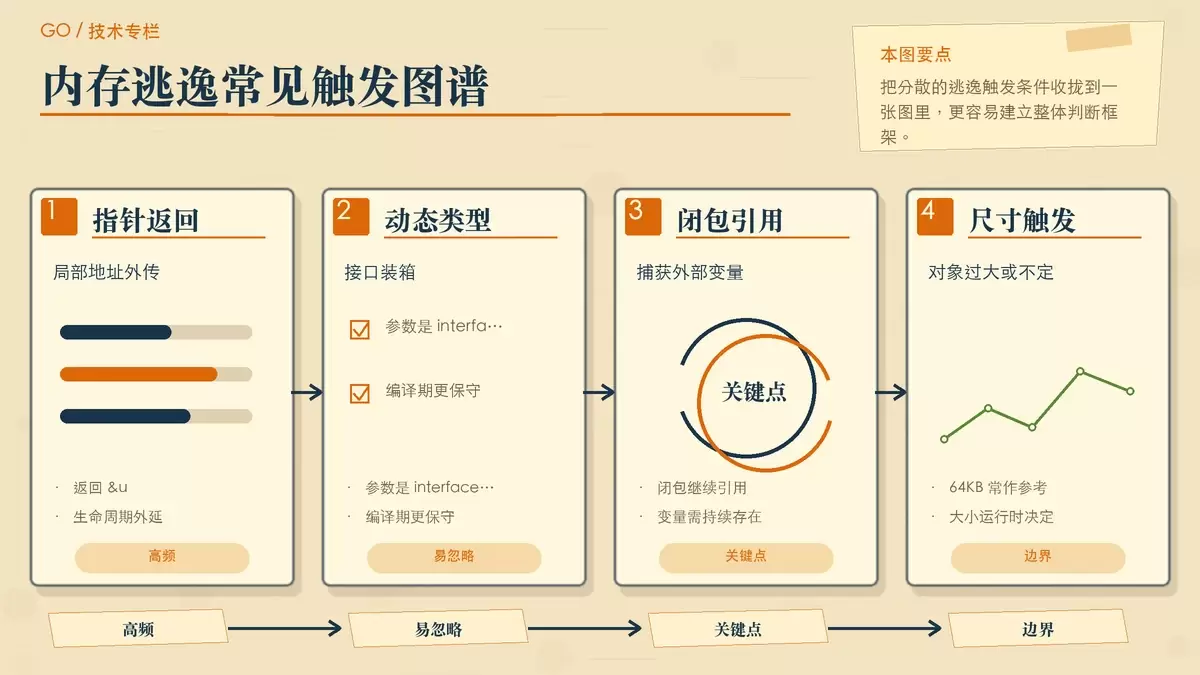
返回局部变量指针
当函数返回局部变量的地址时,编译器无法让这个变量随着函数结束而销毁,因为外部代码还可能继续使用它。
func createUser() *User {
    u := User{Name: "张三", Age: 20} // moved to heap: u
    return &u
}这种情况里,u 的生命周期被延长,只能放到堆上。这也是最典型、最好理解的一种逃逸。
接口参数引发的动态类型逃逸
当值被传给 interface{} 参数时,编译器在编译阶段无法完全按具体类型处理,可能因此采取更保守的分配策略。
func main() {
    s := "hello"
    fmt.Println(s) // s escapes to heap
}
这里的关键点不在 fmt.Println 本身,而在于它接收的是接口类型参数。对于性能敏感代码,这类“看起来无害”的接口传递值得额外留意。
对象过大,超出栈上合适范围
即使一个变量的生命周期完全局部,也不代表它一定能留在栈上。如果对象太大,编译器也可能直接把它放到堆上。
func main() {
    // 不会逃逸
    a := make([]int, 0, 8191)

    // 会逃逸(64KB边界,64位系统)
    b := make([]int, 0, 8192) // escapes to heap
}
原文给出的经验值是:在 64 位系统中,64KB 往往是一个临界点。超过这个量级后,变量更容易被放进堆里。这里不该把数值理解成绝对规则,但在分析大切片、大数组时很有参考意义。
闭包捕获外部变量
闭包会把它引用的外部变量一起“带出去”。只要闭包的生命周期超出当前函数调用,这些变量就可能不能继续待在栈上。
func counter() func() int {
    n := 0 // moved to heap: n
    return func() int {
        n++
        return n
    }
}
这里的 n 需要在多次调用返回函数时持续存在,因此会逃逸到堆上。闭包很方便,但在热点路径里频繁使用时,最好知道自己在为这种便利付出什么代价。
动态大小分配
当切片长度或容量依赖运行时变量,而不是编译期可确定的常量时,编译器也可能选择更保守的处理方式。
func main() {
    size := 100
    s := make([]int, size) // escapes to heap
}
这一类逃逸在业务代码里很常见,因为很多容量本来就来自请求参数、配置或数据规模。遇到这种情况,重点不是机械消灭,而是判断这段分配是否处在真正需要抠性能的关键路径上。
怎么用编译器定位逃逸
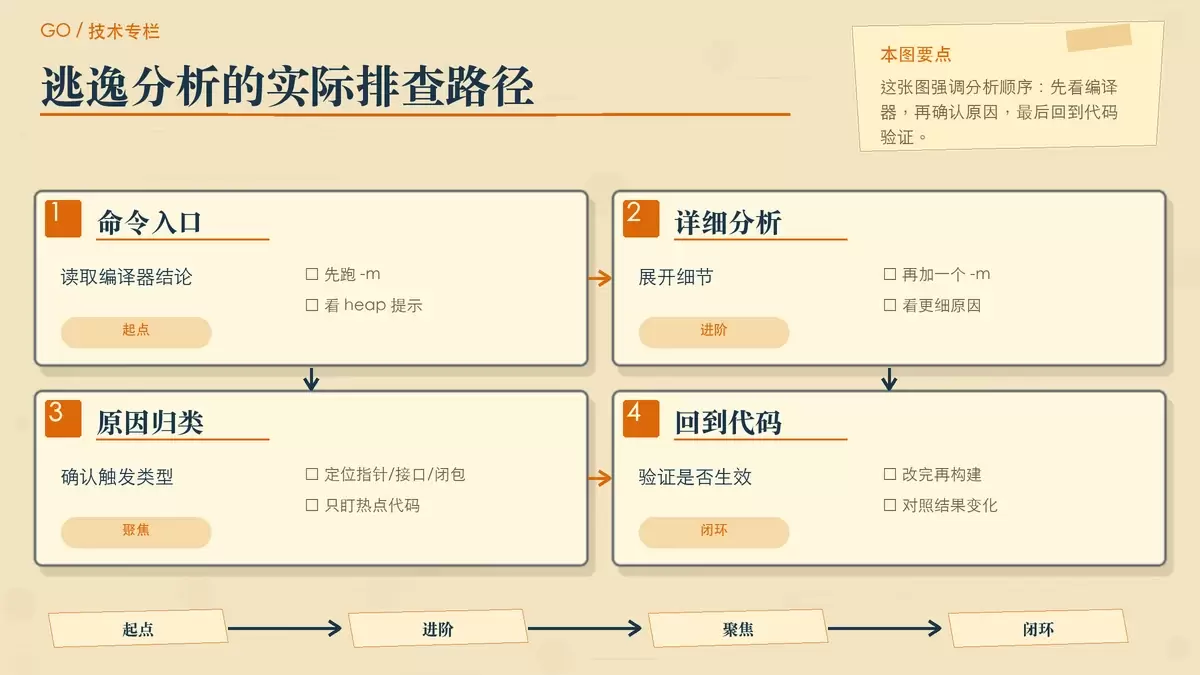
Go 自带的逃逸分析工具已经足够实用,第一步通常不需要额外引入任何分析器。最常用的方式是直接在构建时打开编译器输出:
go build -gcflags="-m" main.go这个 -m 参数会打印编译器的逃逸分析结论,例如:
./example.go:10:6: can inline createUser
./example.go:11:2: moved to heap: u
从输出里可以直接看到哪些变量被移到了堆上,以及编译器是否做了内联等相关优化。
如果你想看更详细的判断过程,可以继续增加一个 -m:
go build -gcflags="-m -m" main.go实践里比较有效的做法是:
- 先对怀疑存在分配热点的包或示例程序跑一遍
-m; - 对照输出,确认是返回指针、接口装箱、闭包捕获,还是大对象导致的逃逸;
- 只修改真正影响性能的数据路径,再重新执行同样命令验证结果是否变化。
也就是说,逃逸优化最好建立在“先观察、再改写、再验证”的流程上,而不是凭感觉大面积改代码风格。
减少不必要逃逸的几种实用写法
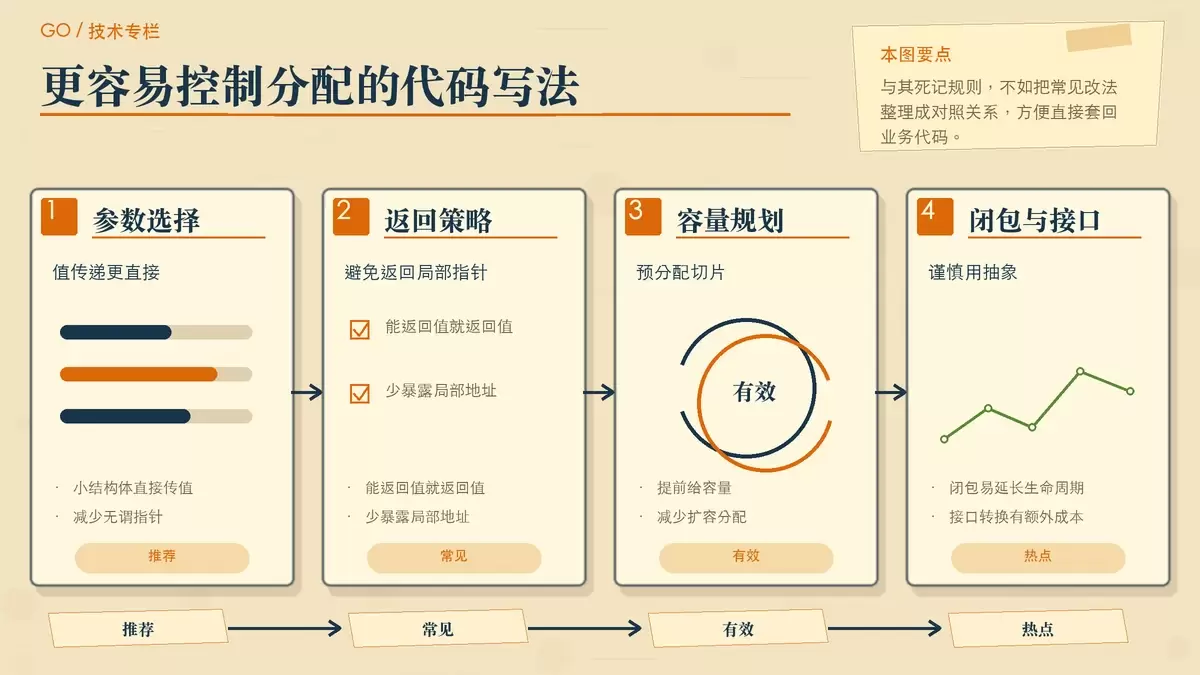
下面这些建议并不是教条,而是一些在 Go 中普遍有效、同时又比较容易落地的优化方向。
小对象优先值传递
对于体积较小、复制成本低的结构体,值传递通常更直接,也更不容易引入额外逃逸。
// 好的做法:小结构体使用值传递
type Point struct { X, Y int }

func processPoint(p Point) { // 不会发生逃逸
    // ...
}

// 不必要的指针使用
func processPointRef(p *Point) { // 可能导致逃逸
    // ...
}
很多代码一上来就用指针参数,理由常常只是“避免拷贝”。但如果对象很小,这种优化未必成立,反而可能把代码推向更多堆分配。
没有必要时,不要返回局部变量指针
如果调用方并不需要共享、修改或长期持有对象,直接返回值通常更合适。
// 不推荐:可能导致逃逸
func getUser() *User {
    u := User{}
    return &u // 逃逸到堆
}

// 推荐:返回值
func getUser() User {
    u := User{}
    return u // 栈上分配
}
这类改动往往很小,但对高频函数来说,累计效果可能很明显。
预分配切片和映射容量
预分配不一定直接消除所有逃逸,但它能显著减少扩容过程中的重复分配,通常也是 Go 性能优化里性价比很高的一步。
// 不推荐:可能多次分配
var data []int
for i := 0; i < 1000; i++ {
    data = append(data, i)
}

// 推荐:预分配
data := make([]int, 0, 1000)
for i := 0; i < 1000; i++ {
    data = append(data, i)
}
尤其当数据规模有明确上限时,提前给出容量通常比事后依赖自动扩容更稳妥。
热点路径中谨慎使用闭包
闭包并不等于低性能,但它天然更容易让外部变量延长生命周期。在循环、回调密集逻辑或高频调用场景中,要特别小心。
// 不推荐:闭包导致逃逸
func processor() func() int {
    count := 0 // 逃逸到堆
    return func() int {
        count++
        return count
    }
}

// 替代方案:使用结构体
type Counter struct {
    count int
}

func (c *Counter) Next() int {
    c.count++
    return c.count
}
结构体方法不一定总比闭包快,但在需要稳定控制对象生命周期时,它通常更容易分析,也更利于后续排查分配问题。
性能敏感代码减少接口转换
接口是 Go 很重要的抽象手段,但在一些极端关注分配和延迟的代码里,频繁把具体类型装进接口,可能带来额外成本。
// 可能导致逃逸
func printValue(v interface{}) {
    fmt.Println(v)
}

// 对于性能敏感的代码,使用具体类型
func printInt(v int) {
    fmt.Println(v)
}
这里的重点不是“少用接口”,而是把接口留在真正需要抽象边界的地方;一旦进入热点内部循环,具体类型往往更容易让编译器做出高效决策。
一个更直观的优化案例
只看零散规则容易碎片化,放到完整函数里会更清楚。下面这个例子展示了“保存指针”与“保存值”在结果集构建上的差异:
// 优化前:可能存在不必要的逃逸
func processUsers(users []User) []*User {
    result := make([]*User, 0)
    for i := range users {
        if users[i].Active {
            result = append(result, &users[i]) // 可能导致逃逸
        }
    }
    return result
}

// 优化后:减少逃逸
func processUsersOptimized(users []User) []User {
    result := make([]User, 0, len(users))
    for i := range users {
        if users[i].Active {
            result = append(result, users[i]) // 不会逃逸
        }
    }
    return result
}
优化前的版本返回的是 []*User,并把元素地址加入结果切片;优化后的版本直接返回 []User,同时按 len(users) 预分配容量。这样做的价值有两层:
- 减少了因为持有元素地址而可能产生的逃逸;
- 减少了结果切片增长时的额外分配次数。
当然,是否能改成值返回,还得看业务语义。如果外部逻辑确实需要共享同一对象、持续修改原对象状态,那么指针语义依然可能是合理选择。性能优化不能脱离语义正确性单独谈。
写在最后:哪些逃逸该管,哪些不用过度紧张
Go 的内存逃逸分析,本质上是在性能和正确性之间做权衡。理解它的意义,不是为了把所有变量都“压回栈上”,而是为了知道堆分配为什么出现、是否出现在关键路径、值不值得动手优化。
可以记住几条最实用的判断原则:
- 栈分配通常比堆分配快得多,减少不必要逃逸往往能改善性能;
- 不是所有逃逸都是坏事,很多逃逸是程序正确运行的前提;
- 优先依赖编译器输出做判断,用
go build -gcflags="-m"找到真实分配点; - 把精力放在性能敏感路径上,不要为了“零逃逸”牺牲代码可读性和设计合理性。
对 Go 开发来说,逃逸分析最有价值的地方,不是让你记住多少条规则,而是帮你在看到指针、接口、闭包、大对象和动态分配时,能提前意识到它们可能带来的运行时成本。做到这一点,性能优化就不再是碰运气,而是有依据地收敛问题。















