


pandas中value_counts()函数的详细用法与参数解析

发布时间:2026-10-13 |
4人浏览过
本文详解pandas库中value_counts()函数的使用方法。涵盖Series单个列的频次统计、默认降序与升序排列、normalize参数计算占比,以及DataFrame多列批量统计。重点解析ascending和normalize参数的具体应用及空值处理机制,帮助开发者高效进行数据分布分析。
pandas value_counts() 函数概述
在pandas数据处理中,经常需要确认数据出现的频率,此时常用value_counts()函数来实现这一需求。
Series 数据类型的计数与排序
1. Series 情况下的应用:
pandas 提供的 value_counts() 函数能够对 Series 对象中的每个唯一值进行计数,并自动按计数结果进行排序。
import pandas as pd
df = pd.DataFrame({'区域' : ['西安', '太原', '西安', '太原', '郑州', '太原'],
         '10月份销售' : ['0.477468', '0.195046', '0.015964', '0.259654', '0.856412', '0.259644'],
         '9月份销售' : ['0.347705', '0.151220', '0.895599', '0236547', '0.569841', '0.254784']})
print(df)
例如,统计数据集中每个区域出现的次数:
print(df['区域'].value_counts())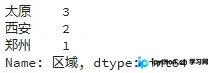
执行后,每个区域都会被单独计数,且默认情况下结果按计数值从高到低进行排序。
若希望结果按升序排列,可以设置参数 ascending = True:
print(df['区域'].value_counts(ascending=True))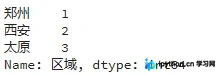
如果需要计算每个值出现的计数占比,可以添加参数 normalize=True:
print(df['区域'].value_counts(normalize=True))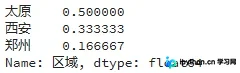
注意:默认情况下,空值(NaN)会被剔除不计入结果。value_counts() 返回的结果是一个 Series 对象,可以直接与其他数组或 Series 进行数学计算。
DataFrame 数据类型的批量统计
2. DataFrame 情况下的应用:
import pandas as pd
df = pd.DataFrame({'区域1' : ['西安', '太原', '西安', '太原', '郑州', '太原'],
          '区域2' : ['太原', '太原', '西安', '西安', '西安', '太原']})
print(df.apply(pd.value_counts))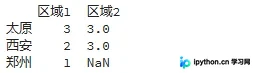
在区域2列中,由于没有郑州这一数据,因此对应位置显示为 NaN。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















