


Python性能测试实战:cProfile与pstats详解

本文详细介绍Python标准库中用于性能测试的cProfile和pProfile模块,重点讲解cProfile.run()与runctx()用法及输出字段含义。通过fib函数示例,演示如何利用lru_cache缓存与迭代法优化递归性能,并展示pstats对测试结果的聚合、排序与过滤功能,帮助开发者高效定位性能瓶颈。
Python性能分析模块概览
Profile 和 cProfile
Python 标准库提供了两个用于性能分析的模块。
第一个是 Profile,它由纯 Python 编写,执行速度相对较慢,但因其易于扩展,适合需要定制分析逻辑的场景。
第二个是 cProfile,作为 C 语言实现的版本,官方建议在绝大多数常规场景下优先使用。 这两个模块拥有完全一致的接口和数据输出格式,用户可以在两者间无缝切换,因此下文将以 cProfile 为例展开说明。
cProfile基础用法与结果解读
使用 cProfile 进行性能测试
在 cProfile 中执行性能测试非常便捷,只需调用 run 方法,并将目标函数及其参数传入即可。以下示例展示了如何对 fib(n) 函数进行性能分析。
import cProfile

def fib(n):
 if n == 0:
 return 0
 if n == 1:
 return 1
 return fib(n-1) + fib(n-2)

if __name__ == '__main__':
 cProfile.run('fib(30)')
性能测试的具体结果如下图所示。
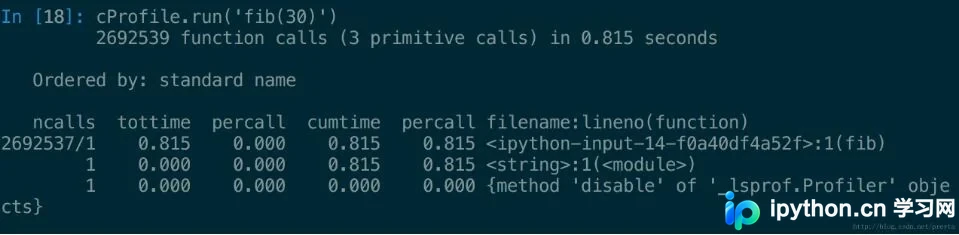
从输出可见,程序总共执行了 2692539 次函数调用,总耗时为 0.815 秒。输出的每一行代表一个函数的调用详情,其中包含以下关键指标:
1. ncalls:函数被调用的总次数; 2. tottime:该函数内部执行所花费的总时间(不含子调用); 3. percall:单次调用的平均耗时(tottime / ncalls); 4. cumtime:该函数及其所有子调用累计花费的总时间; 5. percall:单次调用的平均累计耗时(cumtime / 原始调用次数); 6. filename:lineno(function):显示函数所在的文件名、行号及函数名。
递归性能优化策略
观察上述结果可知,绝大部分耗时集中在 fib 函数上,且调用次数异常庞大。这主要归因于递归调用产生了大量冗余分支,因此程序亟需优化。针对此问题,主要有两种改进方案:一是引入缓存机制存储 fib(n) 的计算结果,避免重复计算;二是将递归逻辑重构为迭代实现。
在 Python 3 中,实现函数值缓存有一个简便的方法,即使用 lru_cache 装饰器。该装饰器能自动管理缓存,无需手动编写存储逻辑。
import functools

@functools.lru_cache(maxsize=None)
def fib(n):
 if n == 0:
 return 0
 if n == 1:
 return 1
 return fib(n-1) + fib(n-2)
优化后的运行结果如下所示。
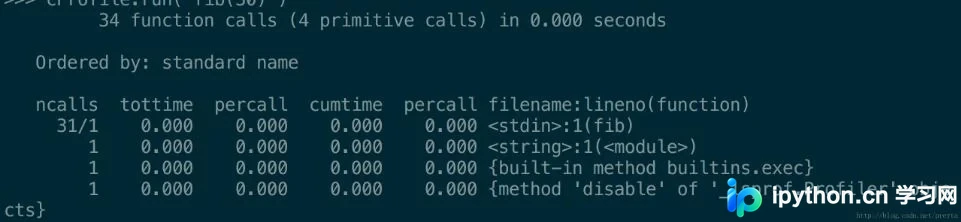
结果显示,fib 函数仅被调用了 31 次,绝大多数后续调用均直接命中缓存,调用次数远低于之前的递归版本,且运行时间得到了显著提升。此外,采用下文所示的迭代版程序同样运行迅速,此处不再赘述。
def fib(n):
 prev, cur = 0, 1
 if n == 0:
 return prev
 if n == 1:
 return cur
 count = 1
 while count < n:
 count += 1
 prev, cur = cur, prev + cur
 return cur
高级用法与结果持久化
除了常用的 run 方法外,cProfile 还提供了 runctx 方法,允许传入更详细的上下文参数。例如,前文的 cProfile.run('fib(30)') 可以改写为 cProfile.runctx('fib', globals(), {'n':30}),最终得到的运行结果是一致的。
最后,除了将结果直接打印至命令行,run 和 runctx 方法均支持通过第二个参数指定文件名,从而将性能分析结果写入文件以便后续处理。
使用pstats处理复杂分析结果
使用 pstats 对显示进行控制
虽然 cProfile 能提供基础的测试数据,但当程序规模庞大、函数调用错综复杂时,需要借助工具对测试结果进行过滤和排序,pstats 正是为此设计的工具。
# fib_profile.py
import cProfile
import pstats

for i in range(5):
 cProfile.run('fib(1000)', 'fib_profile_{}'.format(i))

stats = pstats.Stats('fib_profile_0')
for i in range(1, 5):
 stats.add('fib_profile_{}'.format(i))
stats.strip_dirs()
stats.sort_stats('cumulative')
stats.print_stats('fib')
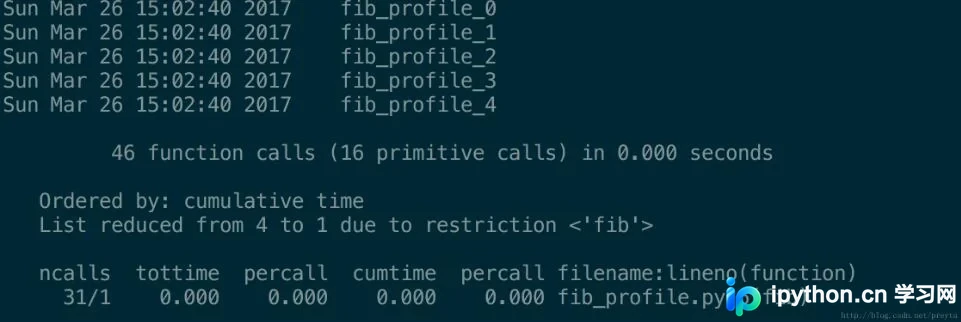
上述代码首先生成了多个测试结果文件,随后初始化 Stats 对象。通过 stats 的 add 方法可以添加新的分析文件,pstats 会自动聚合这些数据;strip_dirs 用于移除文件路径前缀,仅保留文件名;sort_stats 用于对输出结果进行排序(具体排序选项可参考官方文档);最后的 print_stats 负责输出结果,并支持按行过滤,例如示例中仅输出包含 fib 的行。实际输出结果如下。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















