



在 Go 项目里,很多低价值但又绕不过去的工作都很像:枚举一变就要补 String(),.proto 一更新就得重新生成代码,测试里还要反复写 Mock。go generate 解决的正是这一类“规则明确、重复出现、手写容易漏”的任务。看完这篇,你可以快速判断它的边界、常见落点,以及在团队项目里怎样用得省事又不添乱。
Go Generate 到底解决什么问题
go generate 是 Go 自 1.4 版本引入的官方代码生成工具。它会扫描 Go 源码中的特殊注释,并执行注释里声明的命令,从而生成或更新代码文件。
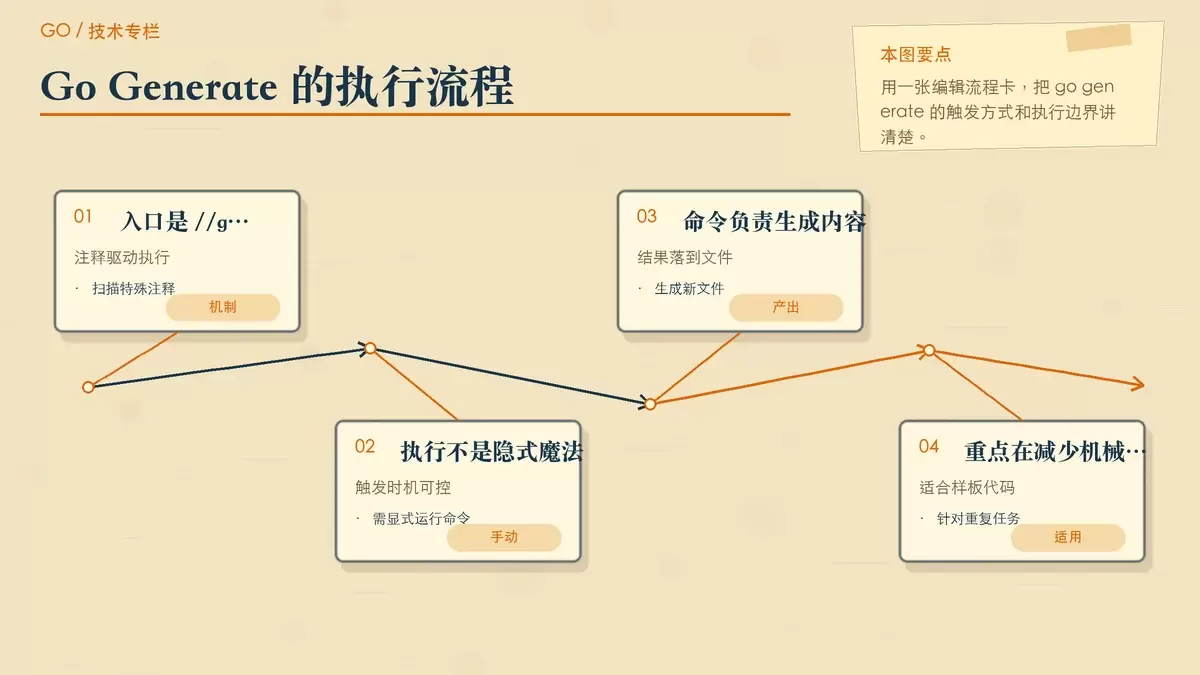
它和 go build、go test 最大的区别在于:不会在编译或测试时自动运行。你需要显式执行 go generate,这意味着代码生成不是隐藏在构建过程里的“黑盒”,而是一个开发者主动触发、便于排查的步骤。
它的基本流程并不复杂:
- 在源码里写入
//go:generate注释 - 手动运行
go generate - Go 工具执行对应命令,生成目标文件
这套机制的价值不在“自动”本身,而在于把重复劳动明确收口到统一入口。只要某段代码满足“可根据规则稳定生成”,就可以考虑交给它处理。
从一个最小例子快速上手
先看最简单的形式:
//go:generate echo "Hello, Generate!"执行 go generate 后,终端会输出 Hello, Generate!。这个例子本身没什么业务价值,但足够说明一件事:go generate 并不关心你要生成什么,它只负责按注释里的命令去执行。
真实场景:给枚举自动生成 String() 方法
这是很多 Go 开发者最容易马上用上的场景。假设有一个枚举类型:
//go:generate stringer -type=Fruit -linecomment
type Fruit int

const (
    Apple Fruit = iota
    Banana
    Cherry
)
安装 stringer 工具后:
go install golang.org/x/tools/cmd/stringer@latest再运行 go generate,就会生成 fruit_string.go,里面包含 Fruit 类型对应的 String() 方法。
这类生成的好处很直接:以后新增或删除枚举值时,不必再手工维护字符串映射,重新执行一次生成命令即可。相比手写 switch 或维护数组映射,这种做法更省时间,也更不容易漏改。
哪些场景最适合交给 go generate
go generate 适合的不是所有自动化,而是那些和源码紧密相关、由开发者在本地或项目流程中主动触发的生成任务。下面几类尤其常见。
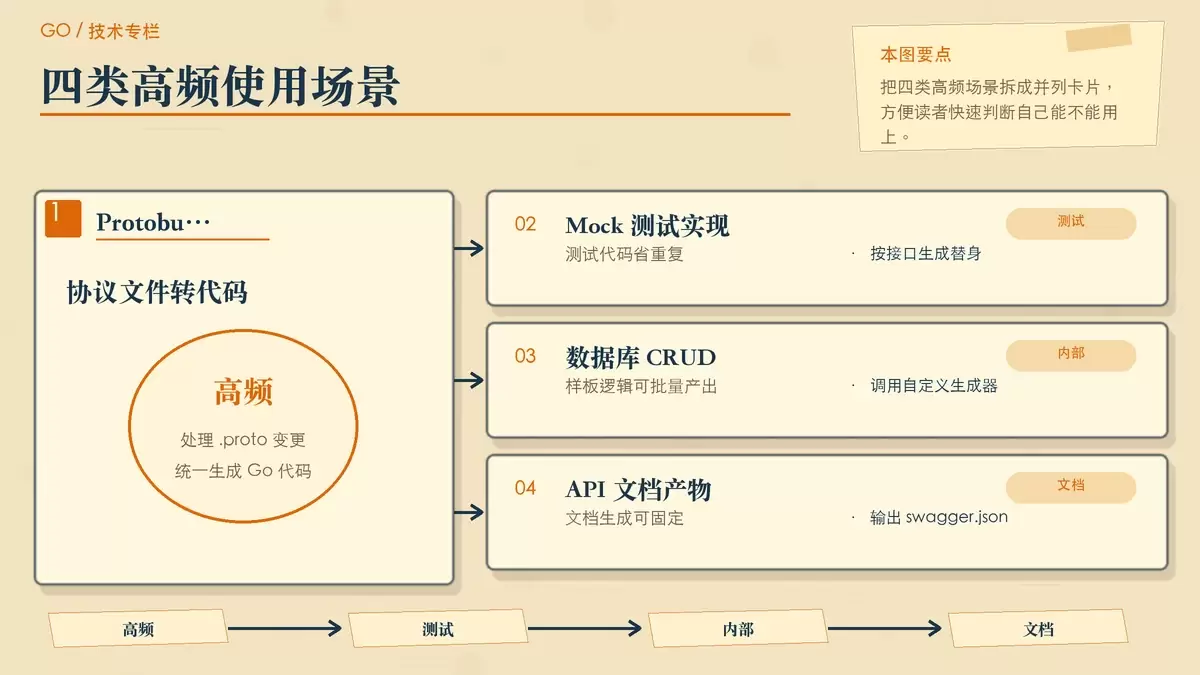
处理 Protocol Buffers
在 gRPC 或 Protobuf 项目里,.proto 文件变更后通常都要重新生成 Go 代码。把命令写进源码后,执行入口会更统一:
//go:generate protoc --go_out=. person.proto这样做的好处是,生成规则直接和相关代码放在一起,后来接手的人不必再去文档或脚本里翻命令。
生成 Mock 测试代码
接口一多,测试替身代码就会迅速变成重复劳动。可以通过类似下面的方式自动生成:
//go:generate mockgen -source=foo.go -package=mock -destination=foo_mock.go相比手写 Mock,实现一致性更高,也能减少接口变更后测试代码不同步的问题。
生成数据库 CRUD 模板代码
如果项目里有大量结构相近的模型,基础的增删改查代码也可以交给生成器处理。常见做法是先写一个项目内部的小工具,再由 go generate 调用它:
//go:generate go run crudgen.go这里的重点不在于“把所有数据库逻辑都生成掉”,而是在重复度高、规则稳定的那一层减少样板代码。
生成 API 文档
如果团队使用 Swagger 一类工具,也可以把文档生成动作纳入同一套机制:
//go:generate swagger generate spec -o ./swagger.json这样接口定义更新后,文档生成路径也更固定,避免“代码变了,文档忘了更新”的情况。
项目里怎么用,才不会把流程搞复杂
go generate 很好用,但真正决定体验的,往往不是命令本身,而是你如何把它纳入团队协作。
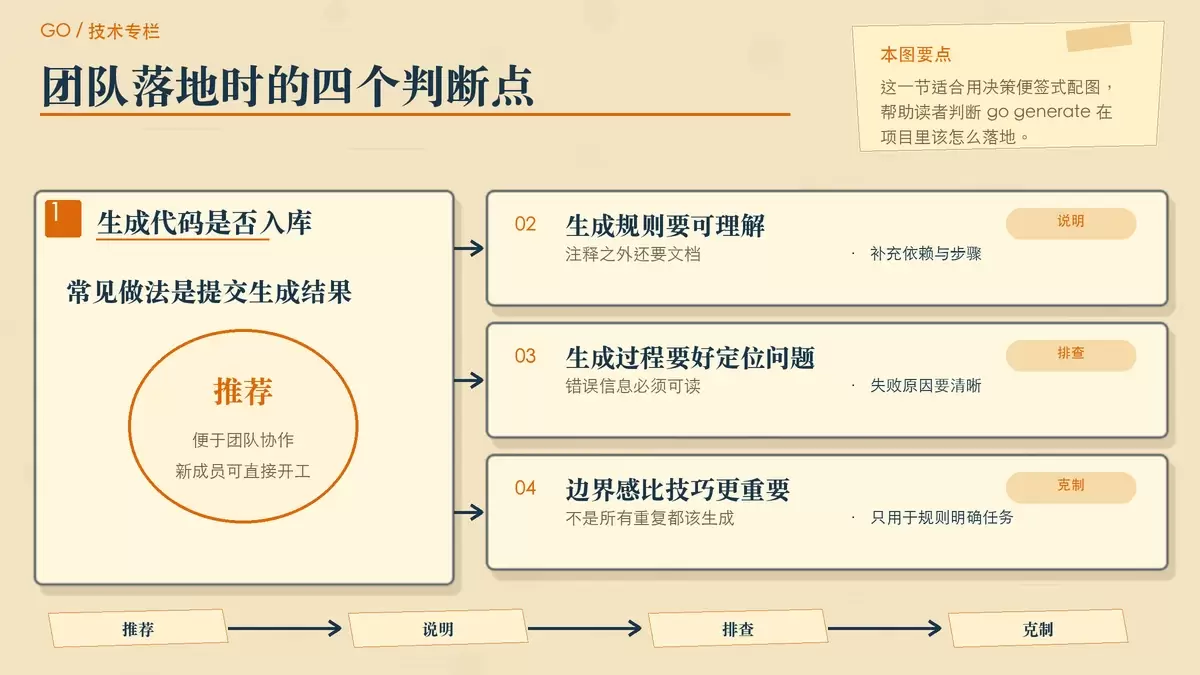
生成代码要不要纳入版本控制
通常有两种策略:
- 纳入版本控制:团队成员拉下代码就能直接工作,结果也更一致
- 不纳入版本控制:仓库更干净,但要求生成过程足够简单、稳定、可复现
对大多数团队项目来说,更常见也更稳妥的做法是把生成结果纳入版本控制。这样新成员即使暂时不了解生成链路,也不会一上来就卡在环境配置上。
把生成规则写清楚
当生成命令开始依赖额外工具、参数或多个步骤时,单靠一行注释往往不够。最好在项目说明里补充这些命令依赖什么、什么时候需要重新生成、生成失败该检查哪些前置条件。
文档的作用不是替代 //go:generate,而是把“为什么这么生成”和“团队怎么使用”说清楚。
给生成过程留下可排查的错误信息
如果你调用的是自定义脚本或内部生成器,错误输出必须可读。生成失败时,开发者首先需要知道是命令没装、参数不对、输入文件出错,还是生成器本身异常。
这一步看似琐碎,但它直接决定了 go generate 在团队里是“省事工具”还是“额外负担”。
不要把它用成新的复杂度来源
并不是所有重复代码都值得生成。若某段逻辑变化频繁、生成规则并不稳定,或者生成出来的代码反而难读难维护,那就不一定适合交给 go generate。
简单说,适合它的任务通常满足三个条件:重复、规则明确、手写成本高于维护生成流程的成本。超出这个边界,就容易得不偿失。
善用环境变量提高脚本适配性
go generate 提供了一些常用环境变量,可以让命令写得更灵活:
$GOARCH:体系架构$GOOS:操作系统$GOFILE:当前文件名$GOPACKAGE:当前包名
当你希望脚本根据当前文件或当前包自动处理输入输出时,这些变量会很有用。
两个容易忽略但很实用的细节
多个指令会按出现顺序执行
如果同一个文件里有多条生成指令,它们会按源码中出现的先后顺序运行:
//go:generate echo "第一步"
//go:generate echo "第二步"
这意味着你可以把有依赖关系的步骤排好顺序,但也要避免把流程写得过长,免得一个入口承担太多职责。
用 -run 做选择性执行
当项目里已经有很多生成命令时,不一定每次都全量执行。你可以通过 -run 只运行匹配某个模式的命令:
go generate -run "protoc" ./...这在只更新 Protobuf、只刷新某类代码时尤其方便,也更适合接入局部开发流程。
完整示例:从声明枚举到生成可读输出
下面这个例子把前面的思路串起来了:
// main.go
package main

import "fmt"

//go:generate stringer -type=Pill -linecomment
type Pill int

const (
    Placebo Pill = iota
    Aspirin
    Ibuprofen
    Paracetamol
)

func main() {
    fmt.Println("Pill types:", Placebo, Aspirin, Ibuprofen, Paracetamol)
}
运行 go generate 之后,再执行:
go run main.go pill_string.go这时输出的枚举值就不再只是数字,而会带上更有意义的字符串表示。这个例子看起来不大,却很能体现 go generate 的典型价值:把固定、机械、容易漏的工作交给工具,把人的注意力留给业务逻辑本身。
什么时候该用它
go generate 并不是构建系统,也不是包治百病的自动化入口。它最适合解决的是源码旁边那些清晰、重复、可生成的工作:枚举辅助方法、协议代码、测试替身、文档产物,都是典型例子。
如果你已经开始反复手写同一类样板代码,或者每次更新定义文件都要重复敲一遍命令,那么就该认真考虑把这件事交给 go generate。用得克制,它会明显提高项目的一致性和开发效率。















