



在 Go 里,很多人第一次真正用到 rune,往往不是因为语法本身,而是因为字符串一碰到中文就“按不准”了:len 算出来的是字节数,截取时也容易把一个完整字符切坏。要弄清这些现象,关键就是把 string、byte 和 rune 放到同一套语境里理解,再看它们各自适合处理什么问题。
这篇文章会从 rune 的定义讲起,接着说明它和字符串之间的转换方式,以及它与 byte 的区别。看完之后,你可以判断什么时候该按字节处理,什么时候必须切到 []rune,尤其是在中文、日文、emoji 等多字节文本场景下更容易做对。
什么是 rune,为什么它在多语言文本里重要
rune 是 Go 的内置类型之一,占用 4 个字节,通常用来表示一个 Unicode 字符。它本质上是 int32 的别名,因此在类型等价关系上和 int32 没有区别,只是语义上专门拿来表示“字符值”。
// rune is an alias for int32 and is equivalent to int32 in all ways. It is
// used, by convention, to distinguish character values from integer values.
type rune = int32这里最容易混淆的一点是:rune 处理的是“字符”,而不是“字节”。Go 的字符串底层是字节序列,默认按 UTF-8 编码保存 Unicode 文本,所以英文字符通常只占 1 个字节,但中文、日文甚至 emoji 往往不止 1 个字节。也正因为如此,按字节操作字符串和按字符操作字符串,经常会得到不同结果。
如果只是处理纯英文文本,这种差别可能不明显;但一旦进入多语言场景,rune 的价值就会立刻体现出来。
rune 如何定义和使用
rune 用来表示单个 Unicode 字符。Go 里字符和字符串的写法不同:字符串使用双引号,字符使用单引号。
package main

import (
    "fmt"
    "unsafe"
)

func main() {
    var a rune = 'a'
    var b rune = '你'
    fmt.Printf("a=%d, size=%dn", a, unsafe.Sizeof(a)) // output: a=97, size=4
    fmt.Printf("b=%d, size=%dn", b, unsafe.Sizeof(b)) // output: b=20320, size=4
}
这段代码说明了两件事:
'a'和'你'都可以赋给rune,因为它表示的是单个字符。- 无论字符本身显示出来是英文还是中文,
rune自身的存储大小都是4个字节。
输出里的 97 和 20320,本质上是这些字符对应的 Unicode 码点值。也就是说,rune 不是“字符图片”,而是字符在 Unicode 体系中的整数表示。
string 和 []rune 如何互转,长度为什么会不同
字符串由多个字符组成,而 Go 可以用 []rune 切片来表示“一个个字符”的序列。string 和 []rune 之间可以直接相互转换:
package main

import "fmt"

func main() {
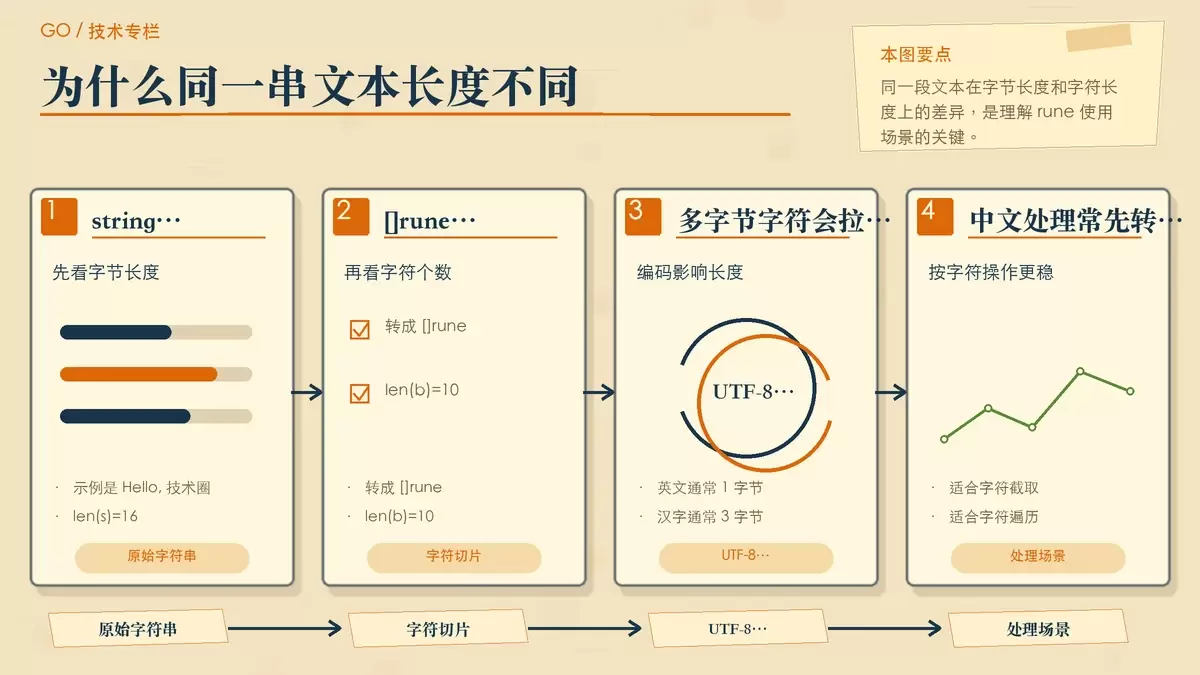
    s := "Hello, 技术圈"
    b := []rune(s)
    c := string(b)
    fmt.Printf("%v, len=%dn", s, len(s))
    // output: Hello, 技术圈, len=16

    fmt.Printf("%v, len=%dn", b, len(b))
    // output: [72 101 108 108 111 44 32 25216 26415 22280], len=10

    fmt.Printf("%v, len=%dn", c, len(c))
    // output: Hello, 技术圈, len=16
}
这组结果正好能说明 Go 字符串处理中最关键的区别:
len(s)得到的是字符串的字节长度,因此这里是16。len([]rune(s))得到的是字符个数,因此这里是10。
在 UTF-8 编码下,一个汉字通常占 3 个字节,所以字符串 "Hello, 技术圈" 的字节长度是 16 = 5+1+1+9。其中前面的 Hello 是 5 个字母,逗号 1 个字节,空格 1 个字节,后面的 3 个汉字一共 9 个字节。
但转换成 []rune 后,统计的是字符数,因此长度变成 10 = 5+1+1+3。这时每个汉字只算 1 个字符,而不是 3 个字节。
这也是为什么处理中文字符串截取、反转、按字符遍历时,通常要先转成 []rune:因为你关心的是“字符边界”,不是底层字节边界。
string、byte、rune 到底是什么关系
如果把这三个类型拆开看,概念其实并不复杂。
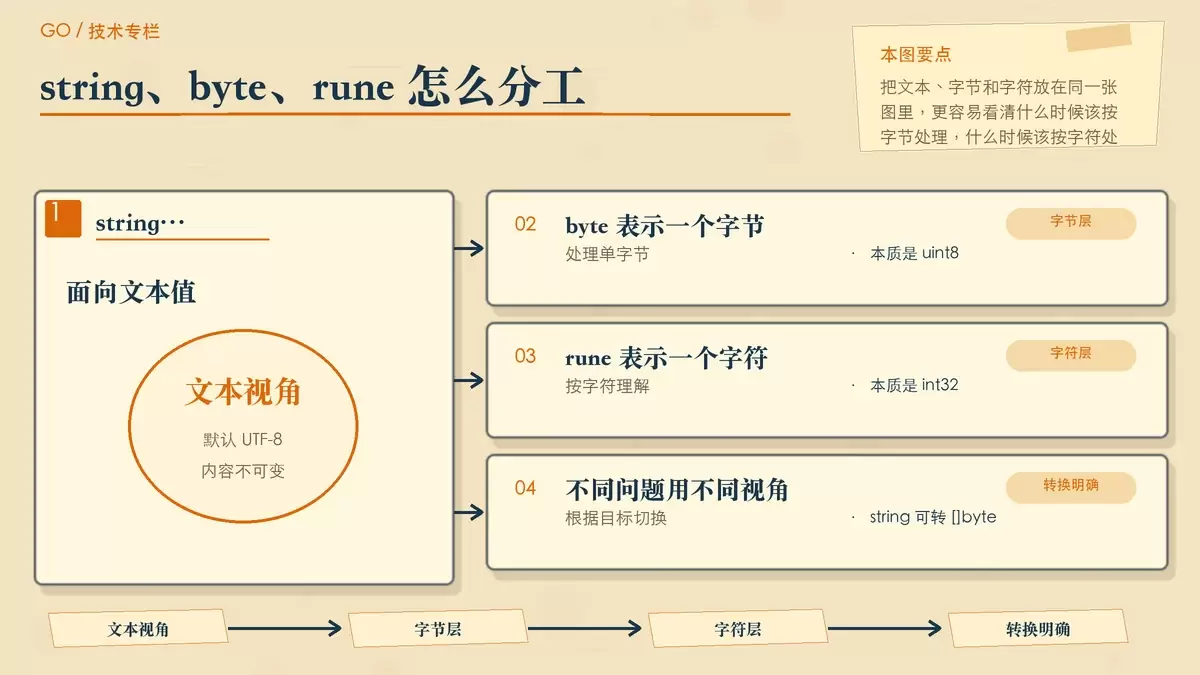
string 是 Go 中应用非常广泛的内置类型,可以理解为由多个字符组成的文本值。它默认以 UTF-8 编码存储 Unicode 字符,内容不可变;一旦要修改,通常意味着重新分配内存生成新的字符串。
byte 是 uint8 的别名,用来表示一个字节。它适合处理原始字节数据,也适合表示 ASCII 范围内的单字节字符。站在底层视角看,字符串本质上就是一段字节序列,因此很多场景会把字符串转成 []byte 来做传输、编码、IO 等操作。
rune 则是 int32 的别名,用来表示一个 Unicode 字符。对应到复数形式,[]rune 就是一串字符序列,它和 string 可以直接互相转换。
| 特性 | string | byte | rune |
|---|---|---|---|
| 本质 | 只读的[]byte | uint8 | int32 |
| 占用字节 | 固定长度 | 1个字节 | 4个字节 |
| 表示 | 字符串 | ASCII/单字节字符 | 多字节字符 |
用一句更实用的话概括:
- 处理网络数据、文件内容、二进制协议时,更常站在
[]byte视角。 - 处理中文、日文、emoji、按字符切分文本时,更常站在
[]rune视角。 - 展示和传递文本时,最终仍然通常回到
string。
哪些场景更适合用 rune
rune 并不是所有字符串问题都要上的默认工具,但在下面这些场景里,它通常比直接操作字符串或 []byte 更稳妥:
- 计算字符长度
- 安全的字符截取、反转等
- emoji 表情符号处理
- 处理多语言文本
- 字符串语法分析/解析器
这些场景的共同点在于:你的目标不是“第几个字节”,而是“第几个字符”。一旦对象里包含多字节字符,直接按字节切片就可能得到半个字符,结果轻则显示异常,重则产生乱码或逻辑错误。
尤其在做输入处理、编辑器、命令行工具、文本解析器时,这种区别非常关键。只要业务规则是围绕字符而不是字节定义的,rune 往往就是更合适的抽象。
为什么 Go 需要 rune
Go 之所以需要 rune,根本原因在于字符串本身是字节序列,而 Unicode 世界里的很多字符并不是 1 个字节就能表示。中文、日文、emoji 等内容如果只按普通字符串或 []byte 去理解,处理起来就会很别扭。
因此,Go 用 rune 表示单个字符,用 []rune 表示字符序列,让开发者在处理多语言文本时可以绕开字节层面的干扰,更自然地按字符思考和操作。
简单记住一句就够了:当你关心的是存储、传输和底层数据,优先看 byte;当你关心的是字符本身,尤其是中文等多字节文本,优先考虑 rune。















