


Python3正则表达式(RE)核心用法与实战详解

本文详细总结Python3中正则表达式模块re的核心用法。涵盖单字符与数量匹配规则、原始字符串raw在避免转义冲突中的应用、边界匹配技巧,以及分组、分组引用和命名分组的实战案例。通过手机号验证、数字范围匹配及HTML标签提取等示例,帮助开发者掌握正则表达式在爬虫与数据清洗中的关键技能。
Python3正则表达式入门与模块引入
1. 引入正则表达式模块
在Python3中使用正则表达式功能前,必须首先导入内置的re模块。
import re #引入正则表达式2. 核心方法:match(),用于从左至右进行匹配
#pattern 为要校验的规则
#str 为要进行校验的字符串
result = re.match(pattern, str)

#如果result不为None,则group方法则对result进行数据提取
正则表达式基础语法:单字符与量词
3. 正则表达式基础语法
1️⃣ 单字符匹配规则
字符 功能
.  匹配任意1个字符(除了\n)
[]  匹配[]中列举的字符
\d  匹配数字,也就是0-9
\D  匹配非数字,也就是匹配不是数字的字符
\s  匹配空白符,也就是 空格\tab
\S  匹配非空白符,\s取反
\w  陪陪单词字符, a-z, A-Z, 0-9, _
\W  匹配非单词字符, \w取反
2️⃣ 量词与数量表示规则
字符 功能
*  匹配前一个字符出现0次多次或者无限次,可有可无,可多可少
+  匹配前一个字符出现1次多次或则无限次,直到出现一次
?  匹配前一个字符出现1次或者0次,要么有1次,要么没有
{m}  匹配前一个字符出现m次
{m,} 匹配前一个字符至少出现m次
{m,n} 匹配前一个字符出现m到n次
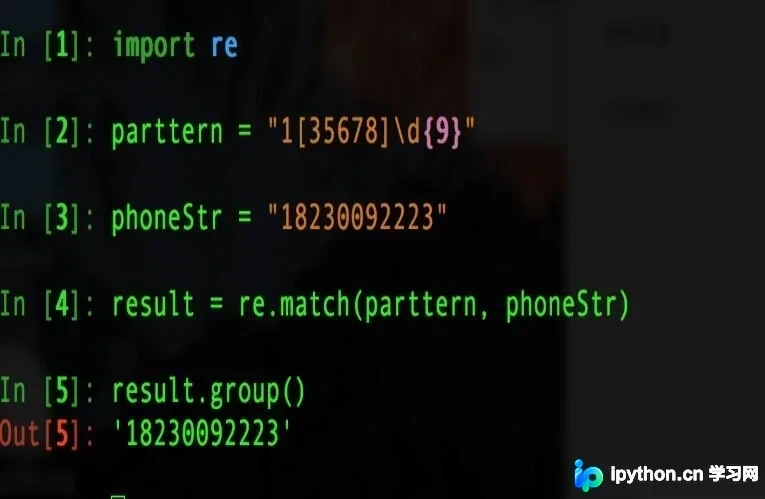
示例一:验证手机号码格式(暂不考虑边界限制)
#首先清楚手机号的规则
#1.都是数字 2.长度为11 3.第一位是1 4.第二位是35678中的一位

pattern = "1[35678]\d{9}"
phoneStr = "18230092223"

result = re.match(pattern, phoneStr)
result.group()

#执行结果如下图:
原始字符串raw在正则中的应用
4. 原始字符串raw,先看如下实例:
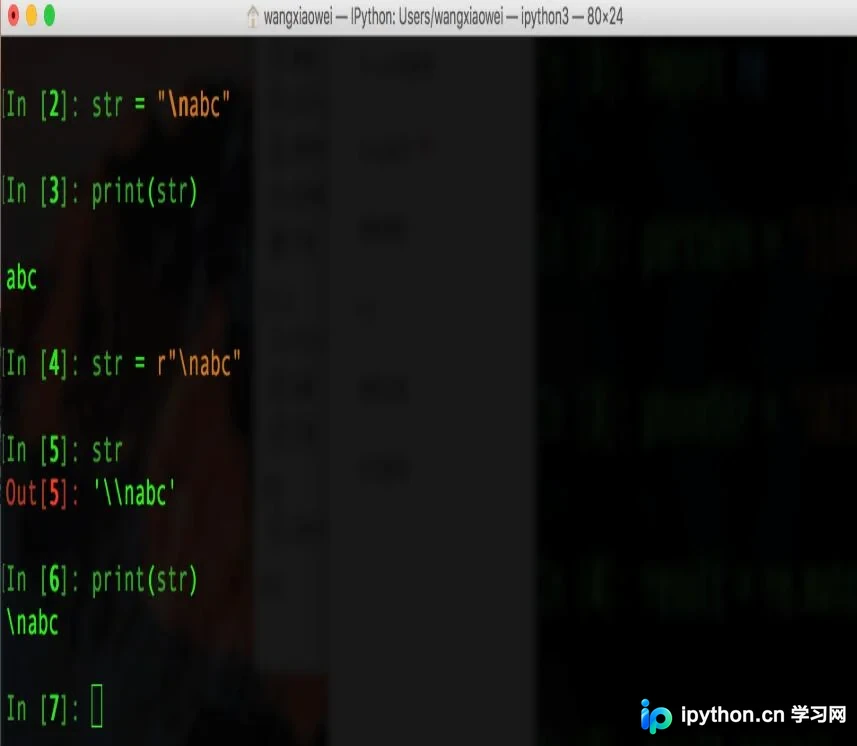
如上图所示,在字符串赋值"\nabc"前添加前缀"r"后,Python解释器会保留该字符串的原始形式,即在"\nabc"前额外添加一个反斜杠"\"。
这使得在打印变量str时,能够直接输出原始字符串的值"\nabc",而不将\n解析为换行符。
示例二:原始字符串在正则表达式中的应用
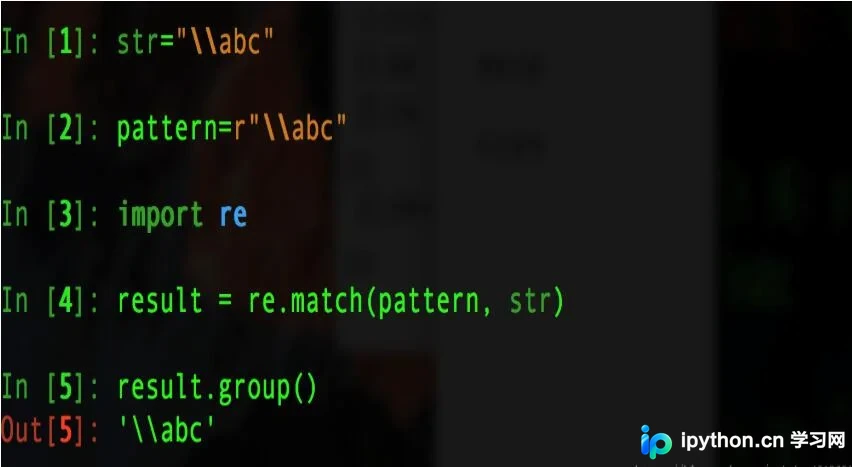
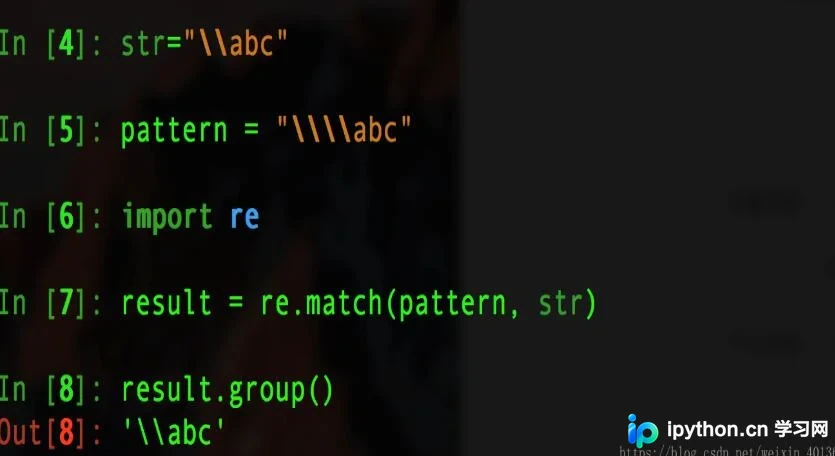
若不使用原始字符串前缀r,则需要手动为pattern中的每个反斜杠添加双倍的"\"以抵消转义字符的影响,操作较为繁琐。
使用r前缀定义原始字符串后,无需再处理字符串转义问题,从而能更专注于字符匹配逻辑本身。
边界匹配与分组技术实战
5. 边界匹配规则
字符 功能
^  匹配字符串开头
$  匹配字符串结尾
\b  匹配一个单词的边界
\B  匹配非单词边界
示例三:利用边界规则匹配字符串str="ho ve r"
import re

#定义规则匹配str="ho ve r"
#1. 以字母开始
#2. 中间有空字符
#3. ve两边分别限定匹配单词边界

pattern = r"^\w+\s\bve\b\sr"
str = "ho ve r"
result = re.match(pattern, str)
result.group()
6. 匹配分组与引用
字符  功能
|   匹配左右任意一个表达式
(ab)  将括号中字符作为一个分组
\num  引用分组num匹配到的字符串
(?P<name>) 分组起别名
(?P=name) 引用别名为name分组匹配到的字符串
示例四:匹配0到100之间的数字
import re

#匹配出0-100之间的数字
#首先:正则是从左往又开始匹配
#经过分析: 可以将0-100分为三部分
#1. 0  "0$"
#2. 100  "100$"
#3. 1-99  "[1-9]\d{0,1}$"
#所以整合如下

pattern = r"0$|100$|[1-9]\d{0,1}$"
#测试数据为0,3,27,100,123
result = re.match(pattern, "27")
result.group()

#将0考虑到1-99上,上述pattern还可以简写为:pattern=r"100$|[1-9]?\d{0,1}$"
#测试结果如下图: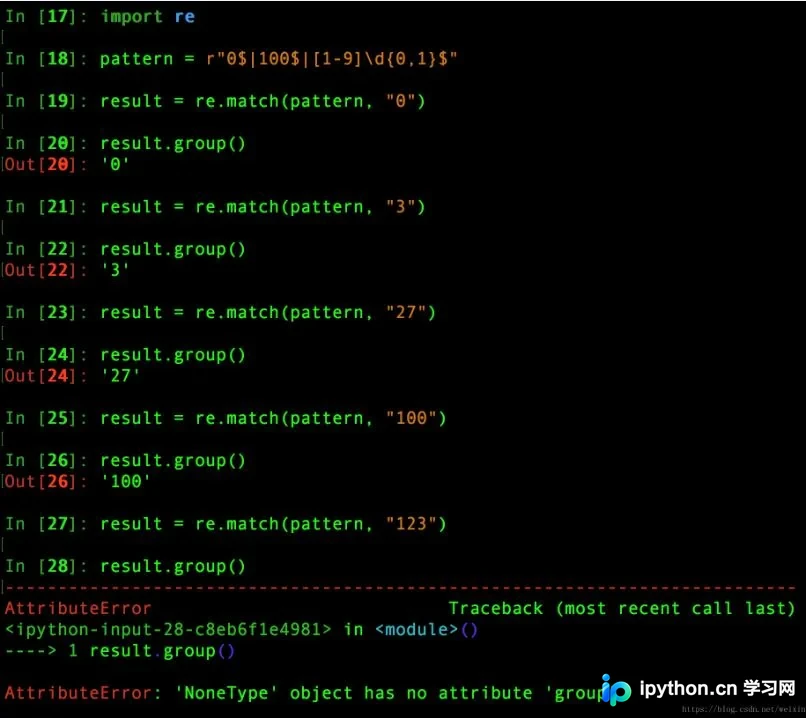
示例五:利用分组提取页面中<h1>标签内的内容
import re
#匹配分组,获取页面<h1>标签中的内容, 爬虫的时候会用到

str = "<h1>hello world!<h1>"
pattern = r"<h1>(.*)</h1>"
result = re.match(pattern, str)
result.group()

#执行如下图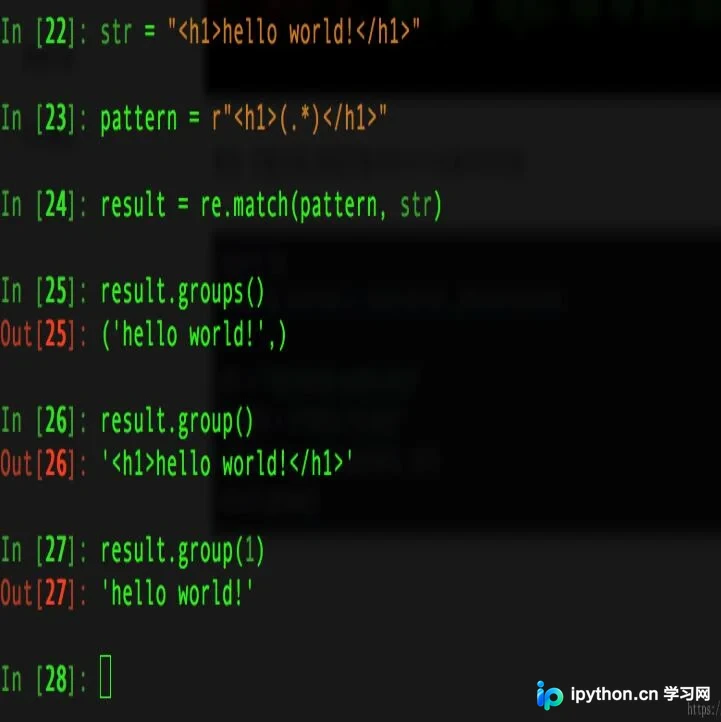
示例六:利用分组引用精确获取多层嵌套标签内的内容
import re

#引用分组,精确获取多个标签内的内容
#"\1"是对第一个分组的引用,同理......

str = "<span><h1>hello world!</h1></span>"
pattern = r"<(.+)><(.+)>.*</\2></\1>"
result = re.match(pattern, str)
result.groups()

#执行如下图: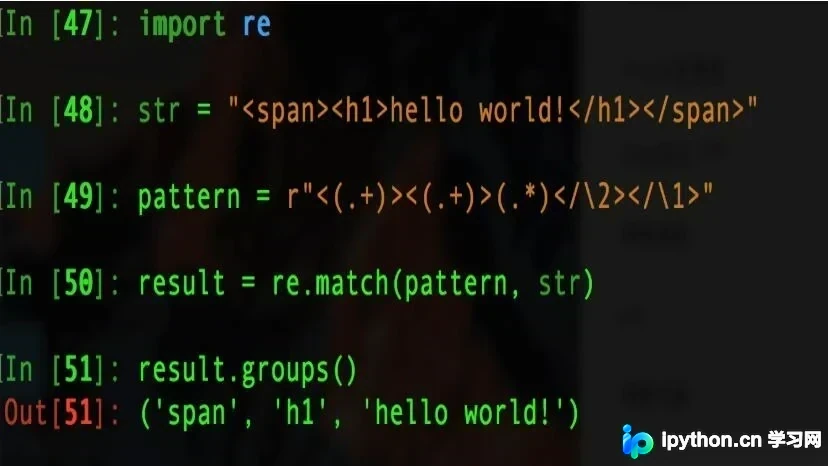
示例七-2:为分组设置别名
import re

#分组起别名

str = "<span><h1>hello world!</h1></span>"
pattern = "<(?P<key1>.+)><(?P<key2>.+)>(?P<nr>.*)</(?P=key2)></(?P=key1)>"
result = re.match(pattern, str)
result.groups()

#执行如下图: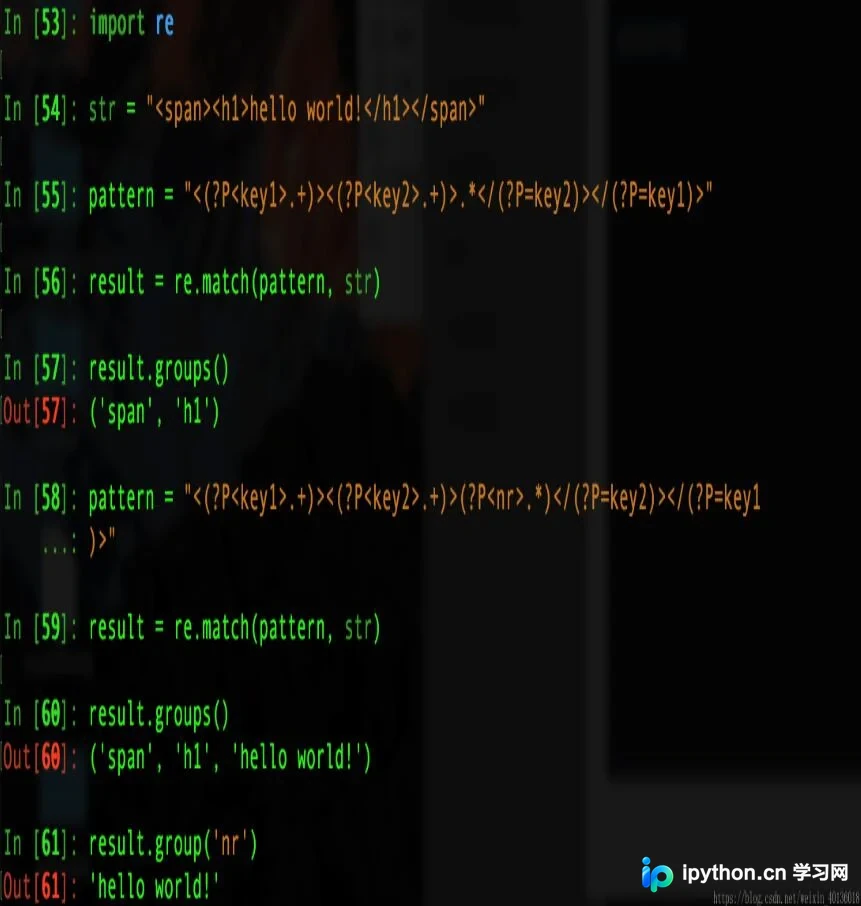
以上关于Python3中正则表达式(RE)的详细总结即为全部内容,希望能对读者有所帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















