


pandas DataFrame append方法详解与使用示例

本文详细介绍pandas库中DataFrame的append方法,涵盖其函数签名、核心参数如ignore_index和verify_integrity的作用。通过字典、Series及列表三种数据结构的添加示例,演示如何处理索引冲突及列名扩展,帮助开发者高效进行数据合并操作。
append方法概述与参数说明
参考官方文档中关于append方法的详细介绍链接。
DataFrame.append(other, ignore_index=False, verify_integrity=False, sort=None)
该方法的主要功能是向现有的DataFrame对象中追加新行。若新数据中包含原DataFrame中不存在的列名,系统会自动将这些列名作为新列加入。
- 参数other支持多种数据结构,包括DataFrame、Series、字典(dict)或列表(list)。
- ignore_index参数默认为False。若设置为True,则忽略原有索引标签,生成新的整数索引。
- verify_integrity参数默认为False。若设置为True,当生成的索引与现有索引发生冲突时,将抛出ValueError异常。
- sort参数为布尔值,默认值为None。此属性仅在pandas 0.23.0及以上版本中可用。
添加字典数据示例
接下来演示如何使用append方法添加字典数据。
import pandas as pd

  data = pd.DataFrame()
  a = {"x":1,"y":2}
  data = data.append(a,ignore_index=True)
  print(data)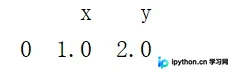
添加Series数据示例
随后展示如何添加Series类型的数据。
若未设置ignore_index=True,程序会报错并提示TypeError: Can only append a Series if ignore_index=True or if the Series has a name。若希望避免此错误,可将代码调整为设置ignore_index=True的形式。
 import pandas as pd

  data = pd.DataFrame()
  series = pd.Series({"x":1,"y":2},name="a")
  data = data.append(series)
  print(data)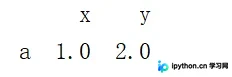
需要注意的是,当使用append方法添加Series时,必须指定name属性。同时,name的名称将作为生成索引的名称。
添加列表数据及索引处理
接下来介绍如何添加列表(list)数据。
data = pd.DataFrame()
  a = [1,2,3]
  data = data.append(a)
  print(data)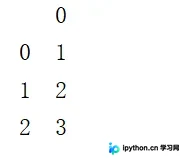
如果list是一维的,则是以列的形式来进行添加,如果list是二维的则是以行的形式进行添加的,若列表为三维结构,则仅添加一个值。
  data = pd.DataFrame()
  a = [[[1,2,3]]]
  data = data.append(a)
  print(data)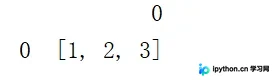
注意:在多次使用append方法追加数据的时候,可能会出现相同的index
 data = pd.DataFrame()
  a = [[1,2,3],[4,5,6]]
  data = data.append(a)
  a = [[7,8,9],[10,11,12]]
  data = data.append(a)
  print(data)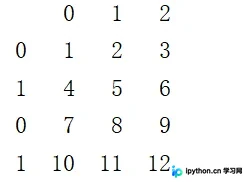
若希望追加后的索引不出现重复,可以通过设置ignore_index=True参数来避免索引冲突。
  data = pd.DataFrame()
  a = [[1,2,3],[4,5,6]]
  data = data.append(a,ignore_index=True)
  a = [[7,8,9],[10,11,12]]
  data = data.append(a,ignore_index=True)
  print(data)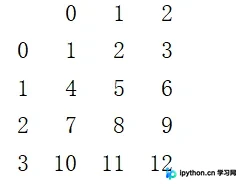
以上内容为本文的全部介绍,希望对读者的学习有所帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















