


Python数据分析:使用Pandas进行相关分析详解

发布时间:2026-10-13 |
3人浏览过
本文介绍Python中利用Pandas库进行相关分析的方法。重点讲解DataFrame.corr()与Series.corr()函数的区别与返回值类型,阐述皮尔逊相关系数r在衡量变量线性关系中的应用,包括正负相关判定及r=0的含义。
相关分析概述
相关分析(correlation analysis)
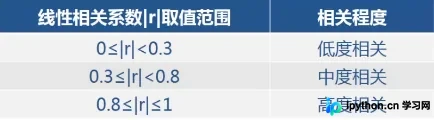
这是一种用于研究两个或多个随机变量之间相互依存关系方向及密切程度的统计方法。在量化线性相关关系时,主要采用皮尔逊(Pearson)相关系数r来度量连续变量间的线性相关强度。当r>0时,表示变量间存在线性正相关;当r<0时,表示存在线性负相关;当r=0时,说明两个变量之间不存在线性关系,但这并不意味着变量间完全没有任何其他形式的关系。
Pandas相关分析函数用法
相关分析函数 DataFrame.corr() Series.corr(other)
函数说明: 当由数据框(DataFrame)调用corr函数时,系统将计算该数据框中每一列与其他各列之间的相似度(即相关系数矩阵)。 当由序列(Series)调用corr方法时,仅计算该特定序列与传入的另一个序列之间的相关度。
返回值: 若由DataFrame调用,返回值为一个新的DataFrame对象,包含各列间的相关系数。
若由Series调用,返回值为一个数值型标量,其大小即为两个序列间的相关度系数。
import numpy
import pandas

data = pandas.read_csv(
  'C:/Users/ZL/Desktop/Python/5.4/data.csv'
)

bins = [
  min(data.年龄)-1, 20, 30, 40, max(data.年龄)+1
]
labels = [
  '20岁以及以下', '21岁到30岁', '31岁到40岁', '41岁以上'
]

data['年龄分层'] = pandas.cut(
  data.年龄,
  bins,
  labels=labels
)

ptResult = data.pivot_table(
  values=['年龄'],
  index=['年龄分层'],
  columns=['性别'],
  aggfunc=[numpy.size]
 File "<ipython-input-1-ae921a24967f>", line 25
  aggfunc=[numpy.size]
            ^
SyntaxError: unexpected EOF while parsing


import numpy
import pandas

data = pandas.read_csv(
  'C:/Users/ZL/Desktop/Python/5.4/data.csv'
)

bins = [
  min(data.年龄)-1, 20, 30, 40, max(data.年龄)+1
]
labels = [
  '20岁以及以下', '21岁到30岁', '31岁到40岁', '41岁以上'
]

data['年龄分层'] = pandas.cut(
  data.年龄,
  bins,
  labels=labels
)

ptResult = data.pivot_table(
  values=['年龄'],
  index=['年龄分层'],
  columns=['性别'],
  aggfunc=[numpy.size]
)

ptResult
Out[4]:
     size
      年龄
性别     女   男
年龄分层
20岁以及以下  111  1950
21岁到30岁 2903 43955
31岁到40岁  735  7994
41岁以上   567  886
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















