


Python自动登录淘宝并持久化Cookie的完整实现方案

本文详细讲解如何使用Python Requests库模拟登录淘宝,并重点介绍2.0版本新增的Cookie持久化功能。通过序列化与反序列化技术,实现登录状态的文件保存与自动读取,避免每次运行重新登录。文章涵盖四步登录法、代码重构及完整的测试流程,适用于需要长期维持登录状态的爬虫开发场景。
引言与版本迭代概述
此前已介绍过利用requests库模拟登录淘宝的基础方法,本文将在此基础上进行功能扩展。我们将原有版本标记为1.0,而本次优化后的版本称为2.0。版本迭代的核心在于功能升级,接下来我们将对比1.0与2.0版本的具体差异,并详细解析2.0版本的改进之处。
1.0版本:四步登录法详解
1.0版本实现步骤
首先回顾模拟登录淘宝的基本流程,参考淘宝登录的详细时序图以理解交互过程。
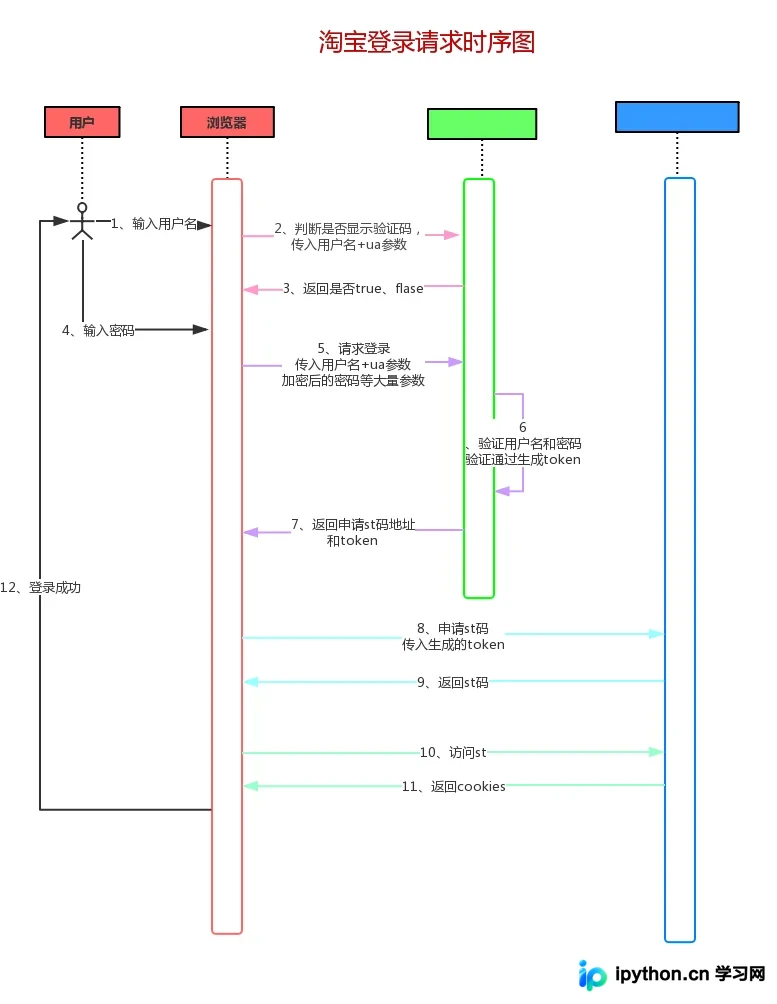
该请求流程展示了淘宝登录的标准路径,代码模拟时虽无需完全细分步骤,但依据封装思想,可将整个登录过程整合为四个核心方法,具体结构可参考相关图示。
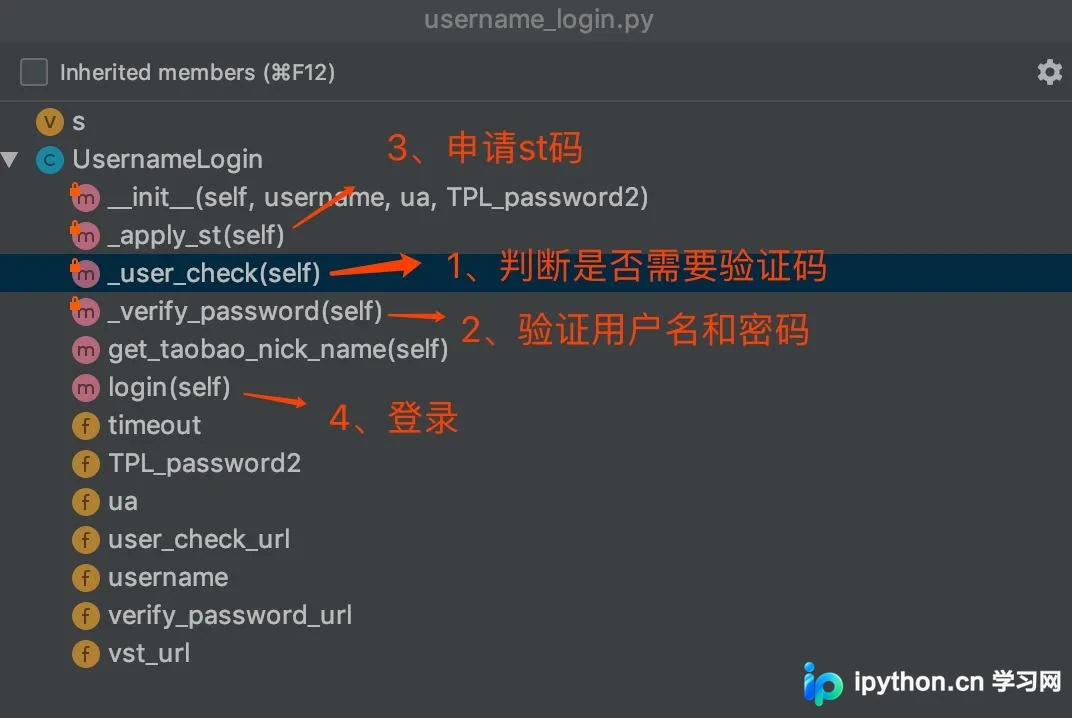
为帮助理解四步登录法,此处提供对应的流程图说明。
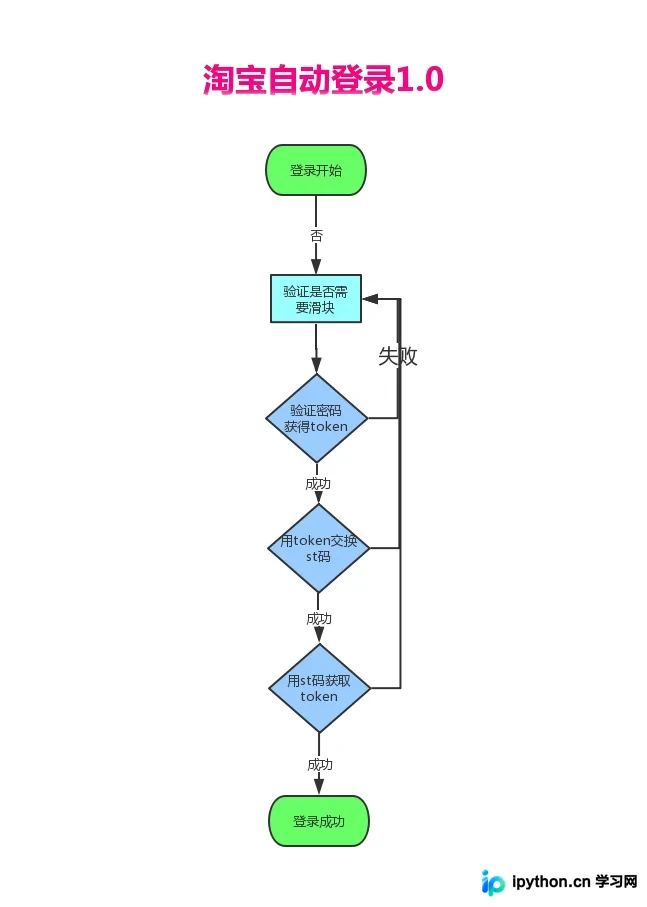
结合流程图,简要说明这四步的具体操作内容。
- 使用用户名向淘宝(taobao.com)发起POST请求,检测是否触发滑块验证。
- 再次向淘宝(taobao.com)发起POST请求,验证用户名和密码的正确性;若验证通过,服务器将返回一个token。
- 利用获取到的token,向阿里巴巴(alibaba.com)请求交换st码。
- 获取st码后,利用该st码获取cookies,至此登录流程完成。
在面试场景中,若被问及是否爬取或自动登录过淘宝及具体流程,可依据此四步登录法进行阐述。这不仅展示技术能力,更能体现严谨的逻辑思维,从而获得面试官的认可。
2.0版本:Cookie持久化功能设计
2.0版本新增功能
开发2.0版本的初衷源于实际爬取淘宝商品时的痛点:1.0版本在程序运行结束后,登录产生的cookies会丢失,导致每次重启程序都需重新执行登录操作。
鉴于浏览器具备保存cookies的功能,自然联想到采用序列化技术来持久化存储cookies。
序列化(Serialization)是指将对象的状态信息转换为可存储或传输形式的过程。——百度百科
简而言之,序列化是将内存中的对象持久化保存到文件的过程。程序运行结束后,内存释放会导致所有对象和变量消失,而序列化可将这些数据保存至文件。即使程序关闭,下次启动时也可读取文件并反序列化为对象继续使用,该过程称为反序列化。
因此,2.0版本的核心功能是:将登录后的cookies保存至文件,并在后续登录时优先从文件读取cookies。这意味着新增了一个保存cookies的功能,具体流程可参考2.0版本的流程图。
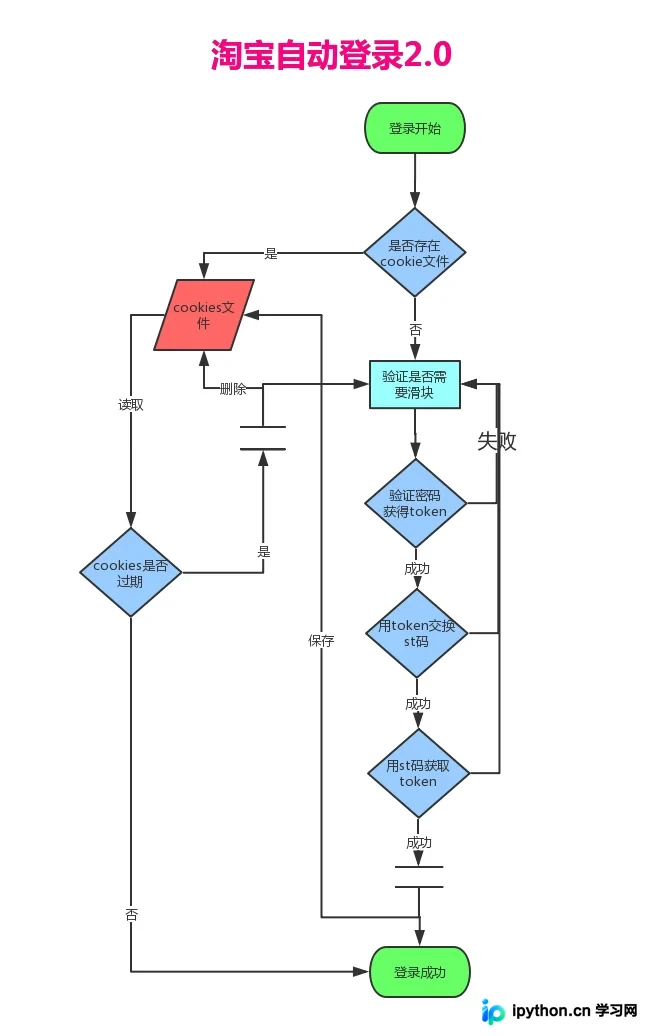
与1.0版本相比,2.0版本主要增加了左侧的cookies文件存储及文件校验环节,这也是本文重点讲解的内容。
尽管新增功能看似简单,但其意义重大:掌握此方法后,可将其应用于所有需要登录的场景,实现cookies的序列化保存,甚至构建cookies池。
2.0版本代码实现与重构
2.0版本新功能实现
根据上述流程图,对新增的cookies保存功能进行量化分析。
保存cookies:新增一个方法,在利用st码登录成功后,将cookies对象转换为文件进行存储。
读取cookies:新增一个方法,用于从文件中读取cookies数据,并将其转换为cookies对象。
检查cookies:新增一个方法,用于判断cookies是否失效。若失效则删除cookies文件;若有效,则直接利用现有cookies登录成功。
基于以上三个步骤,即可开始编写相关代码。
1.保存cookies
保存cookies本质上即为序列化操作,首先展示相关代码实现。
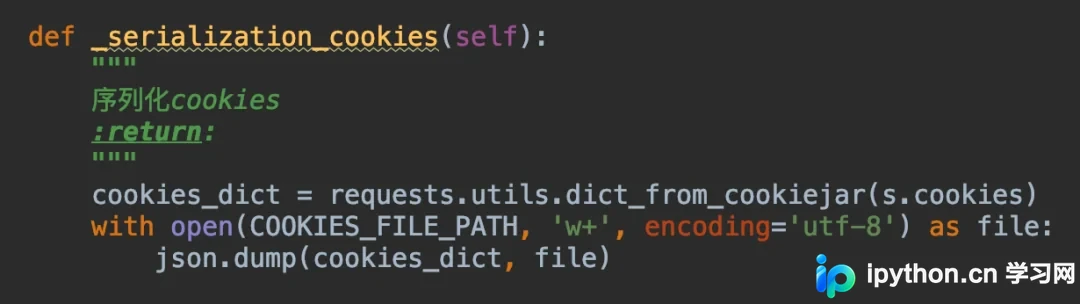
首先获取当前cookies,将其转换为dict对象,最后将dict对象转化为JSON格式并保存至文件。
2.读取cookies
读取cookies是将文件数据转换为cookies对象的过程,此步骤称为反序列化,具体代码如下。
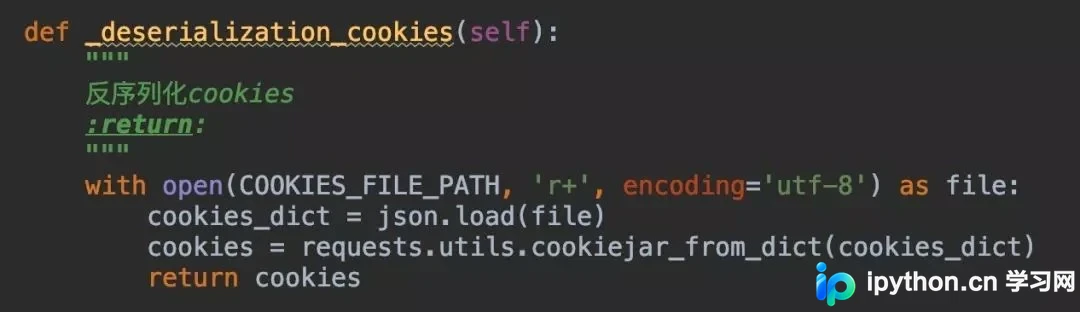
反序列化过程与序列化相反:先将文件数据转换为dict对象,再转换为cookies对象,最后赋值给Session对象。
3.检查cookies
此步骤需先判断cookies文件是否存在。若存在,则读取cookies并访问淘宝主页以验证有效性;若访问失败,说明cookies已过期,此时应删除cookies文件。
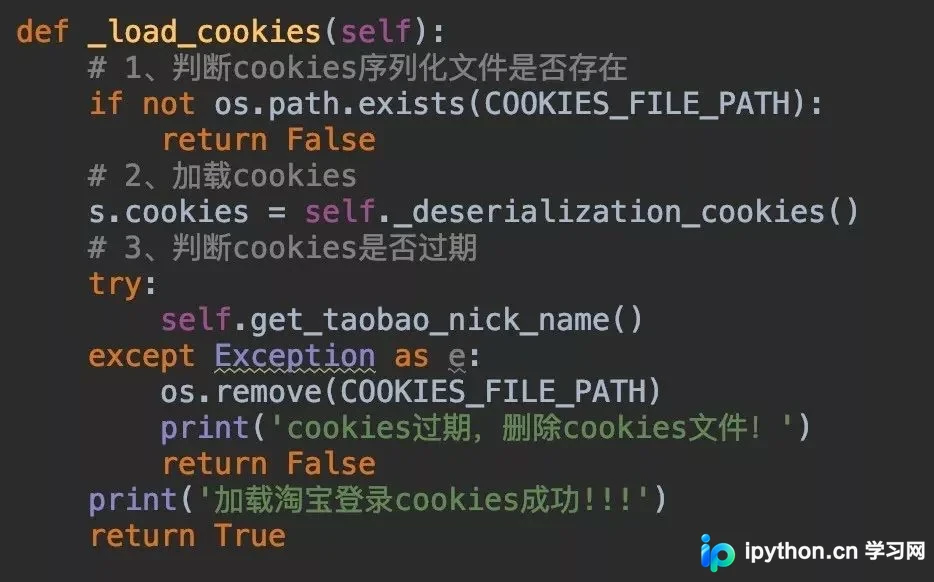
重构代码
功能点实现后,需对代码进行重构。根据流程图,需在方法开头增加加载cookies的逻辑,并在登录成功后增加保存cookies的方法。因此,主要改动仅涉及两处。
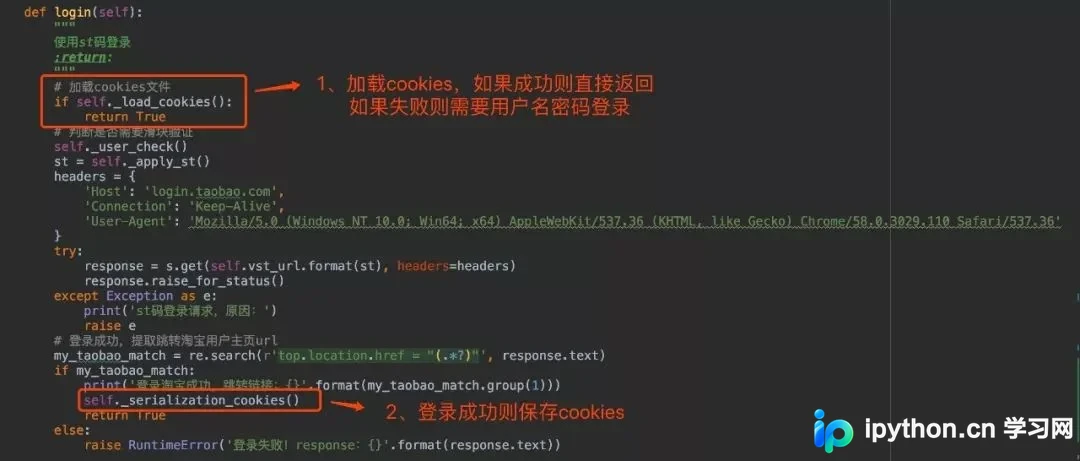
功能测试与发布流程
功能测试
在实际开发中,测试至关重要。通常需先进行自测,若未自测直接提交测试,不仅可能遭受批评,还可能影响绩效考核。
以下介绍序列化cookies功能的自测流程。
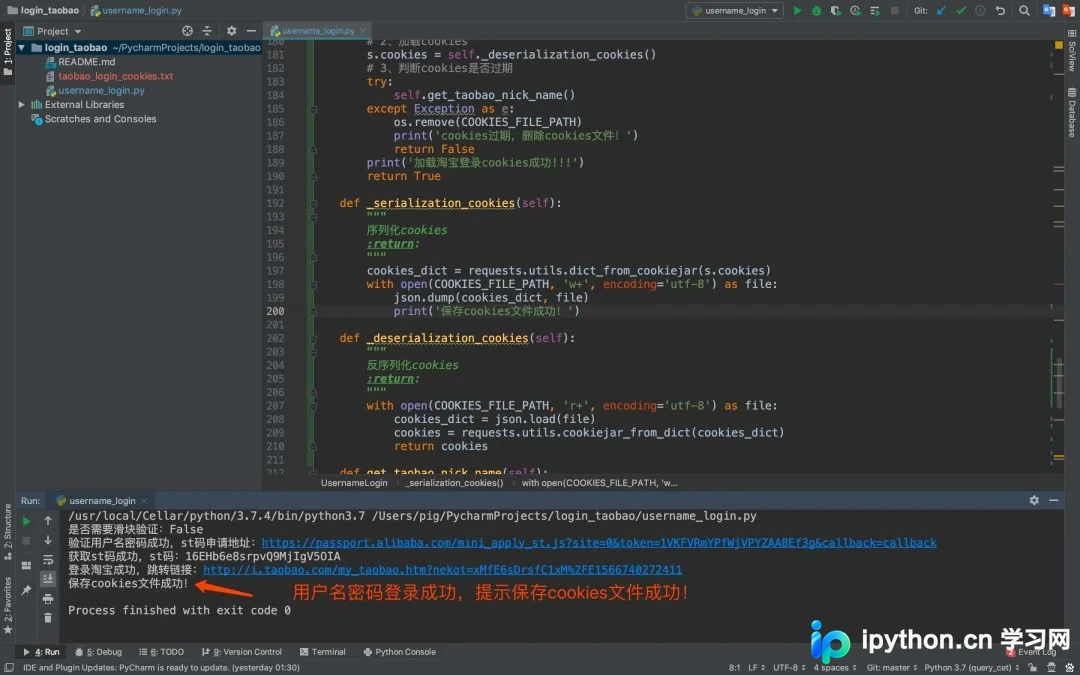
首先执行登录操作,验证登录成功后是否会将cookies保存为文件,此步骤用于测试序列化功能。
接着再次执行登录,通过打印信息确认是否直接读取cookies文件进行登录,此步骤用于测试反序列化功能。
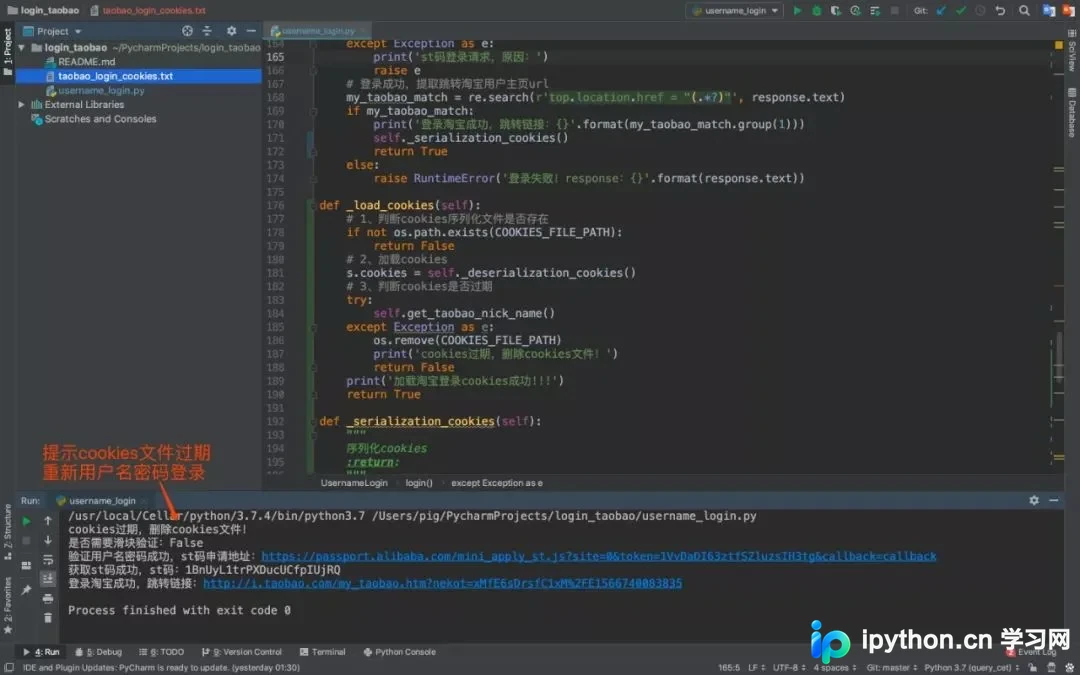
最后测试cookies过期场景:验证系统是否会删除cookies文件,并重新使用用户名和密码登录,最终保存新的cookies文件。
1.测试正常登录
首次登录时不存在cookies文件,因此需正常使用用户名和密码登录,登录成功后保存cookies文件。
2.测试加载cookies登录
在正常登录并保存cookies文件后,需测试系统能否成功加载文件中的cookies。
3.测试cookies过期
所有cookies均有过期时间,经测试,淘宝登录的cookies有效期约为60分钟。cookies过期后,需重新登录并保存新的cookies文件。
至此,所有功能点均已通过自测,可提交给测试人员进行正式测试。测试通过后,先部署至预发环境,预发环境测试无误后,方可上线正式环境。
目前许多公司的发布策略为:小功能通常在白天发布,而大型改版则安排在深夜用户较少时段进行。
总结与展望
总结
本文介绍了如何保存登录信息,下期将讲解如何爬取淘宝商品信息并进行数据分析,内容十分有趣,值得期待。
看到许多同学在学习群中交流以往编写的案例,深感这些教程具有实际意义。看到大家积极学习,内心倍感欣慰。
源码地址:https://github.com/pig6/login_taobao
以上介绍了使用Python自动登录淘宝并保存登录信息的方法,希望对大家有所帮助。如有任何疑问,欢迎留言,小编会及时回复。感谢大家对本站的支持! 若本文对您有帮助,欢迎转载,请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















