


Python多线程爬虫实战:从单线程到线程池优化

发布时间:2026-10-15 |
4人浏览过
本文对比了Python单线程与多线程爬虫的性能差异,详细讲解了如何使用multiprocessing.dummy模块中的Pool类构建线程池。通过具体代码案例,展示了如何利用线程池处理阻塞型网络请求,从而显著缩短视频数据下载时间,适用于需要批量处理耗时操作的场景。
多线程与线程池的基本概念
在爬虫开发中,常涉及多线程或多进程方案(通常不推荐多进程)。其主要优势在于能够针对特定的阻塞操作单独开辟线程或进程,实现异步执行,从而避免主线程阻塞。然而,这种方式的局限性在于无法无限制地创建线程或进程,资源消耗较大。因此,最佳实践原则是:对于耗时且阻塞的操作,应统一交由线程池进行管理。
单线程与多线程代码对比
为了直观展示性能差异,首先提供一个单线程爬虫的基础示例:
import time

def get_page(str):
    print("正在下载:",str)
    time.sleep(2)
    print('下载成功:',str)

name_list = ['aa','bb','cc','dd']

start_time = time.time()

for i in range(len(name_list)):
    get_page(name_list[i])
end_time = time.time()
print('%d second'% (end_time-start_time))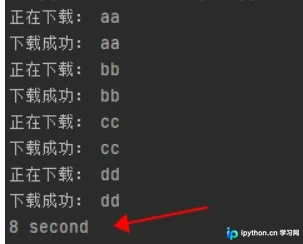
接着,我们引入多线程爬虫的实现方式,以对比效率提升:
import time
# 导入线程池模块对应的类
from multiprocessing.dummy import Pool

start_time = time.time()
def get_page(str):
    print("正在下载:",str)
    time.sleep(2)
    print('下载成功:',str)

name_list = ['aa','bb','cc','dd']

# 实例化一个线程池对象
pool = Pool(4)
# 将列表中每一个列表元素传递给get_page进行处理
pool.map(get_page,name_list)

end_time = time.time()
print(end_time-start_time)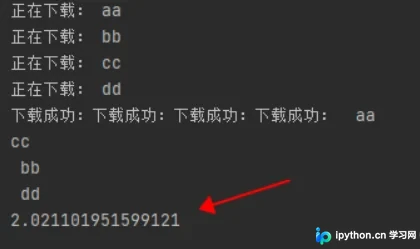
多线程爬虫完整实战案例
以下是一个完整的多线程爬虫应用案例,涵盖请求解析与数据下载:
# 多线爬虫示例
import requests
from lxml import etree
import re
from multiprocessing.dummy import Pool

headers = {
    'User-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:80.0) Gecko/20100101 Firefox/80.0',
    'Content-type':'application/json',
}
# 对下述url发起请求解析出视频详情页的url和视频的名称
url = "https://pearvideo.com/category_5"
page_text = requests.get(url=url,headers=headers).text
tree = etree.HTML(page_text)
li_list = tree.xpath('//ul[@id="listvideoListUl"]/li')
urls = [] #存储所有视频的链接
for li in li_list:
    detail_url = 'https://pearvideo.com/' + li.xpath('./div/a/@href')[0]
    name = li.xpath('./div/a/div[2]/text()')[0]+'.mp4'
    # 对详情页的url发起请求
    detail_page_text = requests.get(url=detail_url,headers=headers).text
    # print(detail_url,name)
    # 从详情页中解析出视频的地址(url)
    id = re.findall(r'\d+', detail_url)[0]
#     https://pearvideo.com/videoStatus.jsp?contId=1751458&mrd=0.32392817067398805
    detail_vedio_url = 'https://pearvideo.com/videoStatus.jsp?contId='+id

    header1s = {
        'User-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:80.0) Gecko/20100101 Firefox/80.0',
        'Content-type': 'application/json',
        'referer':detail_url
    }
    vedio_text = requests.get(url=detail_vedio_url,headers=header1s).json()
    # print(vedio_text)
    vedio_url = vedio_text['videoInfo']['videos']['srcUrl']
    dic = {
        'name': name,
        'url': vedio_url
    }
    urls.append(dic)
    print(vedio_url)
def get_video_data(dic):
    url = dic['url']
    print(dic['name'],'正在下载......')
    data = requests.get(url=url,headers=header1s).content
#   持久化存储操作
    with open(dic['name'],'wb') as fp:
        fp.write(data)
        print(dic['name'],'下载成功')
# 使用线程池对视频数据进行请求(较为耗时的阻塞操作)
pool = Pool(4)
pool.map(get_video_data,urls)

pool.close()
pool.join()
以上就是关于Python多线程爬虫的核心内容。如需了解更多相关技巧,建议查阅本站往期文章或继续浏览后续内容。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















